


python必背源代码生成器yield斐波那契代码
深入解析Python必背经典源码:利用生成器与yield关键字实现斐波那契数列的代码结构、执行流程、内存优化机制及工程化调用技巧。
在 Python 面试和工程实践中,使用 yield 关键字实现斐波那契数列是掌握生成器(Generator)、迭代协议以及惰性求值(Lazy Evaluation)的标杆代码。这段经典实现仅需五行核心逻辑,却能在 $O(1)$ 的恒定内存开销下生成无限增长的数值序列。本文将提供标准的必背源码,逐行解析其执行流转,并通过对比传统算法与提供生产级截取范式,帮助读者彻底掌握这一核心知识点。
一、经典必背源码:五行代码的标准实现
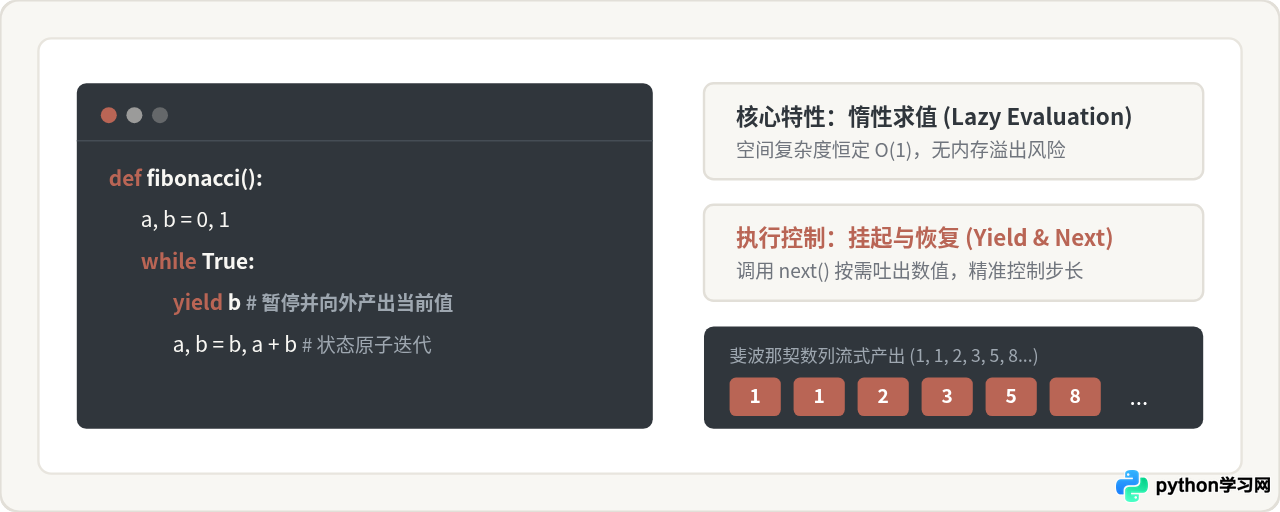
实现斐波那契生成器的核心思想是维护当前项与下一项的数值,在每一次循环中使用 yield 将当前项对外产出,随后暂停函数运行,等待下一次取值请求。以下是必须熟练背诵并默写的标准代码:
def fibonacci():
    """生成无限斐波那契数列的标准生成器"""
    a, b = 0, 1
    while True:
        yield b
        a, b = b, a + b
如果业务场景需要限制最大输出数量,可以在生成器函数中引入计数器参数:
def fib_generator(max_count=None):
    """带数量上限约束的斐波那契生成器"""
    a, b = 0, 1
    count = 0
    while max_count is None or count < max_count:
        yield b
        a, b = b, a + b
        count += 1
对这段源码的各行语法要素,需要理解以下三个关键细节:
- 函数形态转变:函数体内一旦包含
yield语句,Python 解释器在编译字节码时便会将其标识为生成器函数(Generator Function)。直接调用fibonacci()并不会执行内部的赋值与循环,而是立即返回一个未启动的生成器对象。 - 基底初始化
a, b = 0, 1:斐波那契数列的标准数学定义为 $F(1)=1, F(2)=1, F(3)=2, F(4)=3 \dots$。将a初始化为 0、b初始化为 1,在第一轮循环执行yield b时产出的正是数列首项 1。 - 原子并行赋值
a, b = b, a + b:这是 Python 极具特色的元组解包语法。右侧表达式(b, a + b)会在内存中首先完成求值并构建临时元组,随后同时解包赋给左侧的a和b。这种赋值方式保证了a + b中的a仍然是当轮迭代的旧值,无须引入第三方临时变量temp。
二、机制对比:传统列表与 yield 生成器的本质差异
很多初学者会疑惑,为什么必须使用 yield 生成器,而不是直接构造包含斐波那契数的 Python 列表?关键差异在于计算时机与内存占用模式。
传统的列表收集方式属于急切求值(Eager Evaluation)。程序必须在内存中开辟连续的堆空间,按顺序将每个数值放入列表,待全部计算完毕后才将结果统一返回。当需要计算前 1000 万个斐波那契数时,列表需要分配数 GB 内存;而当需要表示无限流时,列表更是直接导致程序死锁并抛出 MemoryError。
基于 yield 的生成器则属于惰性求值(Lazy Evaluation)。它遵循“按需生产”的原则:外部调用者何时请求下一个数,生成器才计算并返回一个数。产出后,生成器立即冻结执行现场。不论数列延伸到第 10 项还是第 10 亿项,内存中始终只保存 a 与 b 两个整型对象,空间复杂度稳定在 $O(1)$。
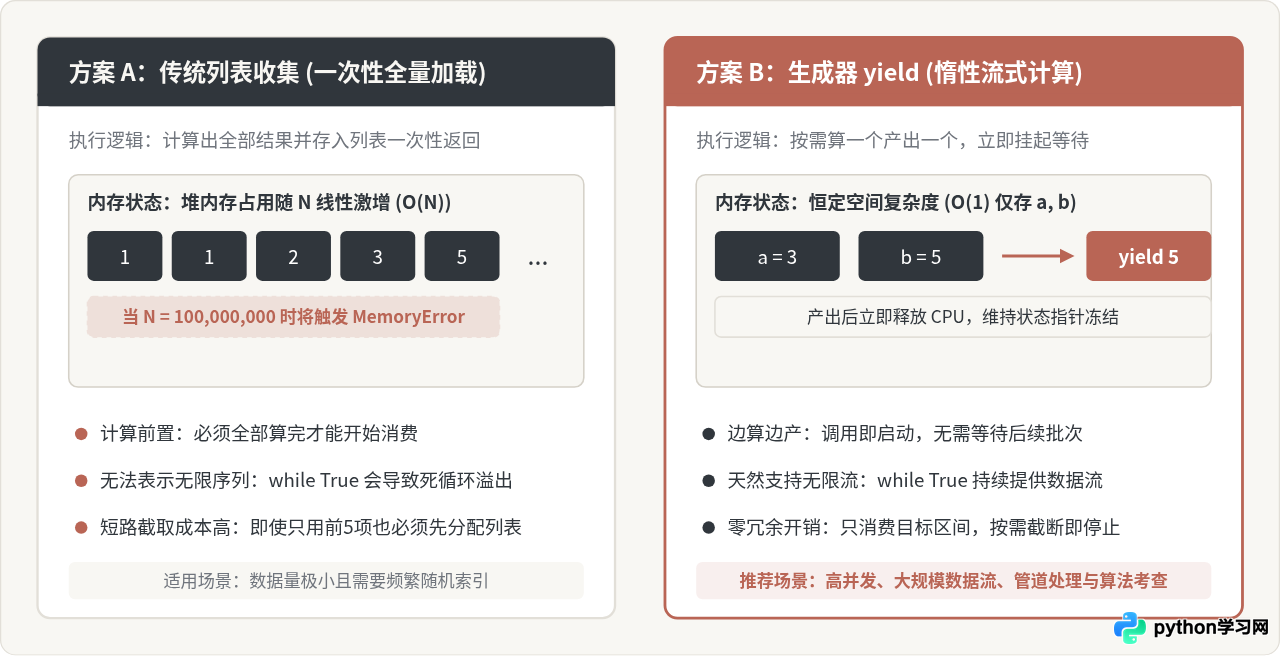
从图 1 可以看出,生成器将计算成本与空间成本平摊到了每一次调用中,真正做到了“消费多少,计算多少”。
三、执行推导:yield 挂起与恢复的底层生命周期
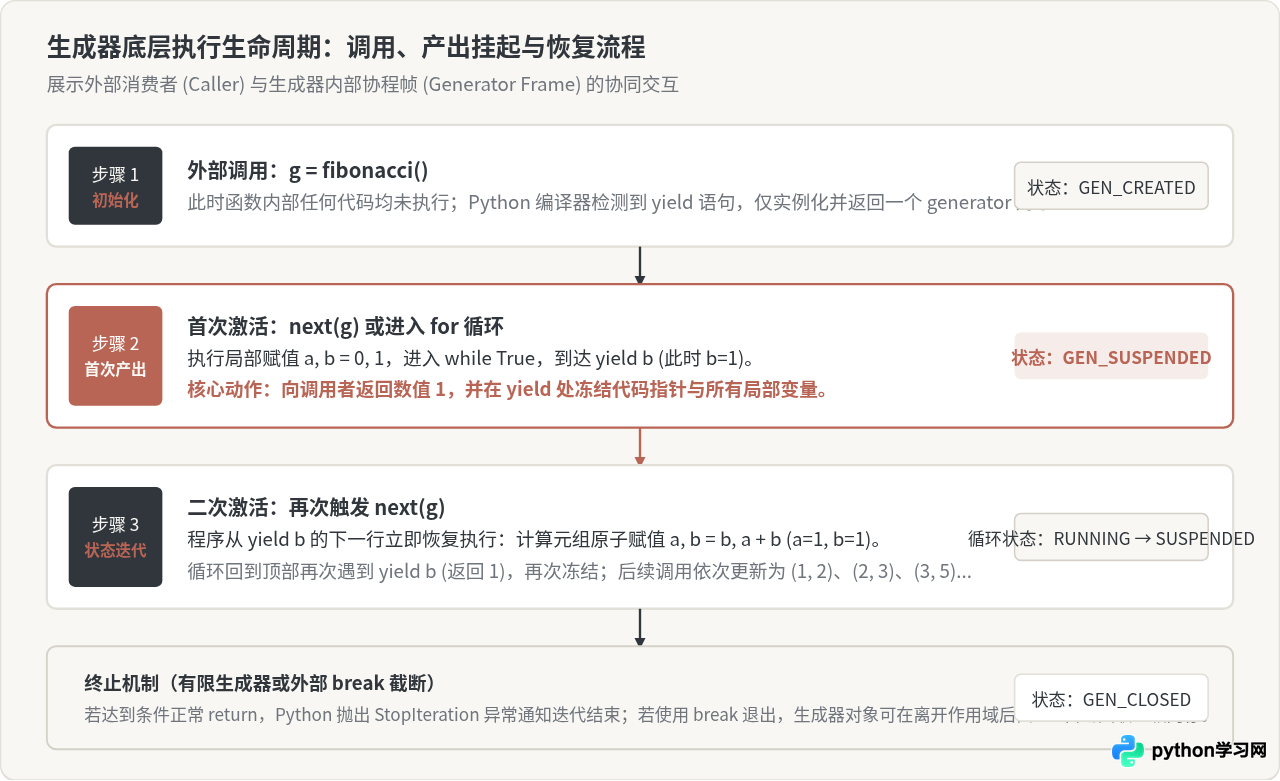
要真正吃透这段代码,必须准确把握 Python 虚拟机(PVM)在执行 yield 时的底层堆栈行为。可以将生成器视为一个轻量级的协程状态机,其执行经历四个阶段:
- 实例化阶段:执行
g = fibonacci()。解释器创建并返回一个生成器对象(状态为GEN_CREATED),此时函数内部第一行代码尚未开始执行。 - 初次激活与挂起:外部首次调用
next(g)或进入for循环。程序进入函数体,执行a, b = 0, 1,进入while True,在yield b处停止。此时b(数值 1)被传递给外部调用者,函数的执行帧(Frame Object)在堆内存中被冻结(状态为GEN_SUSPENDED),当前指令指针和局部变量完整保留。 - 恢复执行与状态递推:外部再次调用
next(g)。解释器在冻结处精准唤醒该执行帧,直接从yield b的下一行继续执行,运行a, b = b, a + b,使(a, b)更新为(1, 1)。随后循环再次回到顶部,执行yield b产出第二个 1,再次挂起。 - 后续迭代:每次触发
next(g),局部变量依次变为(1, 2)、(2, 3)、(3, 5)、(5, 8),源源不断地按需向外产出正确的斐波那契项。
四、工程范式:如何安全高效地消费生成器
因为标准 fibonacci() 是基于 while True 运行的无限生成器,在实际开发中绝不能直接使用无终止条件的遍历。以下是四种工程中最常用的消费与截取范式:
1. 使用 for 循环配合阈值截断
在循环体中加入业务判定条件,当数值超过阈值时触发 break 终止遍历:
# 示例代码:获取小于 100 的所有斐波那契数
def demo_break():
    results = []
    for num in fibonacci():
        if num >= 100:
            break
        results.append(num)
    return results

print("小于100的斐波那契数:", demo_break())2. 使用 itertools.islice 进行惰性切片(生产首选)
生成器本身不支持类似 g[0:10] 的下标切片操作,否则会抛出 TypeError。标准库 itertools.islice 是截取生成器前 N 项或指定区间最推荐的高性能方案:
from itertools import islice

# 示例代码:精准获取数列前 10 项
first_10 = list(islice(fibonacci(), 10))
print("前10项:", first_10)

# 示例代码:获取第 15 到第 20 项(下标 14 至 19)
slice_15_to_20 = list(islice(fibonacci(), 14, 20))
print("第15至20项:", slice_15_to_20)第15至20项: [610, 987, 1597, 2584, 4181, 6765]
3. 使用 next() 结合默认值实现按需单步获取
在事件驱动或状态机任务中,可以手动调用 next()。推荐传入默认值防止在有限生成器终止时意外抛出 StopIteration:
gen = fibonacci()
item1 = next(gen)
item2 = next(gen)
item3 = next(gen)
print(f"依次产出: {item1}, {item2}, {item3}")4. 组装流式处理管道(Pipeline)
生成器可以与其他生成器表达式链式串联,实现流式过滤而不在中间步骤产生任何全量列表:
# 仅筛选偶数斐波那契数,并截取前 5 个偶数
even_fibs = (x for x in fibonacci() if x % 2 == 0)
first_5_evens = list(islice(even_fibs, 5))
print("前5个偶数斐波那契数:", first_5_evens)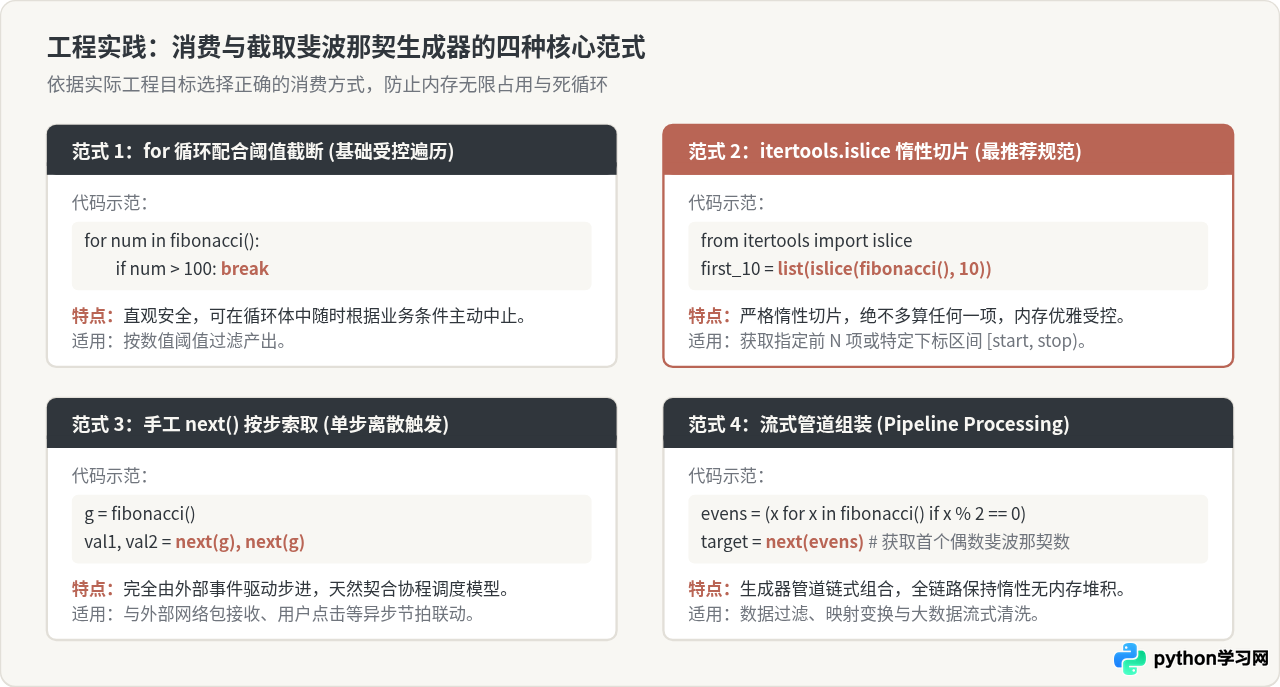
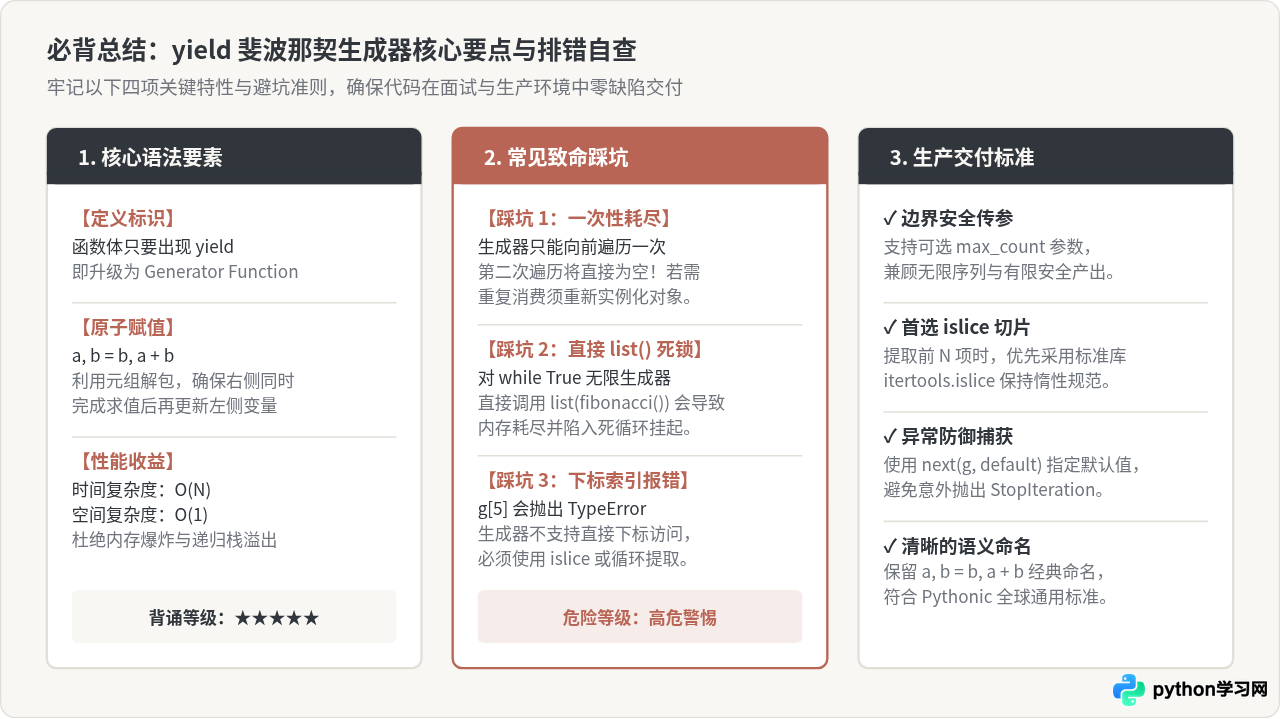
五、常见陷阱与避坑指南
在编写与调用 yield 生成器时,有三个极易出现的编码误区需要引起重视:
执行 list(fibonacci()) 会强制 Python 耗尽生成器。但由于内部是 while True,程序将陷入死循环,CPU 占用率飙升,并在数秒内因内存耗尽而崩溃。对无限生成器,必须通过 islice 或 break 施加严格的上界约束。
生成器是不可逆的单向流。一旦某个生成器实例被迭代完毕或推进到某个位置,它无法“回退”到起始点。若再次对其执行 for 循环,将直接得到空结果。若需要重新遍历,必须重新调用函数创建全新的生成器对象。
初学者容易将 a, b = b, a + b 错误地拆解为:
# 错误写法:此时 a 的值已被覆写,导致后续计算完全失真
a = b
b = a + b
这种写法先改变了 a 的值,导致计算 b = a + b 时使用的是已更新的 a,数列将演变为错误的倍增序列。必须使用单行元组赋值,或者显式使用中间变量 temp 暂存旧值。
六、总结
基于 yield 的斐波那契数列代码之所以被公认为 Python 必背经典源码,是因为它用极其精炼的五行结构,完美呈现了 Python 迭代器协议、惰性求值、原子元组解包和状态保持机制。掌握这段代码不仅能解决具体的数列计算问题,更为后续深入理解生成器管道、异步编程(async/await)以及大数据流式处理打下了坚实的技术根基。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















