


Python NumPy常用统计函数详解:均值、方差与标准差
详细讲解 Python NumPy 中均值(mean)、方差(var)与标准差(std)的计算原理、核心参数 axis 与 ddof 的实际用法,以及高维数组统计计算与数据清洗注意事项。
在数据分析与科学计算中,均值(Mean)、方差(Variance)与标准差(Standard Deviation)是最基础也是使用最频繁的描述性统计指标。NumPy 提供了高性能的内置函数 np.mean()、np.var() 和 np.std(),能够以向量化方式秒级处理多维数组数据。本文将系统拆解这三个核心函数的数学原理、代码实现,并重点剖析多维计算中至关重要的维度参数 axis 与统计学自由度参数 ddof 的正确用法。
指标定义与三者之间的内在关系
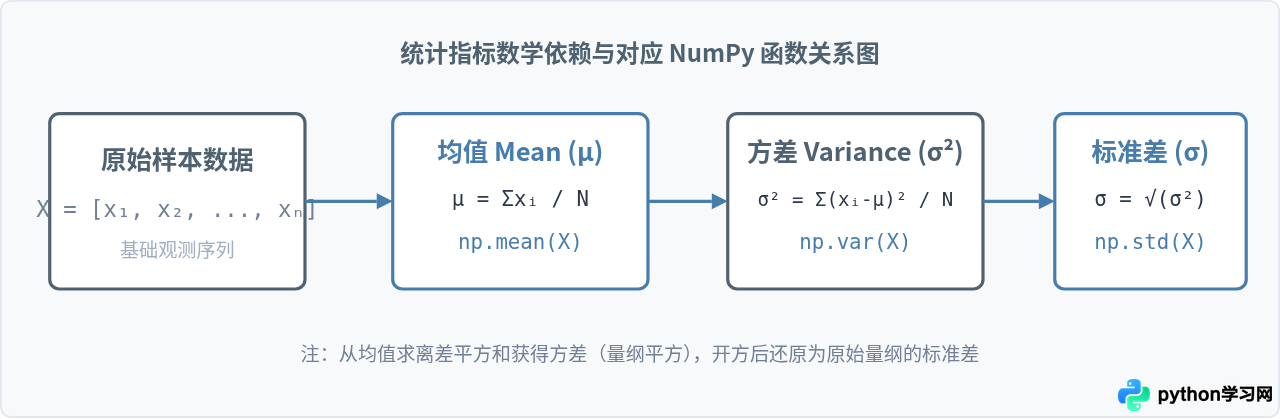
理解这三项指标的逻辑关联,是写出正确代码的前提。均值衡量的是数据的“中心位置”;方差衡量的是各个样本点与均值之间偏离程度的平方平均值;而标准差则是方差的算术平方根,其量纲与原始数据保持完全一致,因而更直观。
核心统计函数的快速上手与基础调用
在 Python 中使用 NumPy 计算一维数据的均值、方差和标准差非常直观。我们构建一个包含简单整数的数组来观察输出结果:
import numpy as np

# 构建一组测试数据
data = np.array([10, 20, 30, 40, 50])

# 1. 计算均值
mean_val = np.mean(data)

# 2. 计算方差
var_val = np.var(data)

# 3. 计算标准差
std_val = np.std(data)

print("均值 (Mean):", mean_val)
print("方差 (Variance):", var_val)
print("标准差 (Std):", std_val)
示例输出:
均值 (Mean): 30.0
方差 (Variance): 200.0
标准差 (Std): 14.142135623730951
代码中的计算过程与数学定义吻合:各项与均值 30 的离差分别为 -20, -10, 0, 10, 20,离差平方和为 400 + 100 + 0 + 100 + 400 = 1000,除以样本数量 5 得到总体方差 200.0,开根号得到标准差约 14.14。
关键参数之一:axis 沿轴统计的计算机制
在二维及更高维度的矩阵运算中,若不指定 axis 参数,NumPy 会默认将矩阵展平(flatten)为一维向量,并返回全局单一统计值。如果需要按行或按列分别统计,就必须明确指定 axis:
axis=None(默认):所有元素参与计算,返回标量。axis=0:沿第 0 轴(纵向跨行压缩)进行聚合,计算每一列的统计值。axis=1:沿第 1 轴(横向跨列压缩)进行聚合,计算每一行的统计值。
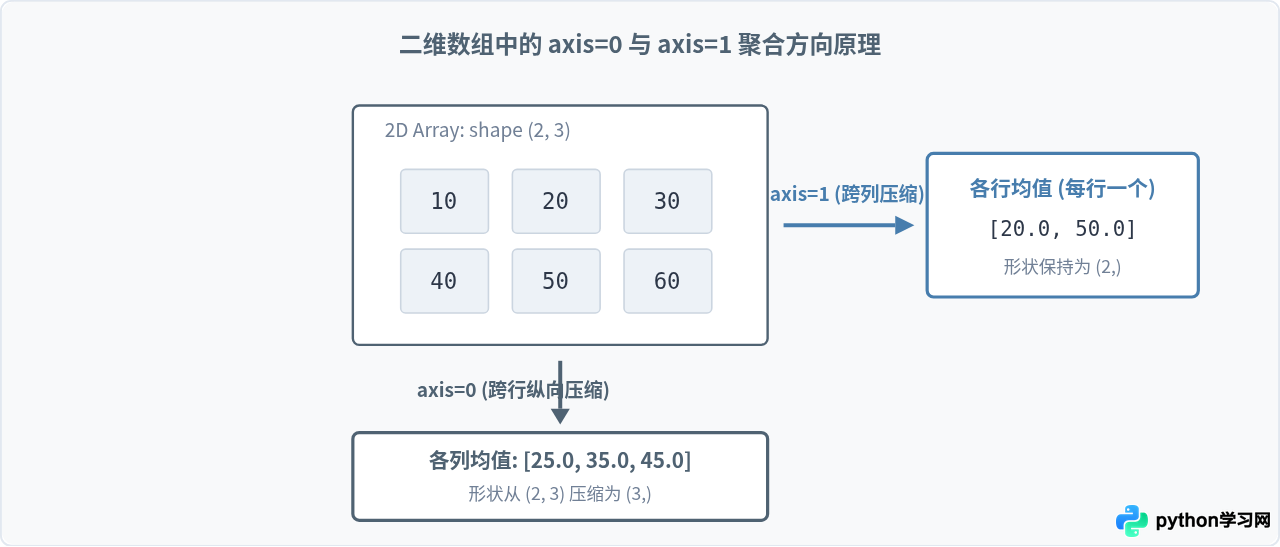
下面通过具体代码演示二维矩阵中不同 axis 参数的具体行为:
matrix = np.array([
    [10, 20, 30],
    [40, 50, 60]
])

# 默认全局计算
print("全局均值:", np.mean(matrix))

# 沿轴 0 计算(按列取均值)
col_mean = np.mean(matrix, axis=0)
print("每列均值 (axis=0):", col_mean)

# 沿轴 1 计算(按行取均值)
row_mean = np.mean(matrix, axis=1)
print("每行均值 (axis=1):", row_mean)
示例输出:
全局均值: 35.0
每列均值 (axis=0): [25. 35. 45.]
每行均值 (axis=1): [20. 50.]
关键参数之二:ddof 与样本统计无偏估计
在方差与标准差计算中,ddof(Delta Degrees of Freedom,自由度偏移量)是一个极易被忽视但至关重要的参数。数学上的除数是 N - ddof:
- 总体方差与总体标准差(默认设置):
ddof=0,除数为N。NumPy 默认假设传入的数据即为全部总体数据。 - 样本方差与样本标准差(无偏估计):
ddof=1,除数为N - 1(贝塞尔校正 Bessel's correction)。在实际统计学中,当数据是从总体中抽样取得时,必须使用ddof=1才能获得无偏方差。
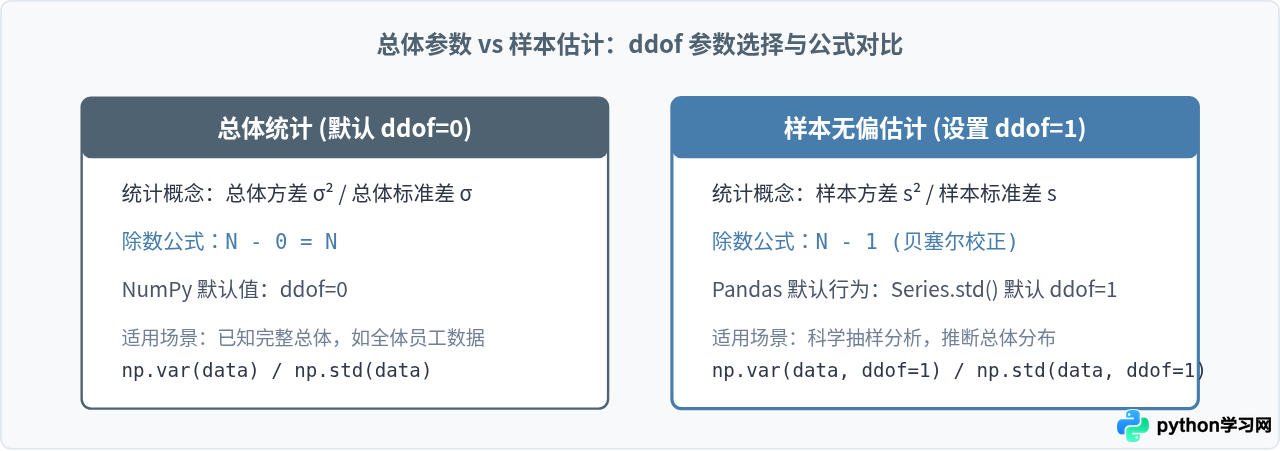
注意对比 Pandas 与 NumPy:NumPy 的 np.std() 默认 ddof=0,而 Pandas 中 df['col'].std() 默认 ddof=1。若混合使用两个库进行对账核验,务必显式指定 ddof 参数,避免产生计算差异。
samples = np.array([4.0, 5.0, 6.0, 7.0, 8.0])

# 总体方差 (N = 5)
pop_var = np.var(samples, ddof=0)

# 样本方差 (N - 1 = 4)
sample_var = np.var(samples, ddof=1)

print("总体方差 (ddof=0):", pop_var)
print("样本方差 (ddof=1):", sample_var)
print("总体标准差 (ddof=0):", np.std(samples, ddof=0))
print("样本标准差 (ddof=1):", np.std(samples, ddof=1))
示例输出:
总体方差 (ddof=0): 2.0
样本方差 (ddof=1): 2.5
总体标准差 (ddof=0): 1.4142135623730951
样本标准差 (ddof=1): 1.5811388300841898
综合实战步骤与缺失值安全排查
在实际工程场景中,处理真实数据时通常需要遵循一套严谨的推导与排查流水线:包含数据校验、缺失值排除、统计量计算以及广播归一化操作。当数据中包含 NaN(缺失值)时,标准函数 np.mean 会直接传播并返回 nan,此时应切换为安全函数 np.nanmean、np.nanvar 和 np.nanstd。
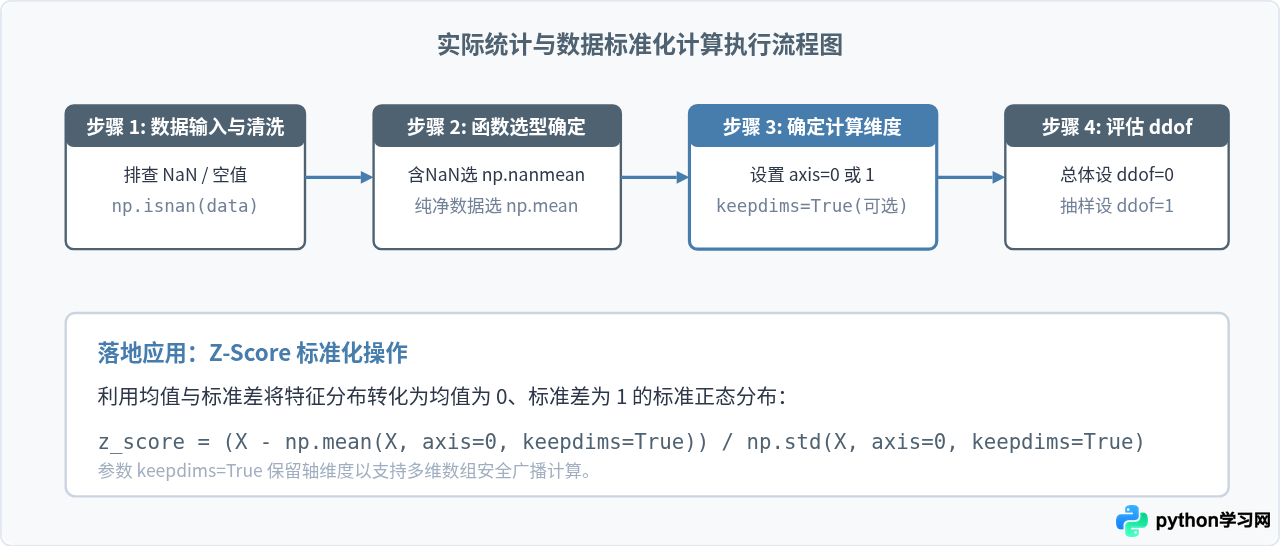
以下代码演示在含有缺失值的数据集中安全计算均值与标准差,并实施 Z-Score 标准化:
import numpy as np

# 含有缺失值的数据矩阵
raw_data = np.array([
    [10.0, np.nan, 30.0],
    [40.0, 50.0, 60.0],
    [70.0, 80.0, 90.0]
])

# 1. 忽略缺失值计算列均值
safe_mean = np.nanmean(raw_data, axis=0)

# 2. 忽略缺失值计算样本标准差
safe_std = np.nanstd(raw_data, axis=0, ddof=1)

print("安全列均值 (nanmean):", safe_mean)
print("安全样本列标准差 (nanstd):", safe_std)

# 3. 标准化示例 (以无缺失值的完整子集为例)
clean_data = np.array([
    [10.0, 20.0, 30.0],
    [40.0, 50.0, 60.0],
    [70.0, 80.0, 90.0]
])

mu = np.mean(clean_data, axis=0, keepdims=True)
sigma = np.std(clean_data, axis=0, keepdims=True)

# 广播计算标准化数值
standardized = (clean_data - mu) / sigma
print("标准化后各列均值:", np.mean(standardized, axis=0))
print("标准化后各列标准差:", np.std(standardized, axis=0))
示例输出:
安全列均值 (nanmean): [40. 65. 60.]
安全样本列标准差 (nanstd): [30.         21.21320344 30.        ]
标准化后各列均值: [0. 0. 0.]
标准化后各列标准差: [1. 1. 1.]
核心要点总结
- 函数对应关系:均值使用
np.mean(),方差使用np.var(),标准差使用np.std()。 - 轴向规则:二维矩阵中
axis=0跨行统计各列指标,axis=1跨列统计各行指标。 - 无偏估计选择:总体统计直接采用默认
ddof=0;抽样数据推断总体需显式声明ddof=1。 - 容错与广播:遇
NaN优先使用nanmean、nanvar、nanstd;多维矩阵后续进行减除运算时,配合keepdims=True可直接利用广播机制。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















