


pythonoperator模块函数式编程怎么用
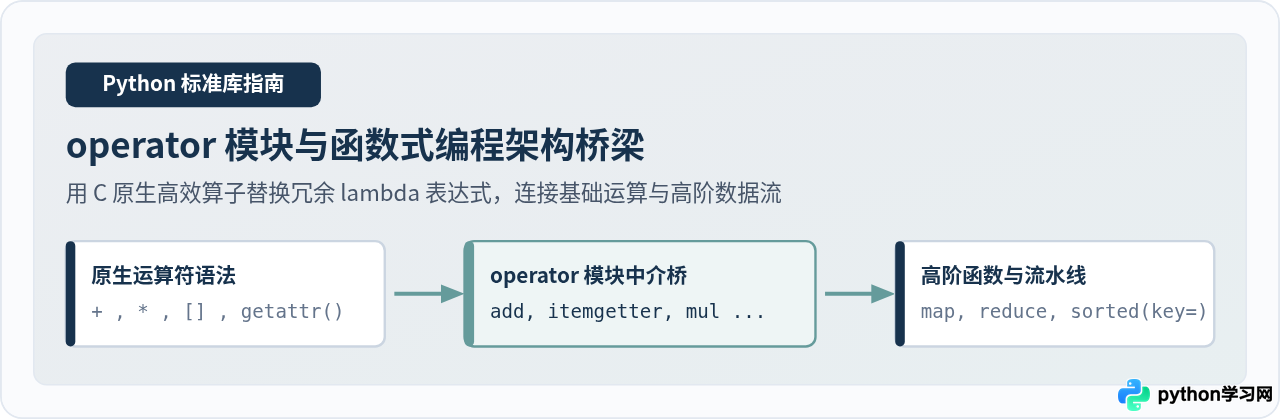
深入解析 Python operator 模块在函数式编程中的实用方法。通过算术运算、容器提取器(itemgetter)、对象属性提取器(attrgetter)以及方法调用器(methodcaller),全面替代冗余的 lambda 表达式,提升代码执行效率与可读性。
operator 模块将所有基础语法运算符(例如四则运算、成员判断、字段索引与属性检索)封装为标准可调用函数。在函数式编程场景下,诸如 map()、filter()、functools.reduce() 以及 sorted() 等高阶工具高度依赖传入函数。使用 operator 模块中的函数替代临时的 lambda 表达式,能彻底规避多余的 Python 栈帧开销,获得底层 C 原生代码的执行性能,并消除样板代码,让数据流处理更为紧凑、纯粹。
一、operator 模块的核心功能与分类体系
在 Python 中,绝大多数运算符(如 +、*、in、[]、.)本质上都有对应的特殊方法(dunder methods,如 __add__、__getitem__)。但语言层面的语法符号无法直接作为参数传递给高阶函数。很多人习惯写 lambda a, b: a + b,而 operator 模块直接将这些操作以优化编译的 C 函数形式暴露出来。
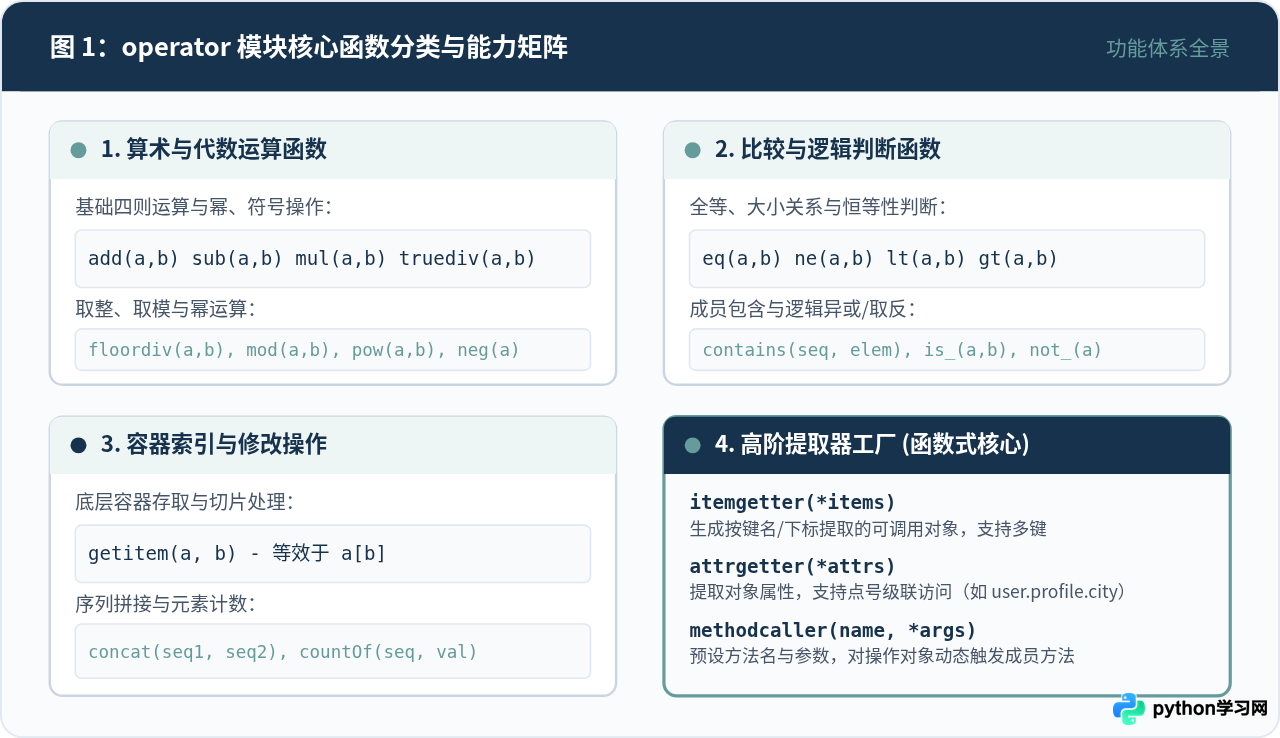
整个 operator 模块可以归纳为四大职能分类,它们覆盖了函数式编程所需的基本原子操作:
- 算术与代数运算函数:涵盖
add、sub、mul、truediv、floordiv、mod、pow、neg等。用于序列规约、累乘、累加与数学计算。 - 比较与逻辑关系函数:包括
eq、ne、lt、gt、contains、is_、not_等。常用于数据过滤、存在性断言和边界约束判断。 - 容器索引与序列处理函数:包括
getitem、setitem、delitem、concat、countOf等。可直接将序列切片与字典存取转化为函数调用。 - 高阶提取工厂(核心):包括
itemgetter、attrgetter和methodcaller。这三个函数属于函数工厂,调用它们会返回一个专门用于提取指定数据或调用指定方法的函数对象。
二、为什么函数式编程推荐 operator 而非 lambda
许多初学者会疑惑:既然写一个 lambda x: x['age'] 只有几个字符,为什么标准库还特意推荐使用 itemgetter('age')?这背后主要有两个决定性因素:执行性能与意图表达。
1. 底层执行机制与栈帧消耗
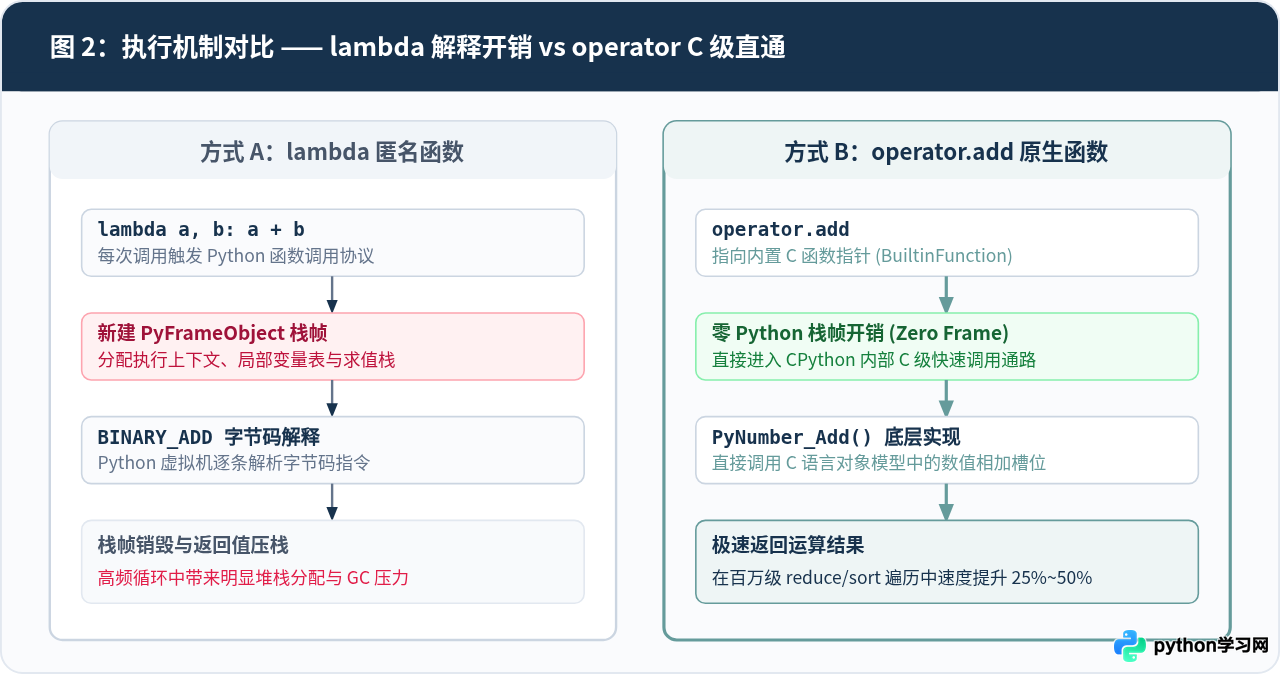
每当你定义一个 lambda 表达式并在高阶函数中对其循环调用时,CPython 虚拟机必须为每次调用动态创建并压入一个全新的 Python 执行栈帧(PyFrameObject),随后在虚拟机主循环(ceval)中解释执行字节码(如 LOAD_FAST、BINARY_OP),最后弹出并销毁栈帧。
相反,operator 模块中的绝大多数算子由底层 C 扩展模块 _operator.c 直接实现。高阶函数传入 operator.add 时,调用的是底层的内置 C 函数指针(PyCFunction),直接分发至数值操作槽(如 PyNumber_Add),完全绕过了 Python 字节码层面的栈帧开销。在大数据量集合遍历与密集运算中,运行耗时往往能缩减 20% 到 50%。
2. 声明式语义与代码整洁度
函数式编程强调“声明做什么,而非描述怎么做”。比较以下两段多字段排序代码:
# 使用 lambda:需引入临时参数变量,视觉噪声多
records.sort(key=lambda r: (r["department"], r["performance_score"]))

# 使用 operator:声明式提取关键维度,意图一目了然
from operator import itemgetter
records.sort(key=itemgetter("department", "performance_score"))
使用 itemgetter 可以直接指定需要提取的字段名称或索引序列,避免了给无意义的临时变量(如 x 或 r)命名,代码整洁且意图明确。
三、实战操作步骤:数据提取与流水线处理
为了让读者在实际工程中熟练运用,我们将以一个典型的结构化数据集(企业员工绩效列表)为例,分步演示如何将 operator 模块与排序、分组及累加流水线无缝集成。
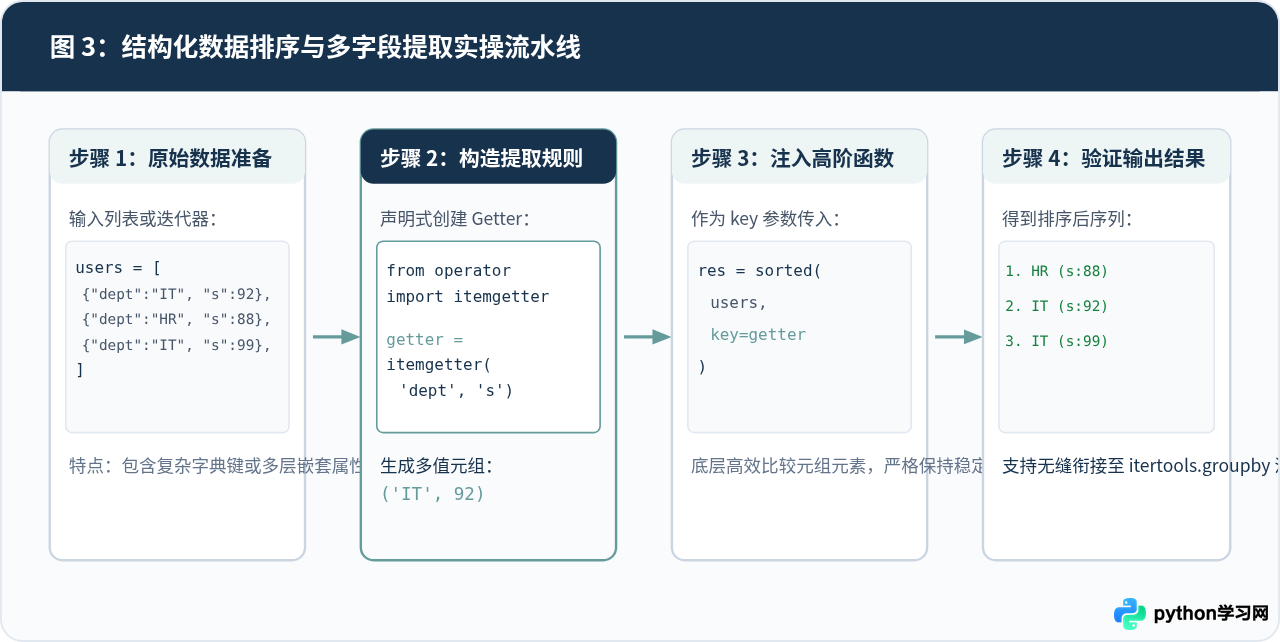
步骤 1:准备结构化数据源
假设我们有一组原始员工数据,包含所属部门、姓名和年度绩效分:
employees = [
    {"dept": "研发部", "name": "张伟", "score": 88, "tags": " python,backend "},
    {"dept": "市场部", "name": "李强", "score": 92, "tags": " marketing,growth "},
    {"dept": "研发部", "name": "王芳", "score": 95, "tags": " devops,docker "},
    {"dept": "财务部", "name": "赵敏", "score": 88, "tags": " finance,audit "},
    {"dept": "研发部", "name": "刘洋", "score": 82, "tags": " frontend,react "},
]
步骤 2:利用 itemgetter 构建复合排序提取器
若我们希望对员工列表进行复合排序:优先按“部门”(字母或拼音升序),部门相同则按“绩效成绩”(降序)。我们首先使用 operator.itemgetter 创建提取规则:
from operator import itemgetter

# 创建单键提取器
get_score = itemgetter("score")

# 创建复合键提取器:同时提取部门与成绩
get_dept_score = itemgetter("dept", "score")
当 itemgetter 传入多个参数时,它生成的函数在接收目标字典时,会自动返回一个元组。例如 get_dept_score(employees[0]) 会返回 ("研发部", 88)。Python 原生支持元组逐位对比,因而极其适合作为排序的 key。
步骤 3:注入高阶函数管道执行排序与分组
我们将 get_dept_score 直接注入内置的 sorted() 函数中:
from operator import itemgetter
from itertools import groupby

# 执行多维度排序
sorted_staff = sorted(employees, key=itemgetter("dept", "score"), reverse=False)

# 打印排序结果示例
for emp in sorted_staff:
print(f"[{emp['dept']}] {emp['name']}: {emp['score']} 分")[研发部] 刘洋: 82 分
[研发部] 张伟: 88 分
[研发部] 王芳: 95 分
[财务部] 赵敏: 88 分
四、常见函数式场景的经典用法示例
1. 序列折叠与累加运算(结合 functools.reduce)
在函数式编程中,序列聚合常用 reduce。使用 operator.add 与 operator.mul 可以避免编写繁琐的加法与乘法 lambda:
from functools import reduce
from operator import add, mul

numbers = [1, 2, 3, 4, 5]

# 替代 reduce(lambda a, b: a + b, numbers)
total_sum = reduce(add, numbers)

# 计算阶乘或累乘:替代 reduce(lambda a, b: a * b, numbers)
product = reduce(mul, numbers)

print(f"求和结果: {total_sum}, 累乘结果: {product}")2. 对象链式属性提取(结合 attrgetter)
对于面向对象的复杂业务实体,数据往往封装在类实例中,甚至有多层嵌套(如 order.customer.address.city)。attrgetter 深度支持点号分割的链式路径解析:
from operator import attrgetter

class Address:
    def __init__(self, city):
        self.city = city

class User:
    def __init__(self, username, address):
        self.username = username
        self.address = address

user_list = [
    User("Alice", Address("Beijing")),
    User("Bob", Address("Shanghai")),
    User("Charlie", Address("Guangzhou"))
]

# 提取深度嵌套属性:user.address.city
get_city = attrgetter("address.city")

# 批量提取所有用户的所在城市
cities = list(map(get_city, user_list))
print("提取到的城市列表:", cities)3. 批量调用对象实例方法(结合 methodcaller)
methodcaller 用于对一组对象批量触发特定的成员方法,同时支持向方法传递实参。例如在文本清洗中批量去除首尾空格:
from operator import methodcaller

raw_tags = ["  python ", " django\n", "  fastapi  ", "celery "]

# 等效于 lambda s: s.strip()
clean_tags = list(map(methodcaller("strip"), raw_tags))
print("清洗后的标签:", clean_tags)

# 传入额外参数:等效于 lambda s: s.replace("-", "_")
slugs = ["user-id", "order-sn", "pay-type"]
normalized_slugs = list(map(methodcaller("replace", "-", "_"), slugs))
print("规范化标识符:", normalized_slugs)规范化标识符: ['user_id', 'order_sn', 'pay_type']
五、注意事项与高频避坑指南
itemgetter 底层调用的是目标对象的 __getitem__ 协议,当字典中缺少指定键时,会立即抛出标准的 KeyError,它并不具备字典 dict.get(key, default) 的安全兜底能力。如果你的数据存在字段缺失,建议在送入提取器前通过清洗流水线补全默认值。
在日常使用中,还需特别注意以下三点约束:
- 返回值维度差异:当给
itemgetter('a')传入单个键时,提取器返回的是对应的值对象;而当传入两个及以上参数如itemgetter('a', 'b')时,返回的是包含提取结果的元组。不要在解构时混淆这两种形式。 - 避免反人类的复杂算子链:虽然
operator提供了丰富的功能,但当业务逻辑需要多重条件判断(如if-else)或复杂的中间变量转换时,切忌为了刻意追求“函数式”而强行组合各类算子。此时编写一个明确的具名函数(def calculate(...))无论从可读性还是维护性上都远优于晦涩的代码拼凑。 - 不变性原则与副作用控制:尽管
operator提供了setitem和delitem,但这两个函数在原地直接修改容器,带有强烈的命令式副作用。在函数式流水线中,推荐优先采用无副作用的纯函数(如构造新字典或新序列),以防并发或管道中途产生不可预测的状态变化。
六、选型决策与最佳实践总结
为了帮助开发者在实际编码中快速选择最合理的表达方式,下图梳理了函数式场景下的核心决策路径:
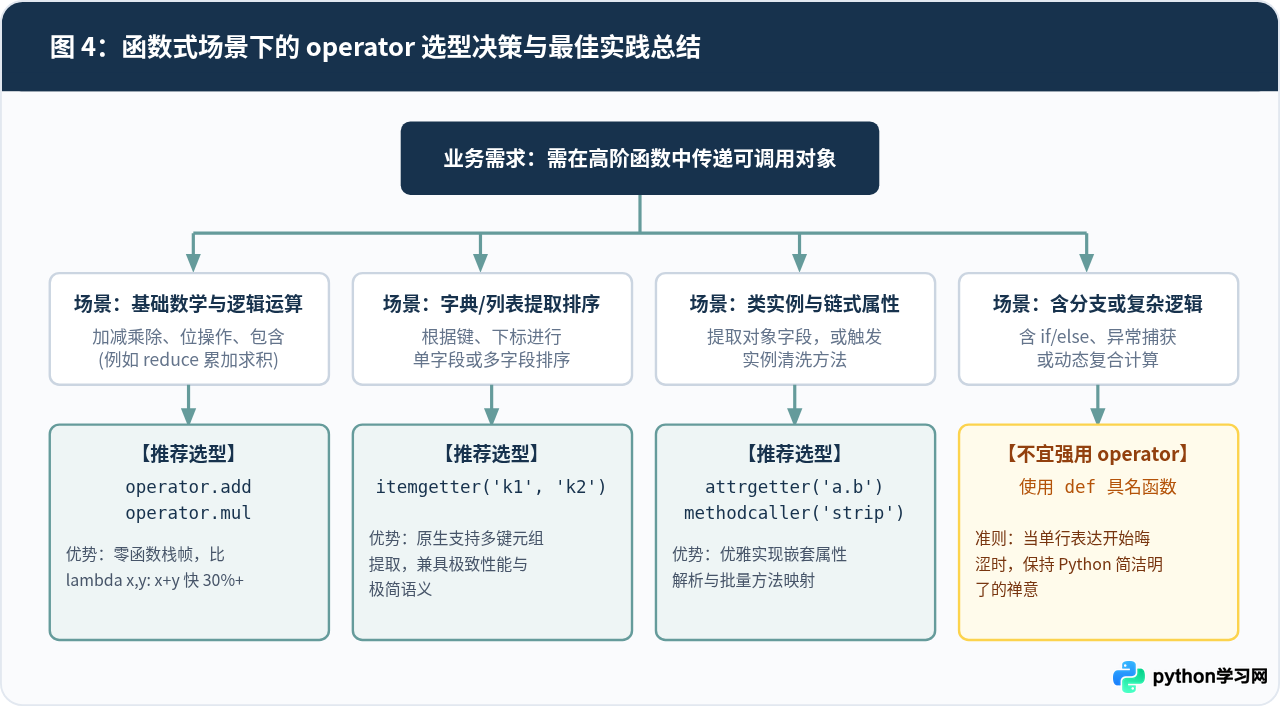
下表给出了开发中最高频的几种场景对比速查:
| 业务场景 | 传统写法 (lambda) | operator 推荐写法 | 核心收益与优势 |
|---|---|---|---|
| 数字累加 / 累乘 | reduce(lambda a, b: a + b, seq) |
reduce(operator.add, seq) |
C 级直接分发,无 Python 栈帧开销 |
| 字典单字段排序 | sorted(seq, key=lambda x: x['age']) |
sorted(seq, key=itemgetter('age')) |
执行速度更快,去除了无意义的变量命名 |
| 字典多字段复合排序 | sorted(seq, key=lambda x: (x['dept'], x['score'])) |
sorted(seq, key=itemgetter('dept', 'score')) |
原生自动打包元组,可读性极强 |
| 类实例属性提取 | map(lambda u: u.address.city, users) |
map(attrgetter('address.city'), users) |
点号级联访问深层属性,代码结构清晰 |
| 字符串批量方法调用 | map(lambda s: s.strip(), strings) |
map(methodcaller('strip'), strings) |
动态反射调用,支持灵活参数传递 |
总结而言,Python 的 operator 模块并不是颠覆式的全新语法,而是将日常运算符升华为一等公民函数的基础构件。在处理 map、reduce、filter 以及 sorted 等函数式数据流时,优先使用 operator 代替临时的 lambda,既能让代码具备更优异的高并发与批处理吞吐性能,也能让整个数据管道的语义变得干净利落。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















