


Python中\n、\r\n和os.linesep的区别与适用场景
深入解析Python中\n、\r\n以及os.linesep的底层编码机制、通用换行符转换原理、写入避坑指南与典型开发场景选型。
\n,Python内建的通用换行符机制(Universal Newlines)会自动处理不同操作系统的转换;网络协议通信与RFC标准CSV文件必须显式指定 \r\n;而 os.linesep 仅代表当前操作系统默认的换行字符串,严禁在常规文本写模式下拼接使用,否则在Windows环境下将直接引发恼人的双重换行(\r\r\n)问题。
一、底层字符与历史渊源:\n 与 \r\n 的本质
换行符的差异源于机械打字机时代的物理机械动作。要开始新的一行,打字机需要完成两项独立操作:一是将滑动字车推回行首(Carriage Return,回车),二是将滚筒卷动一行(Line Feed,换行)。进入计算机时代后,不同操作系统的设计者对这一控制逻辑做出了不同取舍:
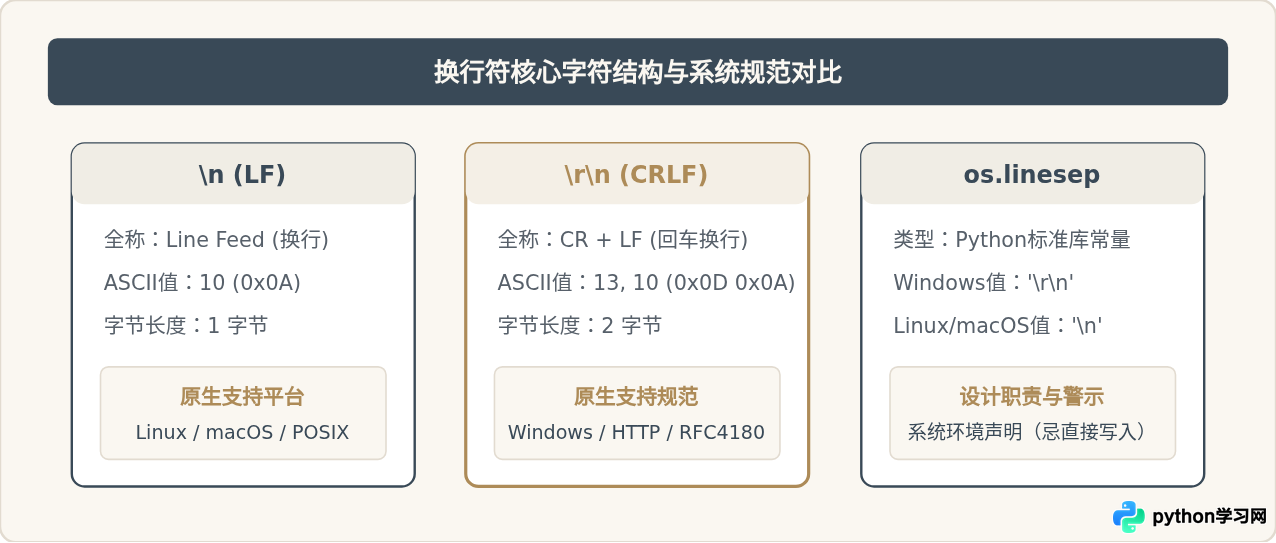
\r(CR - 回车符):ASCII码值为13(十六进制0x0D),控制光标回到当前行的起始位置,但不向下移动行。早期的经典 Mac OS(OS 9及更早版本)曾单独使用该字符表示换行。\n(LF - 换行符):ASCII码值为10(十六进制0x0A),控制光标垂直向下移动一行。Unix及其衍生系统(包括现代 Linux 与 macOS)为了节省存储和简化格式,将\n确立为标准的行分隔符。\r\n(CRLF - 回车换行组合):由0x0D 0x0A两个字节连续构成。CP/M、MS-DOS 以及后续的 Windows 操作系统继承了机械打字机的双字符标准,始终使用\r\n作为系统默认的文本断行符。此外,许多由IETF制定的基础互联网通信协议(如 HTTP、SMTP、MIME)也严格规定消息头必须以 CRLF 结尾。
二、揭开 os.linesep 的面纱:为什么不能用它写普通文件?
初学Python的开发者常误以为:“既然要写跨平台代码,那么换行就应该用 os.linesep,这样在Windows上用 \r\n,在Linux上用 \n,岂不是很完美?”这是一个极其典型且普遍的认知误区。
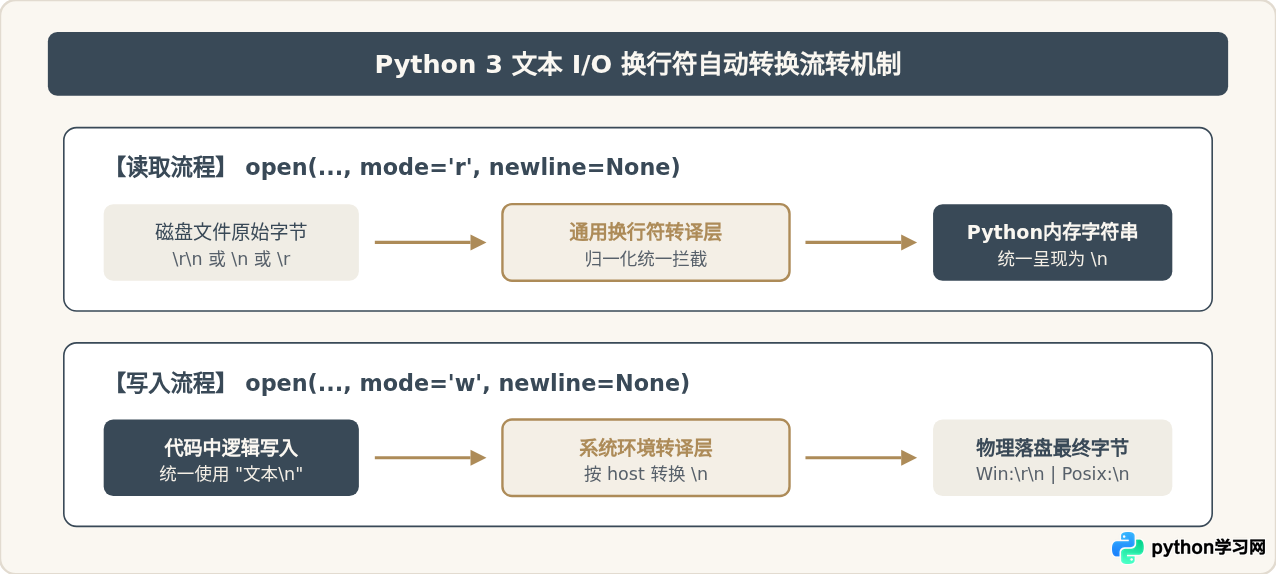
官方文档对 os.linesep 的定义非常克制:当前平台用于分隔行的字符串。然而,Python 3的文件I/O系统默认开启了通用换行符机制(Universal Newlines)。在默认的文本写入模式(mode='w' 且 newline=None)下,Python运行时会自动检测操作系统,并将写入字符串中的每一个单独的 \n 隐式替换为目标系统的默认换行符(在Windows上即为 \r\n)。
如果在Windows系统下执行 f.write(f"Hello{os.linesep}"),变量展开后的实际内容是 Hello\r\n。随后,Python内置的I/O层拦截到该字符串,并在其中的 \n 前面再次根据系统规则补充一个 \r,最终实际落盘到物理存储的字节序列变成了 Hello\r\r\n(十六进制 0x68 0x65 0x6C 0x6C 0x6F 0x0D 0x0D 0x0A)!这会导致许多文本编辑器解析出错,或者在每两行之间莫名多出一个空白行。
# 错误示例:在Windows下会产生 \r\r\n 乱码行
import os

with open("output_bug.txt", "w", encoding="utf-8") as f:
    f.write(f"第一行{os.linesep}")  # 写入时 \n 会被二次扩展为 \r\n,形成 \r\r\n

# 正确示例:统一使用 \n,让Python自身接管平台适配
with open("output_correct.txt", "w", encoding="utf-8") as f:
    f.write("第一行\n")            # Windows自动转为 \r\n,Linux保持 \n
三、Python 3 通用换行符机制(Universal Newlines)详解
为了抹平多操作系统带来的换行符裂痕,Python 3在底层 io.TextIOWrapper 中引入了健壮的通用换行符机制。通过 open() 函数的 newline 参数,开发者可以精确控制字符流的转译行为。
1. 读取模式下的转换流向(mode='r')
newline=None(默认设置):开启通用换行符转换。不论输入文件中存储的是\n、\r\n还是旧Mac风格的\r,Python在读入内存时都会统一归一化为标准的\n。通过文件对象的f.newlines属性可以查询当前文件实际包含的原始换行类型。newline=''(空字符串):保留原始字符,不进行任何转换。文件磁盘中存什么,内存中的字符串就完全一致地获得什么。newline='\n'或newline='\r\n':只按照指定的特定字符进行切行,其余换行符视作普通内容。
2. 写入模式下的转换流向(mode='w')
newline=None(默认设置):自动平台适配。内存字符串中的所有\n都会被替换为操作系统的默认行分隔符(由os.linesep决定)。newline=''或newline='\n':完全禁用自动转换。代码中传入的\n将原封不动地直接写入文件,这是构建确定性跨平台文件(如团队代码、Docker容器映射配置)最安全的方式。newline='\r\n':强制将所有的\n都转化为\r\n写入,无论脚本运行在Linux、macOS还是Windows上。
四、各场景下的精准选型决策
针对不同开发需求,换行符的选用具有清晰的边界:
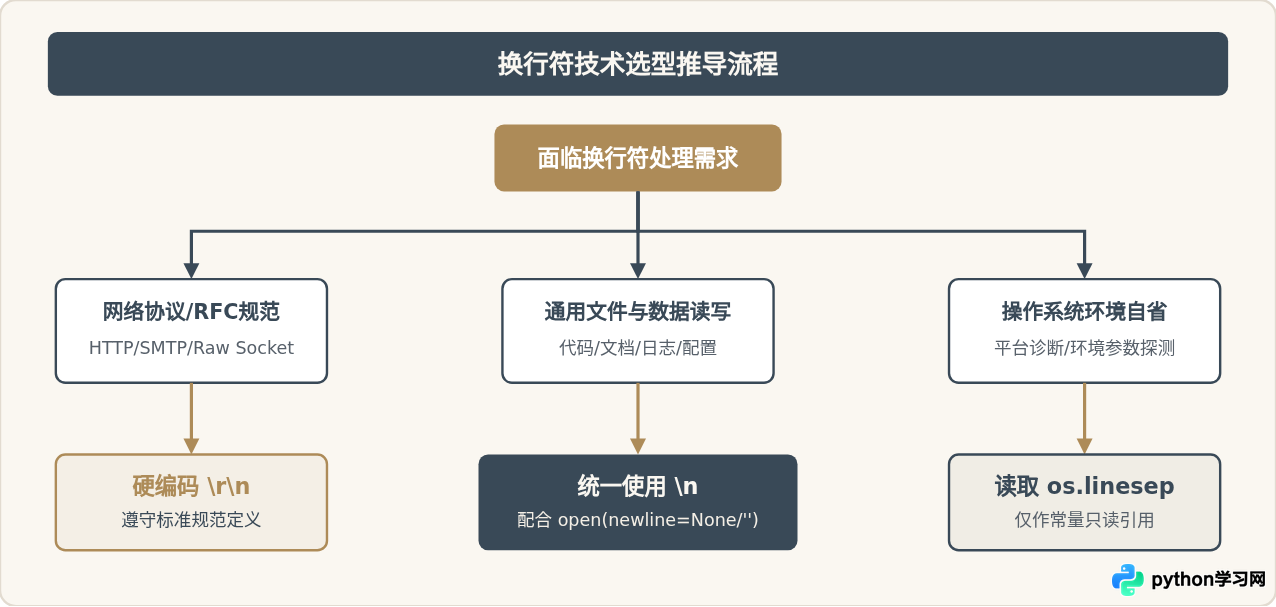
1. 常规应用文本输出:选 \n
编写日志文件、输出报告、保存配置等常规文件时,始终在代码中书写 \n。如果项目有严格跨平台要求(例如在Windows机器上生成必须在Linux容器中执行的Shell脚本),请在 open() 中显式传入 newline='\n',确保生成的每一行都是纯粹的 0x0A。
2. 网络协议与Raw Socket:必须选 \r\n
当通过 socket 库编写底层网络客户端,或者需要手动拼接 HTTP 请求报文头、MIME 邮件体、FTP/SMTP 交互指令时,RFC 规范强制要求必须以 CRLF 换行:
# 手动构造 HTTP 响应头
http_response = (
    "HTTP/1.1 200 OK\r\n"
    "Content-Type: text/plain; charset=utf-8\r\n"
    "Connection: close\r\n"
    "\r\n"
    "Hello World"
)
client_socket.sendall(http_response.encode('ascii'))
3. 标准CSV文件生成:选 newline='' + 自动 \r\n
官方 csv 模块内部依据 RFC 4180 标准自行管理行尾(默认写入 \r\n)。因此在调用 csv.writer 时,必须给 open() 传递 newline='',否则在Windows上又会触发 \r\r\n 导致每行数据之间都夹杂空行:
import csv

# 正确标准写法:newline='' 严防空行
with open("data.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["ID", "Name", "Role"])
    writer.writerow(["101", "Alice", "Admin"])
4. os.linesep 的真正适用场景
os.linesep 并非用于文件存储,它的核心价值在于读取并获取当前宿主环境的系统特征。例如:在终端打印信息提示时与本地控制台保持一致、在二进制数据流中搜索与当前平台匹配的换行标记、或者在编写系统诊断工具时上报宿主环境的换行参数。
五、跨平台协作中的典型陷阱与排查技巧
在团队协作中,由于不同成员可能分别使用 Windows、macOS 或 Linux,换行符不一致极易导致隐藏Bug:
- Linux下运行Shell脚本报错:在Windows上编写的
start.sh脚本默认带有\r\n,传到Linux服务器上执行时,Bash会将\r视作命令名的一部分,从而抛出令人费解的/bin/bash^M: bad interpreter: No such file or directory。解决方法是在保存脚本时明确强制使用\n,或在Linux端执行dos2unix start.sh清洗换行。 - Git代码版本管理的暗中置换:Git的
core.autocrlf配置可能在拉取或提交时静默篡改换行符。推荐在项目根目录维护标准的.gitattributes文件(如声明* text=auto eol=lf),从源头规避由于换行符变更引起的代码大面积全行冲突。 - 二进制与文本混淆:若需要以原样字节处理文件(如解析网络报文包或处理图片内嵌元数据),务必使用
mode='rb'或mode='wb'。二进制模式下 Python 完全不介入换行转译。
快速定位与排查文本行尾真实字节的诊断小技巧:
# 检查文本行结尾的真实可见形态
with open("test.txt", "rb") as f:
    sample_bytes = f.read(100)
    print(repr(sample_bytes))  # 如果看到 b'line1\r\n' 说明磁盘文件为 CRLF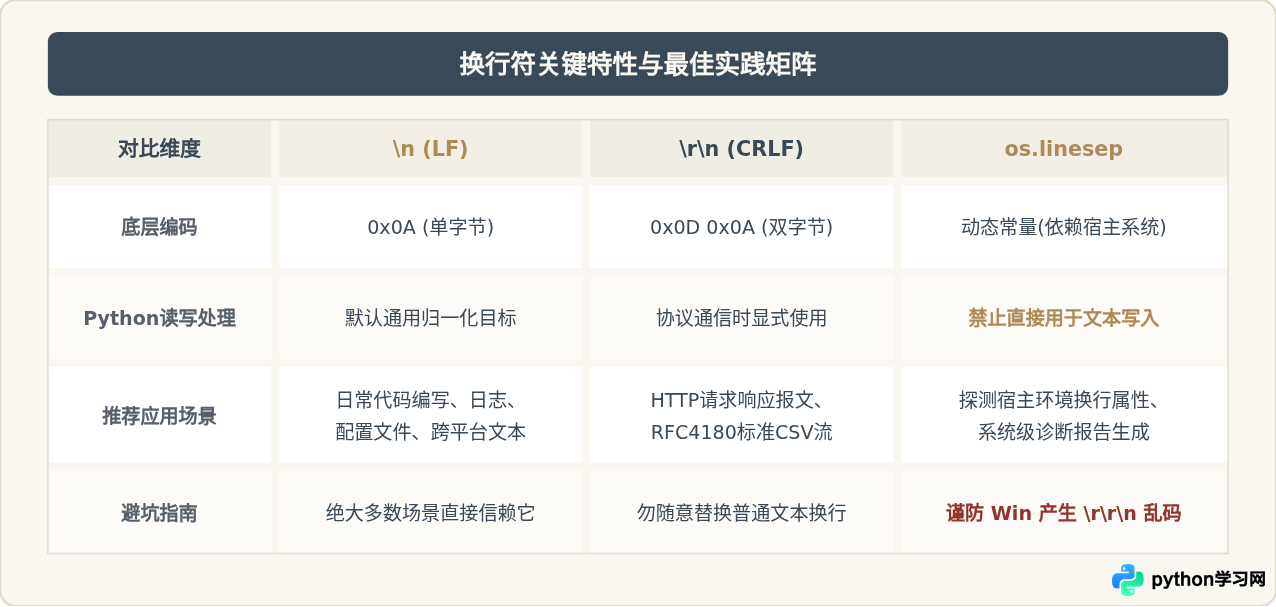
六、核心总结
记住以下三条核心准则,即可从容应对99%的Python换行符场景:
- 编写逻辑代码时:无论在什么平台上,一律写
\n。把平台的行尾适配工作交给 Python 内置的TextIOWrapper。 - 处理网络协议和CSV时:显式遵循规范。网络头必须拼接
\r\n;CSV写入必须使用open(..., newline='')。 - 看待
os.linesep时:把它当作只读的环境信息探测器,切勿随手拼接入文件写入字符串中。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















