


Python在线运行器与本地环境有什么区别?性能与IO限制说明
深入对比Python在线运行器与本地开发环境的核心区别,详细解析两者的底层架构差异、CPU与内存性能配额、文件IO与网络限制,并提供实用的选型建议与排错指南。
假设你写好了一段读取本地 data.csv 文件并抓取网络数据的 Python 脚本,在本地终端运行毫无问题,但把同一段代码粘贴到网页端的在线运行器时,却连续抛出“找不到文件”或“网络连接超时”的错误。两者的核心差别在于运行载体与权限边界:在线运行器是在多租户隔离沙箱(或浏览器内 WebAssembly 运行时)中执行代码,受到严格的 CPU 时长、物理内存、磁盘虚拟化及出站网络限制;本地环境则直连计算机的物理硬件与操作系统内核,拥有完整的系统访问权和长任务执行能力。本文将具体剖析两者的底层架构差异、性能边界与常见限制,帮助你在不同开发场景中做出合理的工具选择。
一、底层架构差异:沙箱容器与原生系统
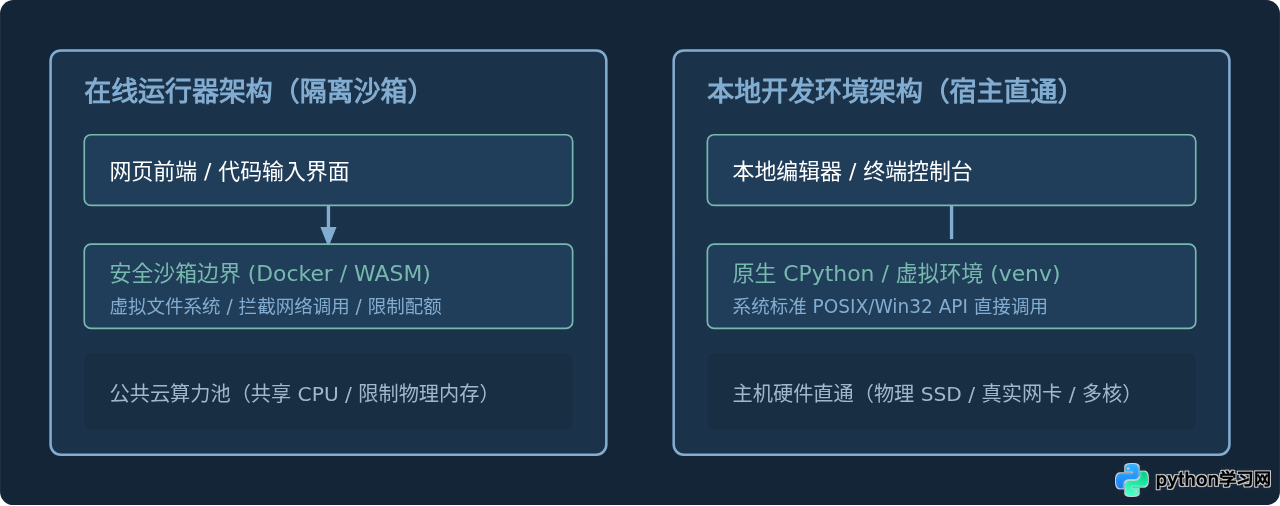
很多初学者常把在线运行器看作“放在网上的 VS Code”,但实际上它们背后的执行机制完全不同。主流的 Python 在线运行环境主要分为两大阵营,每种方案在资源和接口支持上都有明确的边界:
- 服务端轻量容器(如 Replit、Glot.io、菜鸟教程等): 用户在前端点击“运行”,网页将代码通过 HTTP/WebSocket 发送给后端集群。服务端通过 Docker、gVisor、Firecracker 等微虚拟机分配一个短暂的独立沙箱来执行,再将标准输出捕获回传给浏览器。任务完成后,临时容器通常会在数秒至数分钟内被销毁或休眠。
- 前端浏览器原生执行(如基于 Pyodide/WebAssembly 的运行器): Python 解释器本身被编译为了 WebAssembly 二进制文件,直接下载到读者的本地浏览器内部执行。这种方式完全不消耗网站服务器算力,但代码被囚禁在浏览器的 JS 运行时中,根本不存在真实的 Linux 文件系统。
- 本地原生环境: 操作系统(Windows/macOS/Linux)通过本地安装的 CPython 解释器,直接调度本地 CPU 核心、物理内存、固态硬盘控制器与网卡,拥有当前系统用户级别的全部系统调用权限。
二、计算与内存性能限制:配额与超时机制
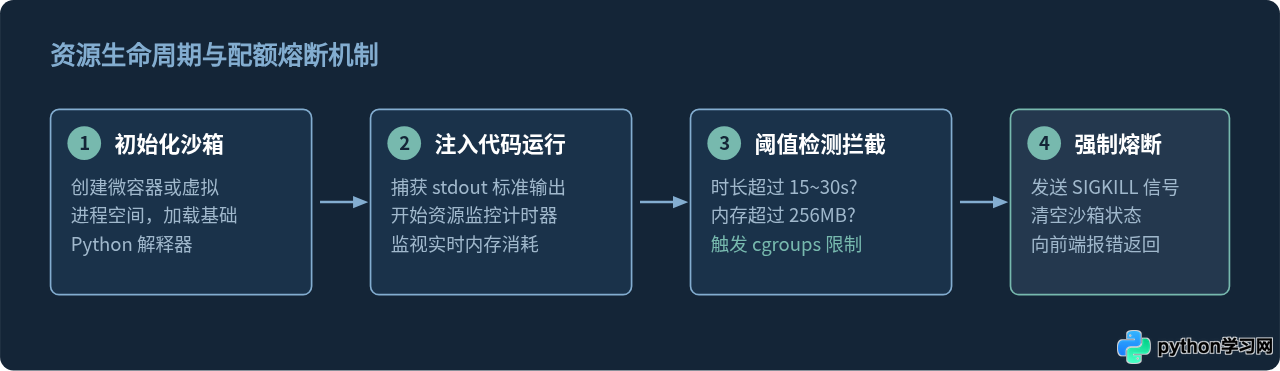
本地执行 Python 脚本时,只要没有操作系统层级的 ulimit 限制,程序可以长时间驻留,用尽全核 CPU 和所有物理可用内存。然而,在线运行器面对成千上万的并发请求,必须通过 cgroups 或控制进程严格卡死单次调用的配额。
1. CPU 执行时长截断
免费在线平台对单次执行施加了强硬的超时时间(通常在 10 秒到 30 秒之间)。如果代码包含密集型计算或死循环,进程会立即被宿主机强行终止(SIGKILL)。
# 演示在在线环境容易被强制超时的测试代码
import time

print("开始耗时任务...")
for i in range(100):
    time.sleep(1)
    print(f"进度: {i}%")
Execution Timed Out after 15000ms. Process killed.
2. 内存配额截断(OOM)
在线环境分配给单进程的内存通常在 128MB 到 512MB 之间。在本地运行机器学习小模型或使用 Pandas 加载几十兆的表格时表现平稳,但在在线平台会瞬间触发 MemoryError 或进程被后台静默击杀。
三、文件与网络 IO 深度限制说明
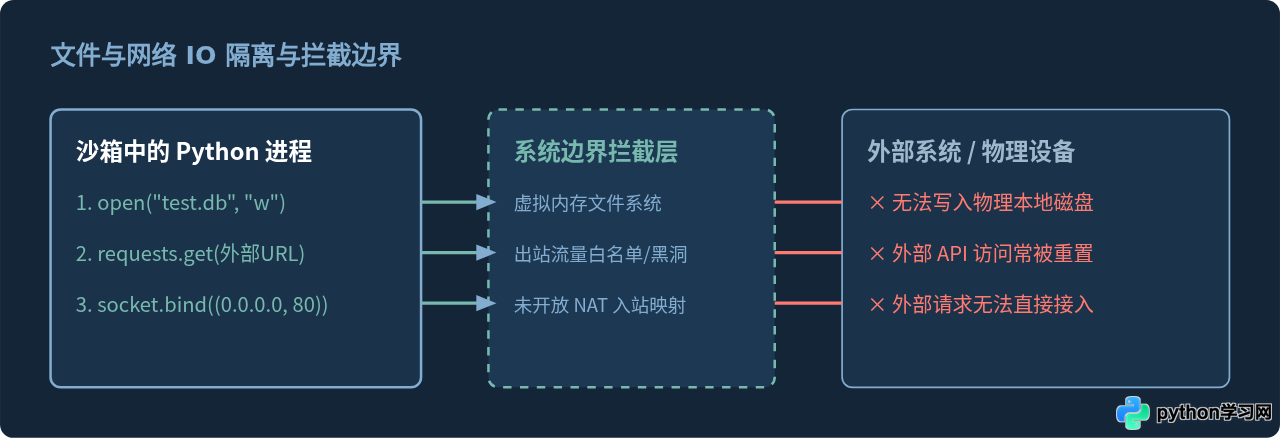
文件输入输出(File IO)和网络请求是新手在使用在线运行环境时受挫最集中的区域。由于多租户共享和防止滥用的需要,平台的权限模型做了大量约束。
1. 文件系统:虚拟化与无持久化
在本地电脑上,执行 open("data.txt", "w") 会实打实地写入机械硬盘或 SSD,下一次开机该文件依然存在。但在在线环境中:
- 临时覆盖层: 多数在线沙箱使用只读基础镜像搭配内存临时文件系统(如 Linux
tmpfs)。你确实可以调用open()写入文件,但代码运行结束瞬间,这个沙箱容器就进入销毁排队,写入的数据完全无法持久保存。 - 只读约束: 部分极简在线工具直接挂载只读文件系统,任何写操作都会直接抛出
PermissionError: [Errno 30] Read-only file system。 - 路径认知偏差: 本地常用的绝对路径(如
D:/project/a.csv或/Users/name/data.csv)在云端沙箱中根本不存在,直接调用会产生标准的FileNotFoundError。
# 在线环境测试写文件并重新读取示例
filename = "runtime_test.txt"

# 尝试在当前临时工作区写入
try:
    with open(filename, "w", encoding="utf-8") as f:
        f.write("临时会话写入测试数据\n")
    print("写入成功,准备二次读取验证...")

    with open(filename, "r", encoding="utf-8") as f:
        print("读取内容:", f.read().strip())
except PermissionError as e:
    print("错误: 当前沙箱禁止磁盘写入 -", e)
读取内容: 临时会话写入测试数据
(提示:刷新浏览器页面后,该文件将随会话重置而消失)
2. 网络请求限制:阻断外连与端口监听
如果允许在线环境任意访问外部网络,平台极易沦为黑客攻击其他服务器的“跳板机”或加密货币挖矿节点。因此,在线运行器对网络采取了极度保守的策略:
- 出站连接拦截: 平台一般配置白名单规则,阻断标准 HTTP/HTTPS 之外的任意端口(如邮件 25 端口、数据库 3306 端口)。更有甚者会完全断开外网,只要调用
requests.get()就会立即返回ConnectionRefusedError或NameResolutionError。 - 监听端口受限: 你无法在简单在线运行器里直接通过
socket.bind()或Flask/FastAPI搭建本地 Web 服务器并让外网直接访问,因为容器并没有绑定独立的公网 IP,端口映射功能通常仅在全功能云 IDE(如 GitHub Codespaces、Gitpod)中才提供。
四、详细参数与能力矩阵对照
为了直观评估哪类任务适合在线完成,哪些必须转向本地开发,我们将常用维度的特性整理如下:
| 对比维度 | 标准 Python 在线运行器 | 本地计算机开发环境 |
|---|---|---|
| 准备成本 | 零配置,打开网页浏览器即可编写并运行 | 需安装解释器、配置 PATH 环境变量、配置 IDE |
| 第三方库安装 | 预装固定库(常见为标准库 + requests/numpy),不支持 pip 自由编译 C 扩展 |
完全自主安装,支持任意依赖、PyPI 扩展库及 C 绑定二进制轮子 |
| 单次运行耗时 | 受限(普遍阈值 10s 至 30s,超额杀进程) | 无硬性限制,只要硬件不关机可长期持续跑批处理 |
| 内存资源上限 | 严格受限,单容器通常 128MB ~ 512MB | 取决于物理内存大小(如 16GB/32GB/64GB 等) |
| 文件与数据保存 | 临时存储或仅提供少许云空间,运行后销毁 | 完整持久保存在本地文件系统,可随时归档备份 |
| 网络外连与监听 | 阻断敏感端口,外网请求常受限制,不可侦听外部端口 | 享有完整网络堆栈,支持爬虫、套接字通信与自建 Web 服务器 |
| GUI 与图形界面 | 通常只支持文本交互输出(个别支持静态绘图预览) | 支持 Tkinter、PyQt 等桌面级原生 GUI 窗口开发 |
五、选型判断依据与场景总结
理解了技术底层的差异后,在实际学习与工程实践中就不必盲目纠结。根据任务特质选择对齐的工具,可以大幅节省调试环境的时间。
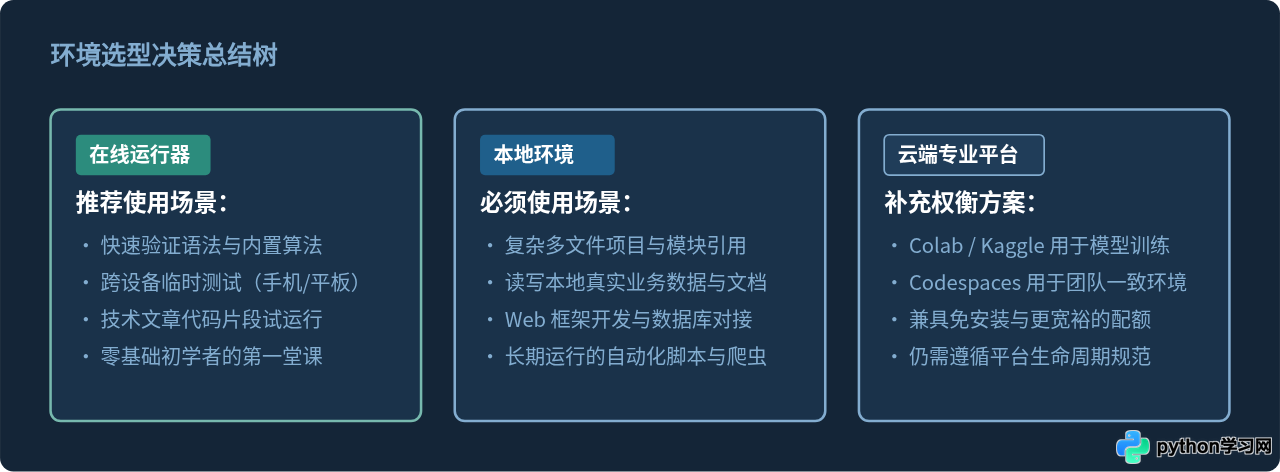
总的来说,在线运行器的核心价值是“轻便与触手可及”,非常适合用来验证单文件算法、测试正则表达式、或者向他人展示一段逻辑明确的小案例。而一旦代码涉及到读取硬盘文件、发起复杂网络通信、调用系统底层模块,或者需要执行多任务长运算时,本地搭建的 Python 虚拟环境仍然是不可替代的基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















