


面试题:seaborn0.13适配了pandas哪些弃用变更?
深入拆解Python数据可视化与工程面试高频考点:seaborn 0.13针对pandas 2.0及2.1+核心弃用变更的全面适配实践,包括类型检查重构、GroupBy观察语义控制、已移除API替换及Copy-on-Write兼容机制。
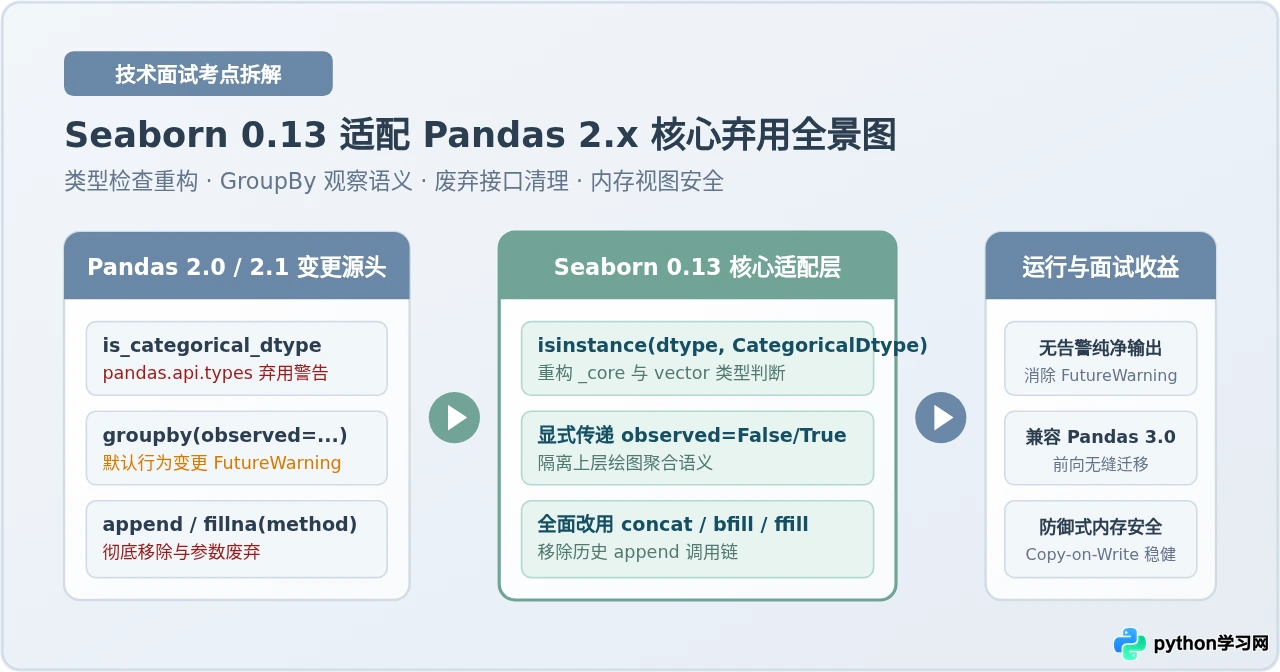
FutureWarning 与 DeprecationWarning,并确保在即将到来的 Pandas 3.0 中稳定运行,Seaborn 0.13 重点完成了四大维度的弃用适配:一是将已被废弃的 pandas.api.types.is_categorical_dtype 类型检查全面迁移至基于 isinstance(dtype, pd.CategoricalDtype) 的安全检查;二是主动防御 Pandas 2.1 引入的 groupby(observed=...) 默认值反转变更,显式锁定类目观察语义;三是彻底清洗了已在 Pandas 2.0 中移除的 DataFrame.append 及弃用的 fillna(method=...);四是重构内部数据流以完全兼容 Pandas 2.0+ 的 Copy-on-Write(写时复制)机制与非纳秒时间戳分辨率。
一、背景与演进:为什么 Seaborn 0.13 必须深度适配 Pandas?
在 Python 数据科学生态中,Seaborn 建立在 Matplotlib 的绘图引擎和 Pandas 的数据结构之上。在过去,Seaborn 的内部逻辑深度依赖于 Pandas 早期较为宽松的类型判断函数、就地修改(in-place mutation)习惯以及一些遗留 API。
然而,随着 Pandas 2.0 重构了底层数据管理器(BlockManager 与 ArrayManager 并存,引入 PyArrow 原生后端,并在 2.1 中大力推进类型系统严格化),大量使用已久的接口被列入废弃时间表。如果不进行主动重构,用户在调用 sns.barplot、sns.catplot 或使用全新的 objects 接口时,终端控制台就会被铺天盖地的警告信息淹没,甚至在升级至 Pandas 2.0 纯净环境时直接抛出 AttributeError。
因此,Seaborn 在 0.13.0 版本中不仅带来了绘图接口特性的改进,更重要的是完成了一次系统的“底层大扫除”,系统化对齐了现代 Pandas 的 API 规范。
二、核心适配一:分类数据体系与类型检查重构
分类数据(Categorical Data)是 Seaborn 处理分类轴、颜色映射(Hue)、分面(Facet)的核心。Pandas 在 2.1 版本对类型检查机制做出了重大调整,这也构成了 Seaborn 0.13 改动最密集的部分。
1. 替换 is_categorical_dtype
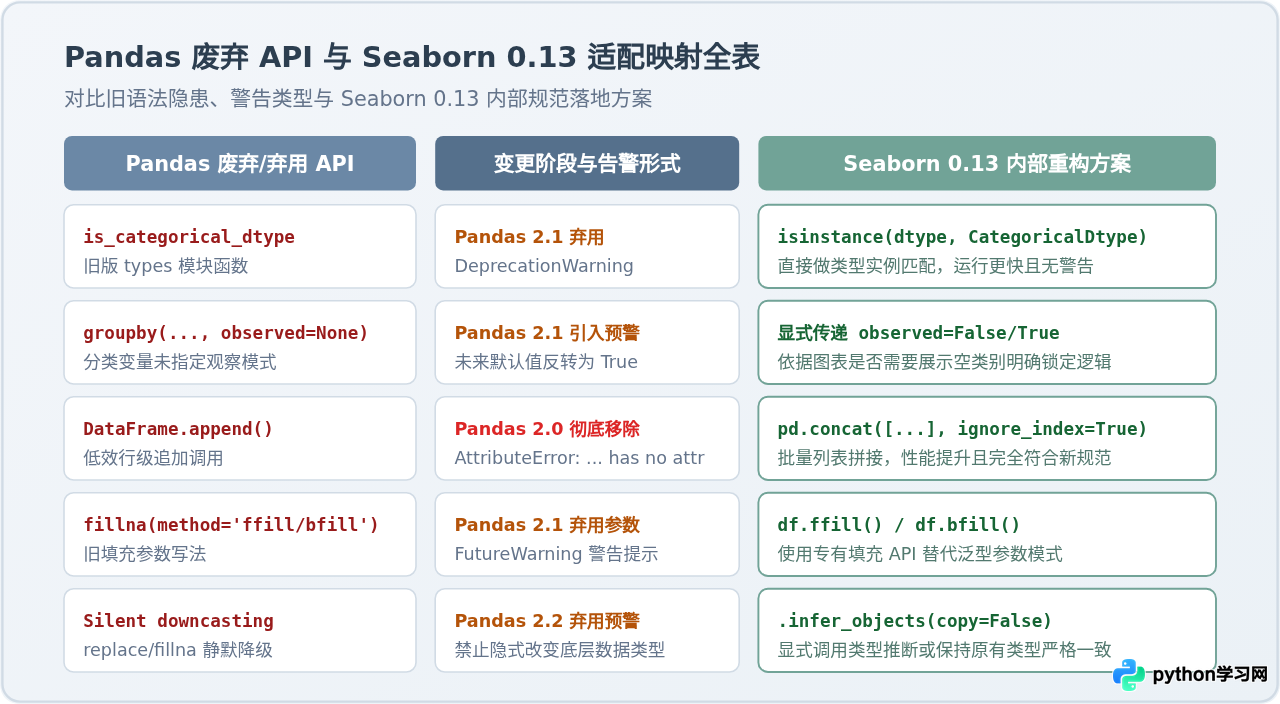
在旧版代码中,Seaborn 广泛使用 pandas.api.types.is_categorical_dtype(series) 来判断某列数据是否为类别类型。在 Pandas 2.1 中,该函数被正式标记为废弃,官方推荐直接通过数据类型的实例判断。
Seaborn 0.13 在内部(尤其是 _core.properties 和 _core.rules 模块)彻底废除了对各类弃用检查函数的直接调用:
# 旧版做法(在 Pandas 2.1+ 会触发 DeprecationWarning):
from pandas.api.types import is_categorical_dtype
if is_categorical_dtype(vector):
    ...

# Seaborn 0.13 适配后的现代做法:
import pandas as pd
if isinstance(vector.dtype, pd.CategoricalDtype):
    ...
2. 显式应对 GroupBy 的 observed 参数默认值翻转
这是在各类技术面试中经常被考察的细节考点。在 Pandas 2.1 之前,当对包含分类变量(Categorical)的 DataFrame 执行 df.groupby(...) 时,如果不指定 observed 参数,默认值为 observed=False(即保留所有类别,即使某些类别在数据中没有对应样本出现)。
Pandas 2.1 引入了一项重大弃用计划:未显式传递 observed 参数将触发 FutureWarning,并警告未来版本(Pandas 3.0)中默认值将切换为 observed=True(仅统计实际出现过的类别)。
对于统计图表而言,是否显示“计数值为 0 的类别”直接影响柱状图的间距排布与分组对齐。Seaborn 0.13 全面审查了所有的 groupby 调用,根据绘图语义显式传递布尔值:
# Seaborn 0.13 内部对分类变量分组的典型适配:
# 不再依赖默认行为,明确传入 observed=False 保留未观测到的类目占位
grouped = df.groupby(cat_col, observed=False)
stat_df = grouped.agg(estimator)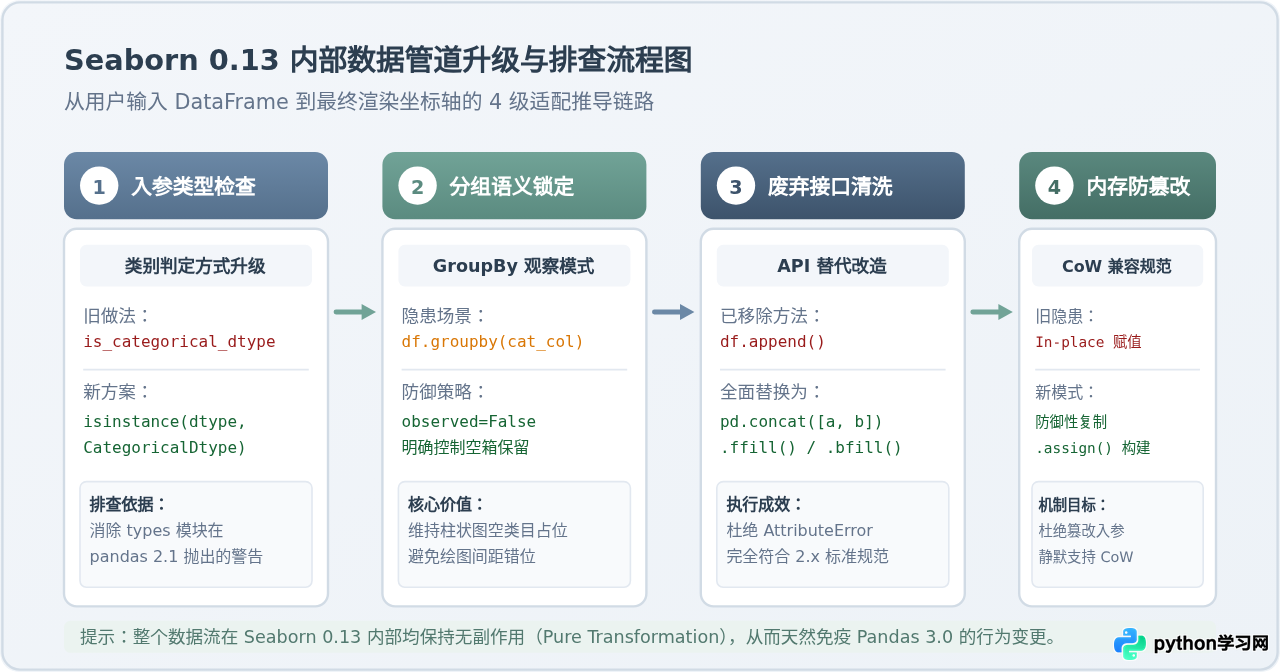
三、核心适配二:常规 API 废弃清洗与替换
除了类型系统的重塑,Pandas 2.0 对若干历史遗留方法的强力清理也是 Seaborn 必须面对的硬性变更。
1. 彻底清除 DataFrame.append 与 Series.append
在早期的 Pandas 教学与开源项目中,通过 df.append() 循环追加行是常见的写法。由于这种追加操作每次都会在底层重新申请内存并完整复制数据,性能极其低下,Pandas 在 1.4 中标记废弃,并在 2.0 中彻底将其物理移除。
如果继续在 2.0 环境中调用该方法,程序会直接报错:AttributeError: 'DataFrame' object has no attribute 'append'。Seaborn 0.13 将历史上所有拼接图元统计结果的地方统一改造为收集 DataFrame 列表后使用 pd.concat 批量操作:
# 已经无法在 Pandas 2.0 中运行的历史代码:
# result = result.append(chunk)

# Seaborn 0.13 的标准改造:
result = pd.concat([result, chunk], ignore_index=True)
2. 废弃 fillna(method=...),切换为专用方法
Pandas 2.1 弃用了 Series.fillna(method='ffill') 和 Series.fillna(method='bfill') 中的 method 命名参数,转而要求显式使用独立的 .ffill() 与 .bfill() 方法。Seaborn 0.13 针对内部的数据插值与平滑处理完成了同步替换。
四、核心适配三:Copy-on-Write 与时间戳精度机制
这一部分属于更高阶的架构兼容,是展现工程理解深度的关键加分项。
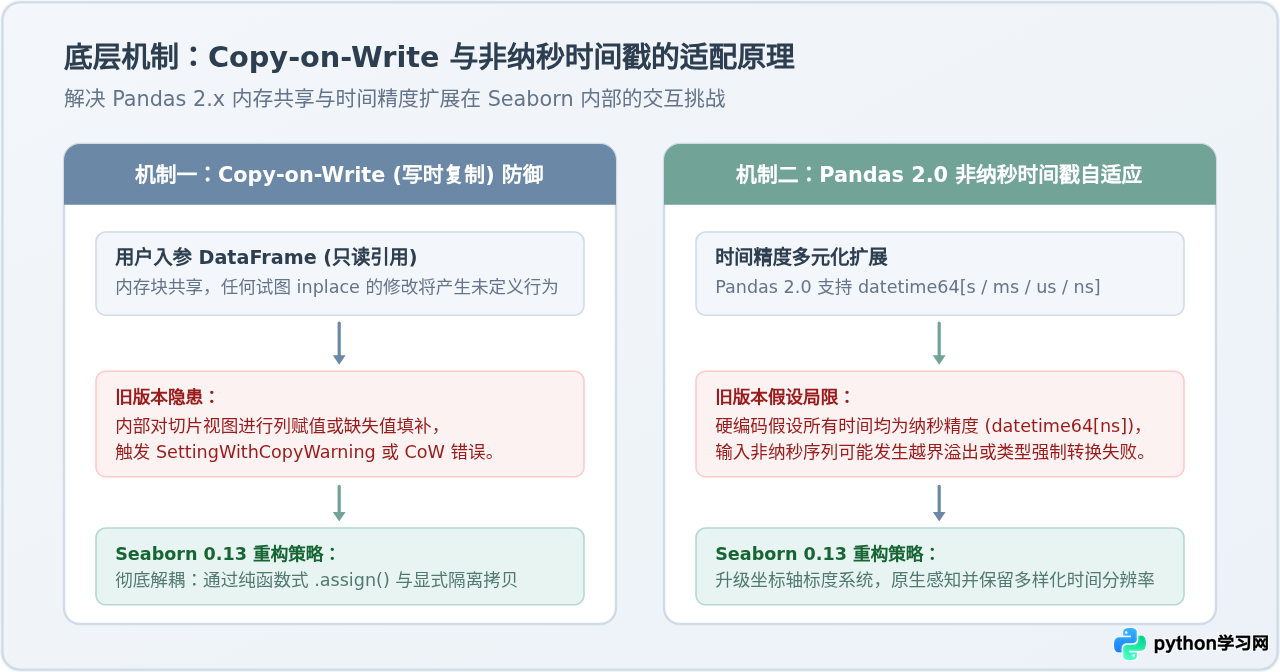
1. Copy-on-Write (CoW) 规范下的无害化数据操作
Pandas 2.0 带来了革命性的 Copy-on-Write 机制(并在 Pandas 3.0 中作为默认开启的基石特性)。在 CoW 模式下,对 DataFrame 进行切片得到的不是传统意义上不可控的 view,对 view 的原位就地写入操作会被禁止或强制解耦。
过去,一些可视化库在拿到用户的 DataFrame 后,会尝试在原表子集上直接赋值(例如为数据添加临时的 _hue 转换列),这极易触发 SettingWithCopyWarning。Seaborn 0.13 全面践行“无副作用转换”,在接收输入数据后,绝不在原始数据上做 inplace 篡改,而是使用函数式 .assign() 或在必要时进行深层隔离,从而天然兼容开启 CoW 的高性能环境。
2. 非纳秒时间戳分辨率原生支持
在 Pandas 2.0 之前,所有的日期时间对象在底层都被强制规范为纳秒精度(datetime64[ns]),这导致早于 1677 年或晚于 2262 年的时间戳会直接溢出崩溃。Pandas 2.0 正式引入了秒(s)、毫秒(ms)、微秒(us)三种更宽泛的时间分辨率。
Seaborn 0.13 重构了坐标轴刻度与格式化器(DateFormatter / DateLocator 适配层),确保在接收 datetime64[ms] 等非纳秒列时,不会强行向下转换为 ns 而引发数值越界异常。
五、面试实战:如何结构化回答这道题目?
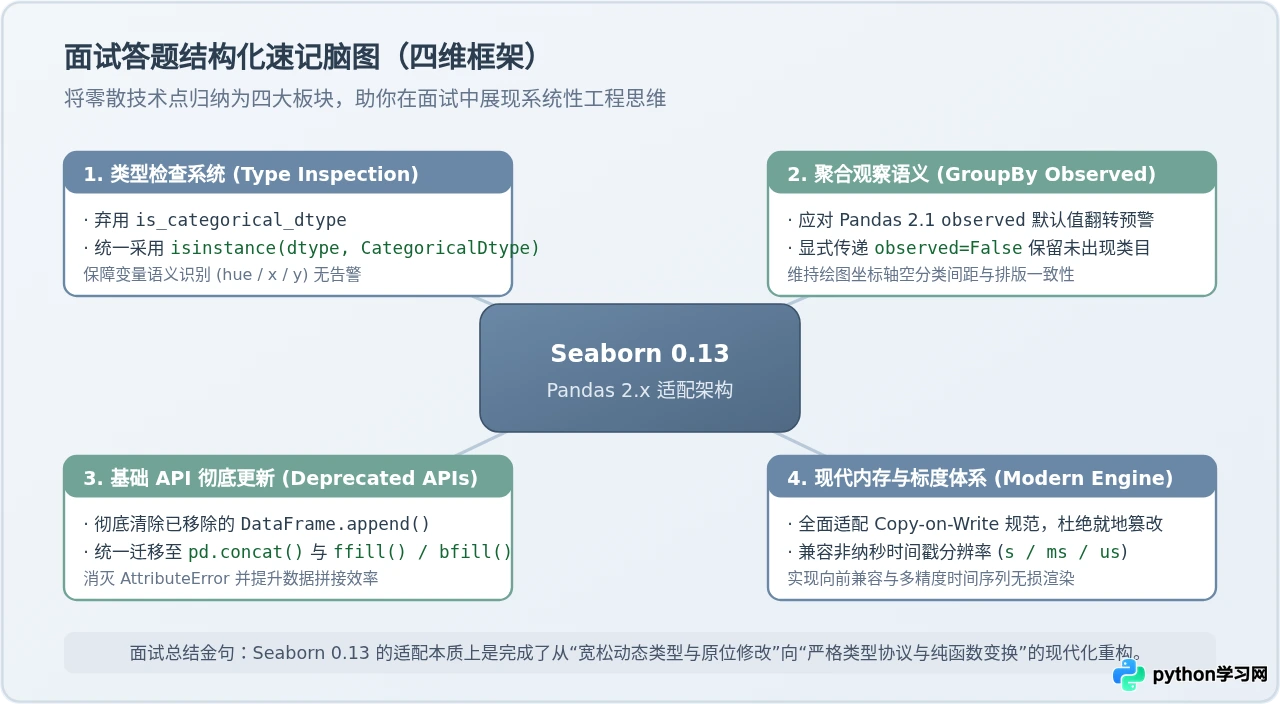
在技术面试中,如果被问到“seaborn 0.13 适配了 pandas 哪些弃用变更”,不要仅零散地回答一两个函数名。建议采用以下结构化回答策略:
- 总览定调: 指出 0.13 是 Seaborn 适配 Pandas 2.x 大版本演进的核心版本,重点目标是清除各类
FutureWarning并实现向前兼容(Forward Compatibility)。 - 分层阐述关键点:
- 类型判定层: 针对
pandas.api.types模块的去中心化,将is_categorical_dtype迁移为原生的isinstance(dtype, pd.CategoricalDtype)。 - 聚合语义层: 应对
groupby(observed=...)默认值即将在 3.0 翻转的预警,显式控制分类数据的观察模式,保障图表空刻度一致性。 - 接口移除层: 全面下线已移除的
append,替换为高效的pd.concat;将fillna(method=...)迁移至.ffill()/.bfill()。 - 底层机制层: 适配 Copy-on-Write(避免原位修改引发警告),支持 Pandas 2.0 新增的秒/毫秒级非纳秒时间序列。
- 类型判定层: 针对
- 拔高总结: 解释第三方库在生态底座大升级时的适配原则——即从“依赖隐式默认行为”转向“显式约定与纯数据流变换”。
六、环境验证与常见排查方法
若读者在自己的工程项目中需要验证相关适配或排查升级告警,可以使用以下方法进行环境测试:
# 开启所有警告捕获,排查依赖链中的弃用提示
import warnings
import seaborn as sns
import pandas as pd

# 将特定警告设为报错,便于精准定位抛出位置
warnings.filterwarnings("error", category=FutureWarning)

df = pd.DataFrame({
    "group": pd.Categorical(["A", "B", "A"], categories=["A", "B", "C"]),
    "val": [10, 20, 15]
})

# 在 seaborn 0.13.0 + pandas 2.1+ 环境下运行:
# 正确渲染图表且没有任何未捕获的 FutureWarning
ax = sns.barplot(data=df, x="group", y="val")pandas >= 2.1.0,请务必同步升级 seaborn >= 0.13.0,这将直接解决 95% 以上因统计分组和类型推断导致的终端警告问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















