


Python中pandas与openpyxl读取Excel转字典的性能对比
深入对比Python中使用pandas与openpyxl读取Excel并转换为字典的性能差异,从执行耗时、内存占用、底层解析机制以及实际业务场景提供选型建议。
在Python自动化办公、接口数据驱动测试以及批量数据导入场景中,读取Excel工作表并将其转化为字典(例如以列名为键、行记录构成的字典列表 list[dict])是一项基础且频繁的操作。不少开发者在面对数据量上涨时,常常在 pandas 与 openpyxl 之间犹豫不决。本文将通过原理剖析、转换流程对比、耗时与内存实测特征分析,全面解答两者在不同数据规模下的表现与技术边界,帮助你在实际工程中做出恰当的技术选型。
一、核心结论速览
在不涉及复杂数据清洗、仅完成“读取Excel并组装为字典对象”的任务中,两者的性能表现呈现出清晰的场景分水岭:
- 轻量级与内存敏感场景(万行以内或低配运行环境):使用
openpyxl的read_only=True配合iter_rows(values_only=True)生成器是首选。它不仅无需引入重量级依赖,其流式解析特征还能将内存控制在几十兆以内的恒定水平。 - 中等规模全量导入场景(数万行数据):
pandas的底层C扩展与NumPy连续数组在批量读取时能够发挥并行与向量化优势,解析耗时明显低于纯Python循环,但峰值内存占用会高出数倍。 - 超大规模文件转换(十万行以上):若必须将所有数据一次性转化为Python原生字典对象,
pandas.DataFrame.to_dict()本身也是一个高开销的Python级拆包操作,此时解析阶段节省的时间可能被字典实例化阶段稀释;若遇到内存瓶颈,openpyxl的流式只读遍历反而更稳妥。
二、典型实现与操作路径对比
为了保证对比的公平性,我们需要分别使用两套库中推荐的高效写法,将首行视作字段名(Key),每一行数据构造成一个字典对象。
1. openpyxl 的流式读取转字典
在 openpyxl 中,如果直接调用常规的 load_workbook(),库会将所有单元格样式、公式元数据以DOM对象形式完全加载进内存,这会带来严重的性能开销。因此高效转换必须开启只读流式模式:
from openpyxl import load_workbook

def openpyxl_to_dicts(file_path, sheet_name=None):
    # read_only=True 启用只读流式解析,大幅降低内存与时间开销
    wb = load_workbook(filename=file_path, read_only=True, data_only=True)
    ws = wb[sheet_name] if sheet_name else wb.active

    # 启用 values_only 避免生成富文本与单元格对象
    row_iter = ws.iter_rows(values_only=True)
    try:
        headers = next(row_iter)
    except StopIteration:
        wb.close()
        return []

    records = [dict(zip(headers, row)) for row in row_iter]
    wb.close()
    return records
2. pandas 的表格读取转字典
pandas 将Excel解析为二维 DataFrame,随后借助其内置方法转为字典列表:
import pandas as pd

def pandas_to_dicts(file_path, sheet_name=0):
    # pandas 默认依赖 openpyxl 或 calamine 引擎解析 .xlsx
    df = pd.read_excel(file_path, sheet_name=sheet_name)
    # orient='records' 输出格式为 [{col1: val1, ...}, ...]
    return df.to_dict(orient='records')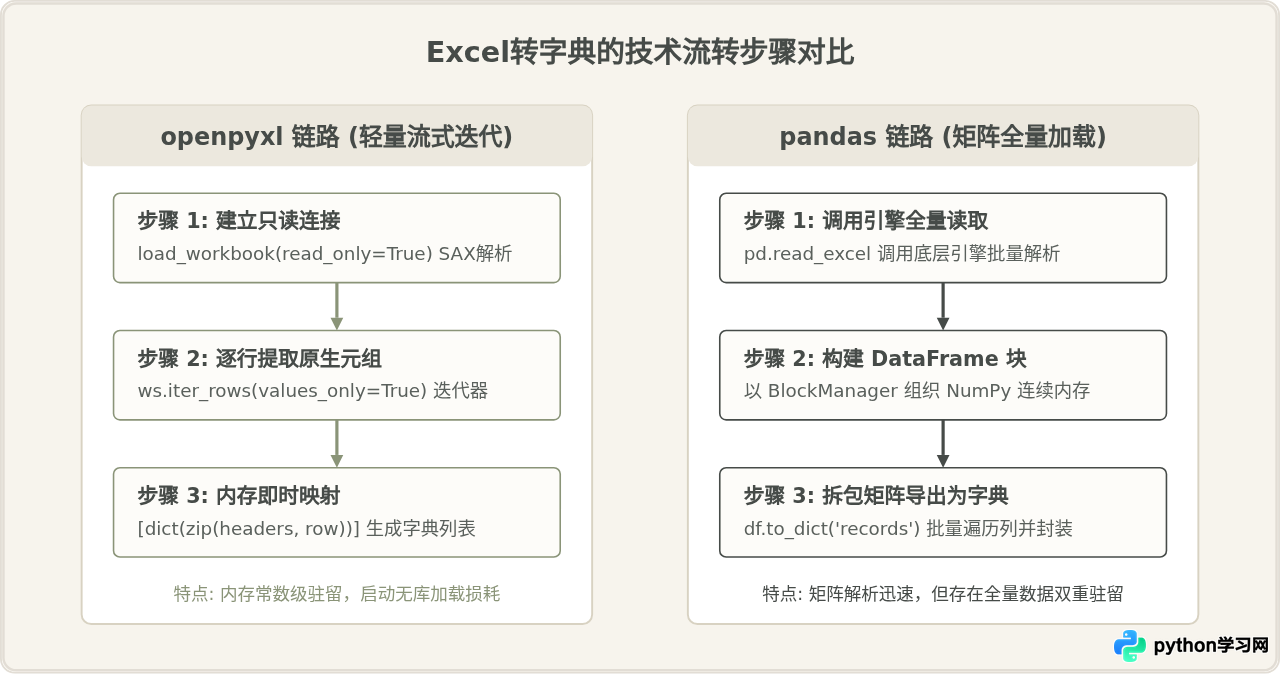
三、性能基准与核心指标对比
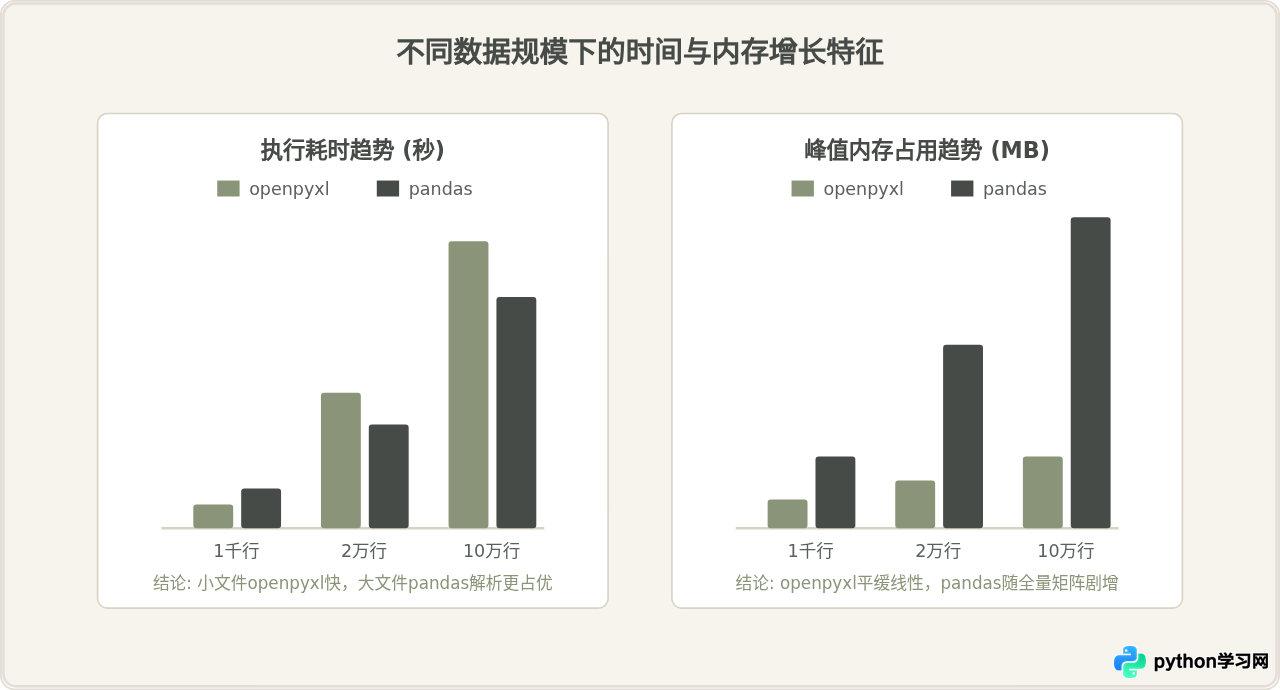
性能差异不仅体现在纯粹的毫秒耗时上,内存开销往往是决定生产服务是否会发生OOM(内存溢出)的关键指标。下表总结了在常见数据规格(以标准10列字符串与数值混合数据为例)下的性能基准趋势:
| 数据规模 (行数) | 指标维度 | openpyxl (read_only) | pandas (默认引擎) | 综合表现评价 |
|---|---|---|---|---|
| 小规模 (1,000 行) | 耗时 (秒) | ~ 0.04 - 0.08 s | ~ 0.15 - 0.25 s | openpyxl 启动迅速,无框架预热包袱;pandas 耗时主要集中在库自身初始化与DataFrame构造。 |
| 内存峰值 | ~ 15 - 20 MB | ~ 45 - 60 MB | ||
| 中规模 (20,000 行) | 耗时 (秒) | ~ 0.9 - 1.3 s | ~ 0.6 - 0.9 s | pandas 批量读取优势逐渐显现,整体耗时开始超越 openpyxl,但内存开销增幅更显著。 |
| 内存峰值 | ~ 25 - 35 MB | ~ 120 - 180 MB | ||
| 大规模 (100,000 行) | 耗时 (秒) | ~ 4.8 - 6.2 s | ~ 3.5 - 4.8 s | pandas 在解析端极快,但 to_dict() 产生二次性能损耗;openpyxl 内存极平稳,适合流水线流式处理。 |
| 内存峰值 | ~ 40 - 55 MB | ~ 350 - 500 MB |
四、底层原理与差异根源剖析
很多开发者认为“pandas 速度一定比纯 Python 快”或者“openpyxl 速度一定很慢”,这种模糊的直觉忽略了两者的架构设计差异。
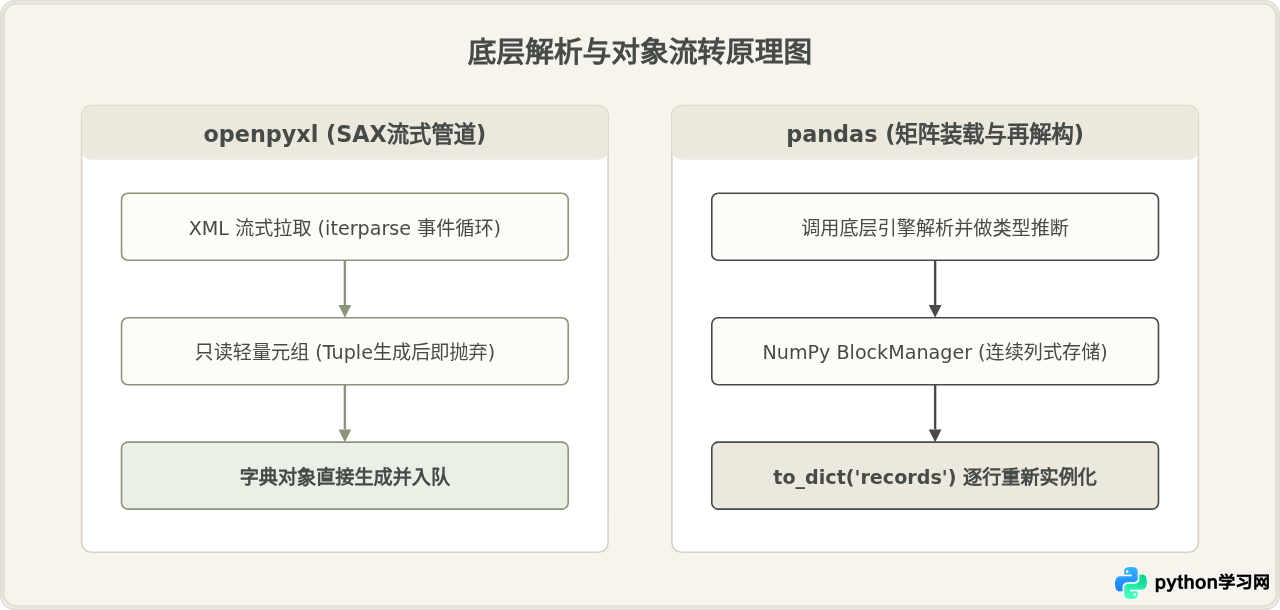
1. openpyxl 只读模式的核心:SAX流式解析
标准的 .xlsx 文件实质上是一个包含多个 XML 文件的 ZIP 压缩包。通常情况下,openpyxl 采用类似 DOM 的树形结构把每个单元格解构为 Cell 对象,包含边框、颜色、字体、公式及单元格坐标等海量属性。但在 read_only=True 模式下:
- 底层使用 Python 的流式 XML 解析器(如
xml.etree.ElementTree.iterparse),按需从输入流拉取数据。 - 一旦解析完一行单元格,直接返回原生数据类型的不可变元组(Tuple),并立即丢弃前一行的 XML 节点引用,交由垃圾回收器(GC)处理。
- 这就是为什么其内存曲线几乎是一条平坦的直线,完全取决于瞬时单行的大小。
2. pandas 的核心:底层批量解构与两次对象转换
pandas.read_excel 并非自行编写了解析 XML 的代码,其默认引擎正是 openpyxl(在未安装其他加速引擎时)。那为何中大规模下 pandas 还会比纯 Python 更快?
- C/NumPy 底层矩阵装载:pandas 在读取到底层数据流后,迅速将其交由 C 级别的 NumPy 结构体(
BlockManager)管理,数据在连续内存块中被紧凑组织,省去了大量 Python 对象的包装开销。 - 字典转换的二次开销:当执行
df.to_dict('records')时,pandas 必须跳出高效的 C 连续内存,在 Python 解释器层面逐行提取各列标量,重新构造dict字典对象。在大数据量下,这个转换过程往往会占据整体运行时间的 30% 到 50%,并且导致瞬间生成两份完整数据(一份在 DataFrame 内存块,一份在字典列表对象)。
五、容易混淆的常见误区辨析
误区 1:“用 openpyxl 一定很卡,随便测一下就要几秒钟。”
辨析:很多开发者在编写代码时习惯性使用 wb = load_workbook(path) 而未开启 read_only=True。此时 openpyxl 会将整张表所有单元格的样式、字体、对齐和合并单元格信息全部构造成 Python 对象,导致速度下降数倍甚至数十倍。在正确使用 read_only=True 和 values_only=True 后,openpyxl 的速度完全可以满足绝大多数万行级业务的处理要求。
误区 2:“pandas 底层是 C 写的,所以无论什么情况转字典都比 openpyxl 快。”
辨析:这忽略了两个关键点:一是数据量较小时,pandas 自身的导入以及 DataFrame 初始化开销反而占据了总执行时间的大头;二是 to_dict() 本身需要将 C 结构数组重新转换成 Python 语言的原生 dict,如果后续仅仅是为了把字典传给 ORM 或接口,这种“先变成矩阵、再解构为字典”的反复包装反而引入了额外的性能浪费。
误区 3:“既然最终都要字典列表,必须一次性把 records 完整读进内存。”
辨析:对于超大文件,将所有行转为字典列表 list[dict] 本身就是一种对内存不友好的数据结构。openpyxl 最大的优势在于可以通过 yield dict(zip(headers, row)) 实现**生成器模式(Generator)**,边读边处理(如逐行校验并插入数据库),全程内存恒定在 20MB 以内,而无需一次性分配几百兆内存存放列表。
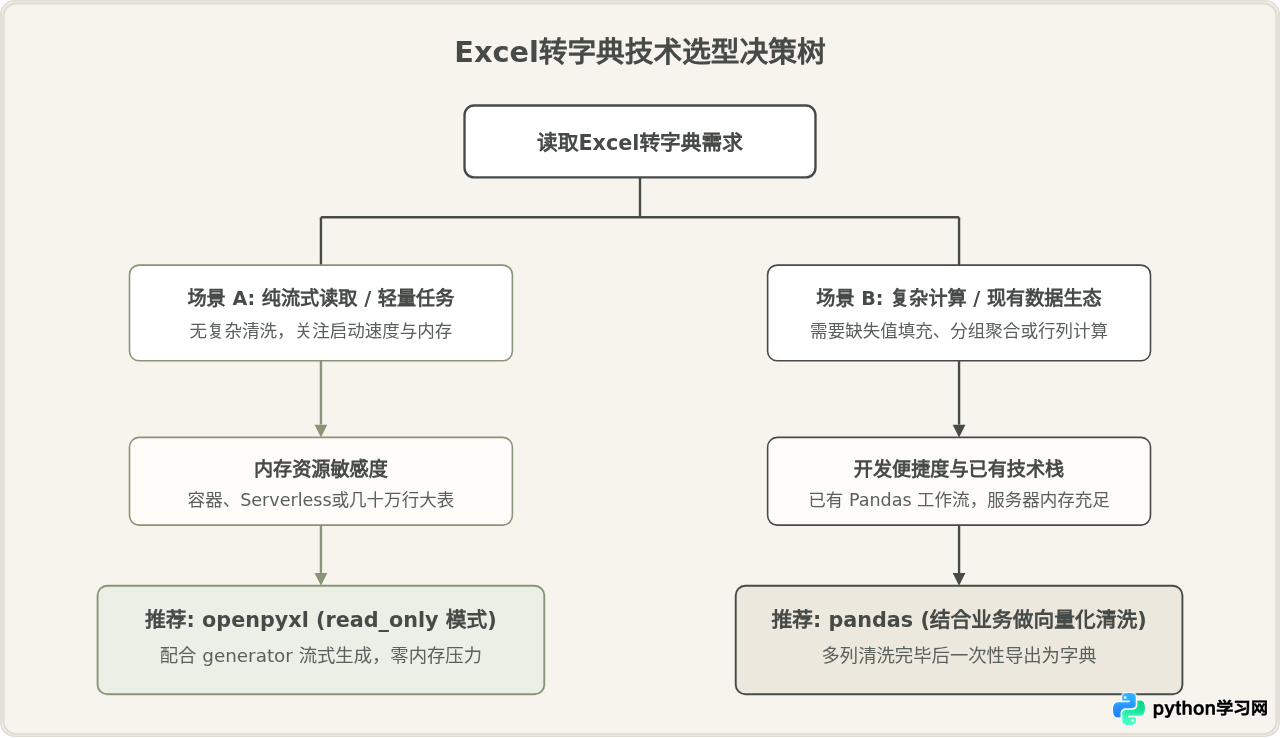
六、工程选型决策指南
为了在实际项目中快速作出恰当的架构决策,可依据以下流程进行匹配:
七、总结与最佳实践建议
综合性能与工程实践,建议在实际开发中遵循以下原则:
- 避免全量DOM加载:在单纯读取数据时,切忌使用
openpyxl的默认参数进行普通读取,务必声明read_only=True, data_only=True以及values_only=True。 - 警惕
to_dict()内存激增:在pandas中读取数十万行大表时,牢记to_dict('records')会在内存中构造同等体量的 Python 字典对象。若只是写入数据库或逐行调用 API,更建议直接使用游标分批读取,或使用生成器替代全量字典列表。 - 追求极致纯解析速度的延伸方案:如果业务需要处理巨型 Excel 表格且对解析时延有极高要求,可以考虑结合基于 Rust 的高性能引擎(如
calamine搭配python-calamine),或者直接利用polars库,它们能够在保持极低内存占用的同时提供数倍于原生 Python 引擎的吞吐率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















