


Python递归函数处理任意深度嵌套列表展平
深入讲解如何使用Python递归函数与生成器处理任意深度的嵌套列表展平,涵盖基础递归、惰性求值、字符串陷阱与递归深度边界防范。
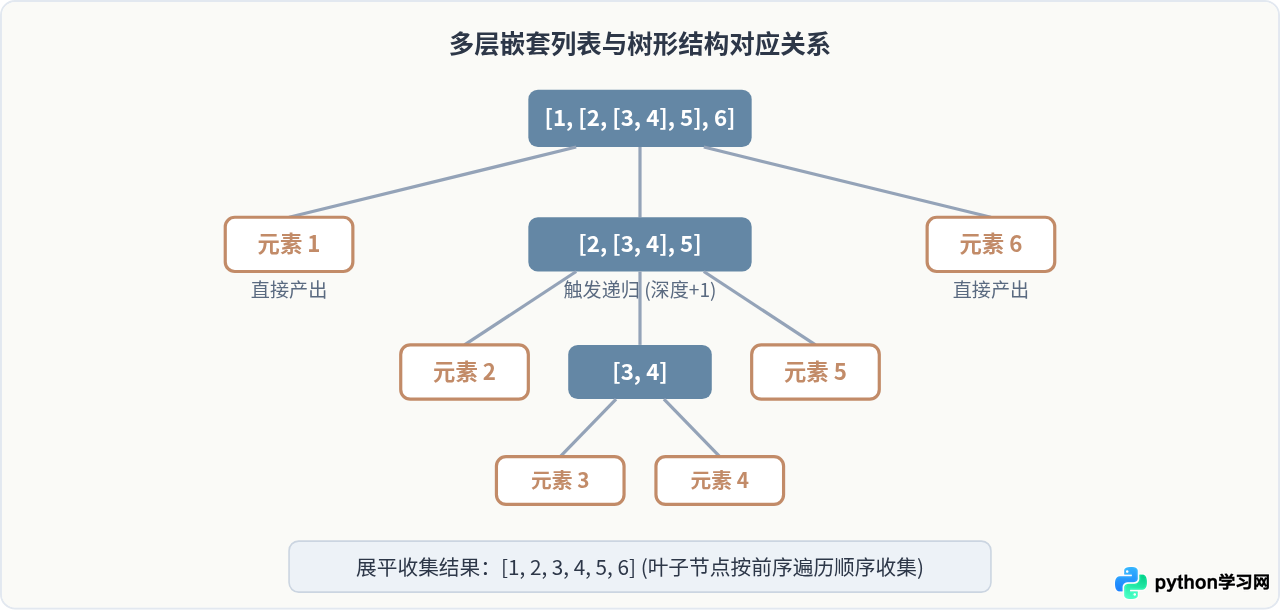
[1, [2, [3, 4], 5], 6])时,固定重数的 for 循环无法应对动态层级。解决这一问题的标准逻辑是“分治递归”:遍历列表中的每个元素,如果当前元素仍是列表则向下递归拆解,如果是非容器原子元素则直接保留收集,从而将任意树状嵌套结构压平成一维扁平序列。
一、为什么任意深度嵌套必须借助递归?
在实际数据处理、解析组织架构树或读取非结构化 JSON 数据时,经常会遇到嵌套深度无法预知的列表。例如第 1 个子元素可能只有单层包装,而第 2 个子元素可能嵌套了 5 层甚至 10 层。
常规循环的局限在于循环层数在写代码时必须是静态固定的。双重循环只能处理两层嵌套,三重循环只能处理三层。一旦遇到更深的结构,静态循环就会失效。而列表的嵌套在数学形态上本质是一棵“多叉树”:最外层的列表是树根,里面的子列表是非叶子分支节点,最终包含的具体数值或字符串则是叶子节点。递归函数天然契合树的遍历过程,只要遇到非叶子节点就进入下一级,直到所有叶子节点都被遍历完毕。
二、基础实现:经典递归累加列表
编写递归函数的核心原则只有两条:设定明确的基线条件(Base Case)与构建递归条件(Recursive Case)。
在展平操作中:
- 基线条件:当前传入的项不是列表(是数字、布尔值等基本类型),则把它作为单一元素收集;或者列表已经遍历到空,直接返回空结果。
- 递归条件:当前项是一个列表(或可迭代容器),则递归调用自身对其进行展平,将子调用返回的列表合并到当前层的结果中。
def flatten_list(nested_data):
    """
    递归展平任意深度嵌套列表
    :param nested_data: 待展平的嵌套列表或单个值
    :return: 包含所有叶子元素的一维新列表
    """
    result = []
    for item in nested_data:
        # 检查是否为列表或元组
        if isinstance(item, (list, tuple)):
            # 递归调用自身,将返回的一维列表通过 extend 拼接到结果中
            result.extend(flatten_list(item))
        else:
            # 遇到基本原子类型,直接追加到结果列表
            result.append(item)
    return result

# 验证示例
nested = [1, [2, [3, [4, 5], 6], 7], 8, [9, 10]]
flat = flatten_list(nested)
print("原始嵌套:", nested)
print("展平输出:", flat)
# 示例输出:
# 原始嵌套: [1, [2, [3, [4, 5], 6], 7], 8, [9, 10]]
# 展平输出: [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
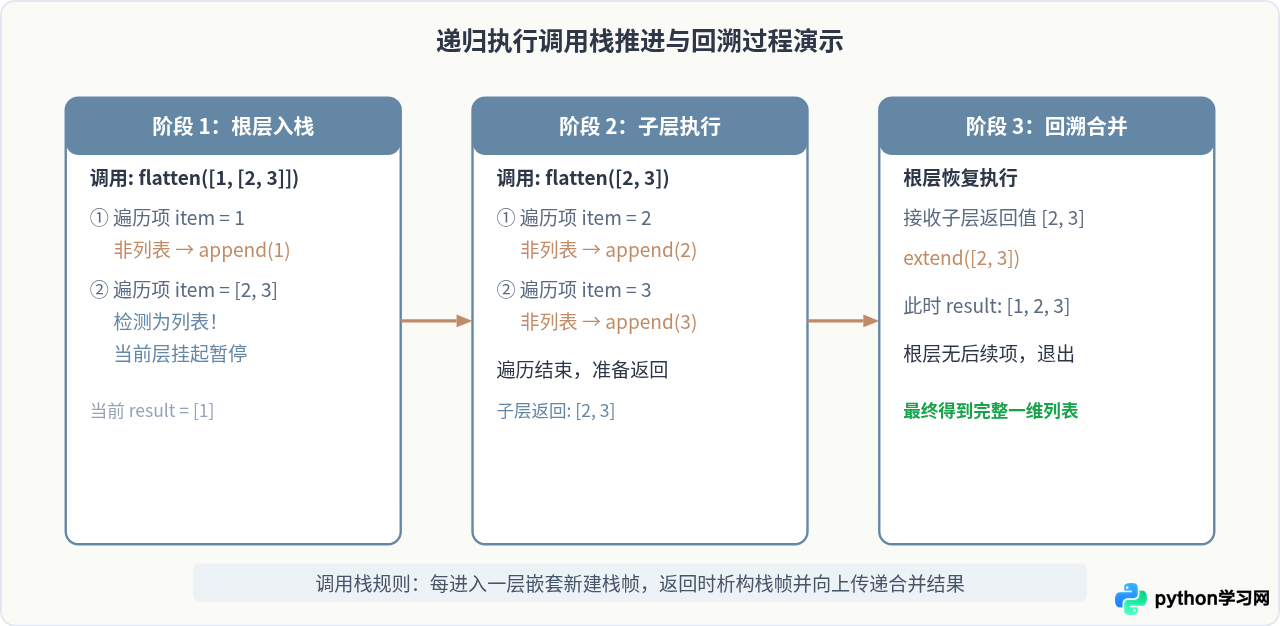
在这段代码中,result.extend(flatten_list(item)) 是最关键的一步。当遇到嵌套子列表时,当前函数的执行流程在此暂停,程序新建一个属于 flatten_list(item) 的局部栈帧(Stack Frame),开始执行子列表的解构。子列表展平完成后返回其结果,父函数拿到该结果并将其合并至自身的 result 中。
三、进阶方案:使用生成器(yield from)实现惰性展平
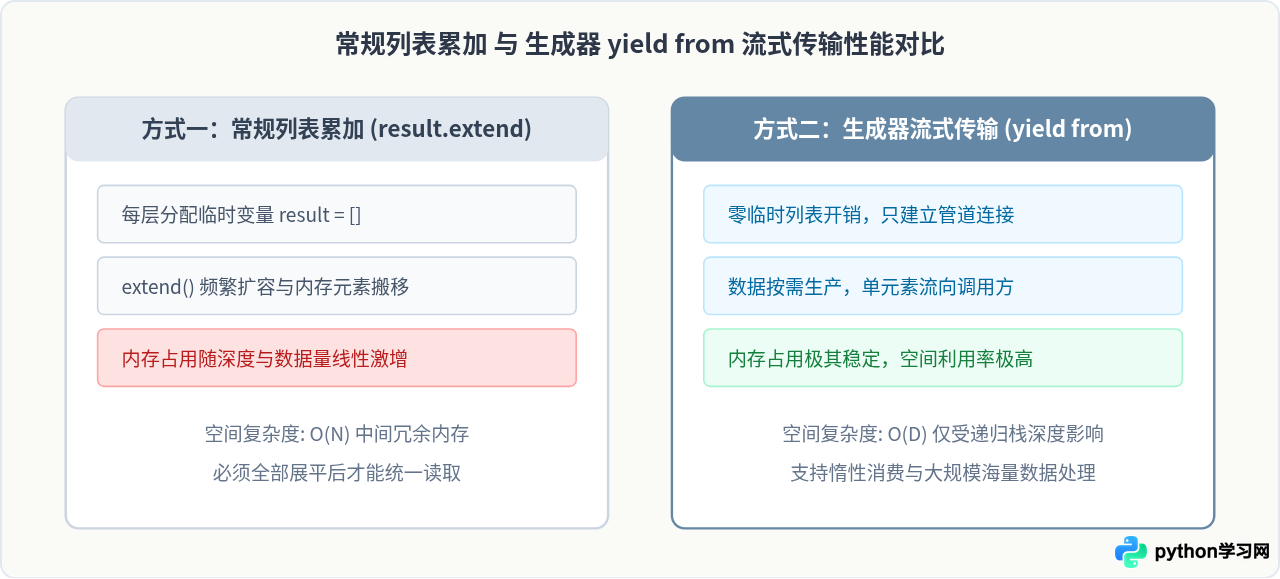
虽然基础递归实现清晰易懂,但在处理大规模数据时存在明显的性能短板:每一层递归调用都会在内存中新建一个 result = [] 临时列表,并且 result.extend() 操作会不断复制列表中的引用,导致额外的空间浪费与时间消耗。
更高效、更具 Python 风格的方式是使用生成器(Generator)。通过 yield 单独吐出每个基本元素,结合 Python 3.3 引入的 yield from 语法将子递归生成器无缝委托串联起来:
def flatten_generator(nested_data):
    """
    使用递归生成器实现内存友好的惰性展平
    :param nested_data: 嵌套结构
    :yield: 依次产出每一个解构出的原子元素
    """
    for item in nested_data:
        if isinstance(item, (list, tuple)):
            # yield from 会将子生成器产生的值逐一透传给外层调用者
            yield from flatten_generator(item)
        else:
            # 遇到单个原子元素,惰性产出
            yield item

# 使用方式 1:按需流式消费(无需占用完整内存)
data = [1, [2, [3, 4], 5], 6]
for num in flatten_generator(data):
    print(num, end=" ")  # 依次输出:1 2 3 4 5 6

# 使用方式 2:如果需要一维列表,直接用 list() 包装
flat_list = list(flatten_generator(data))
print("\n转为列表:", flat_list)
yield from 的本质是协程委托通道。它不需要在子层中创建任何中间列表对象,所有元素通过生成器管道被逐个“推送”到最外层的迭代器中。这带来了两项直接优势:
- 空间复杂度降至最低:除了递归调用栈帧本身占用的极小空间外,不需要存储任何中间层级的临时列表。
- 支持即时流水线处理:调用方可以在收到第 1 个元素时立即处理,不需要等待深层全部结构遍历完毕。
四、容易忽略的关键细节与边界防范
1. 字符串与 Bytes 的“可迭代陷阱”
初学者在编写通用展平函数时,常常习惯使用 from collections.abc import Iterable 来统一判断子项是否可以展开:
# 错误写法示例:请勿直接这样写!
from collections.abc import Iterable

def bad_flatten(items):
    for x in items:
        if isinstance(x, Iterable):  # 陷阱:str 和 bytes 也是 Iterable!
            yield from bad_flatten(x)
        else:
            yield x
在 Python 中,字符串 "abc" 是可迭代对象。对其循环会得到字符 "a"。但关键在于:单字符 "a" 本身在 Python 中依然是一个长度为 1 的 str,也是 Iterable!因此对 "a" 进行递归解构会再次得到 "a",程序陷入无限递归,最终直接抛出 RecursionError: maximum recursion depth exceeded。
正确防范方案:必须显式排除 (str, bytes),或者明确限定仅对列表、元组进行解包。
2. 递归深度限制(RecursionError)
Python 官方解释器(CPython)为了防止 C 级别的栈溢出崩溃,默认设置了递归调用深度上限(通常为 1000)。当嵌套层数超过这一深度时,会直接触发异常。
你可以通过 sys.getrecursionlimit() 查看当前限制。对于几十层到几百层的常规业务数据,默认配置完全足够;但如果面对超过 1000 层的极端深层嵌套,必须通过 sys.setrecursionlimit() 临时调整,或者采用基于显式栈数据结构的非递归迭代循环方案。
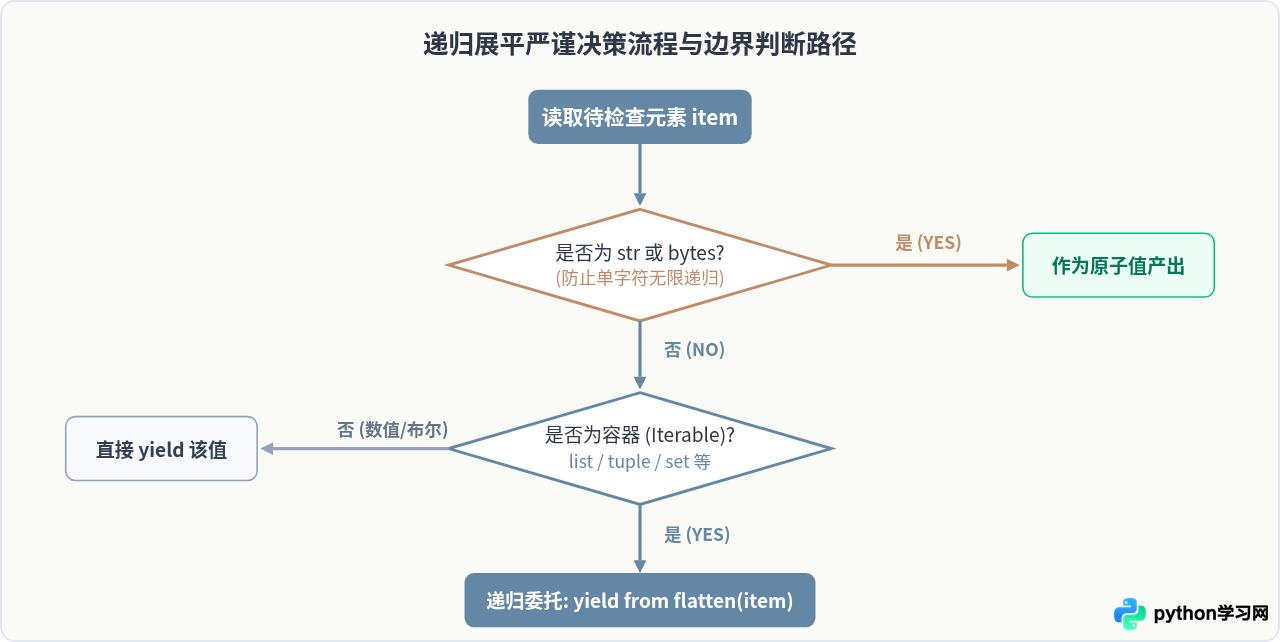
五、生产环境推荐的健壮实现模板
综合考虑类型兼容性、排除字符串陷阱与内存性能,以下是推荐在实际业务项目中直接复用的完整实现代码:
from collections.abc import Iterable

def flatten(iterable, ignore_types=(str, bytes)):
    """
    具备工业级健壮性的任意深度嵌套结构展平生成器
    :param iterable: 待展平的容器
    :param ignore_types: 不作为容器拆解的类型,默认排除 str 和 bytes
    :yield: 扁平化产出的每个原子元素
    """
    for item in iterable:
        # 判断是否为容器且不在排除类型列表中
        if isinstance(item, Iterable) and not isinstance(item, ignore_types):
            yield from flatten(item, ignore_types)
        else:
            yield item

# 测试复杂多层数据结构
test_data = [
    "hello",
    [1, 2, ("apple", "banana")],
    [[[100, 200], 300], 400],
    range(3),  # 支持 range 等通用迭代器
    500
]

result = list(flatten(test_data))
print("最终展平结果:")
print(result)
# 示例输出:
# ['hello', 1, 2, 'apple', 'banana', 100, 200, 300, 400, 0, 1, 2, 500]
六、方案选型与核心总结
在实际项目中根据数据规模与结构特点选择最合适的展平方案:
| 实现方案 | 核心语法 / 机制 | 空间复杂度 | 适用场景与建议 |
|---|---|---|---|
| 常规递归列表拼接 | result.extend(func(sub)) |
O(N) 高(频繁创建临时列表) | 结构层级浅、数据量小(几十个元素内)、要求直接返回纯列表的代码。 |
| 生成器委托(推荐) | yield from func(sub) |
O(D) 极低(仅受栈深度限制) | 首选推荐。流式读取、包含字符串/元组/嵌套多种混合容器的大型数据。 |
| 迭代显式栈方案 | stack = [items] while循环 |
O(D) 堆内存无调用栈限制 | 嵌套深度可能超过 1000 层、容易触发 Python 默认递归上限的极端深度场景。 |
理解递归解决嵌套列表的关键在于认清“容器拆解”与“原子保留”的对立统一关系。通过将树状的分支节点委托给子函数处理,无论列表包含多少层嵌套,都可以用几行优雅而健壮的代码实现安全、高效的展平。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















