


Python并发选型指南:threading、multiprocessing与asyncio怎么挑
全面解析Python三大并发方案threading、multiprocessing与asyncio的底层机制、性能特征、适用场景与避坑要点,提供清晰可执行的选型决策树与实战代码对照。
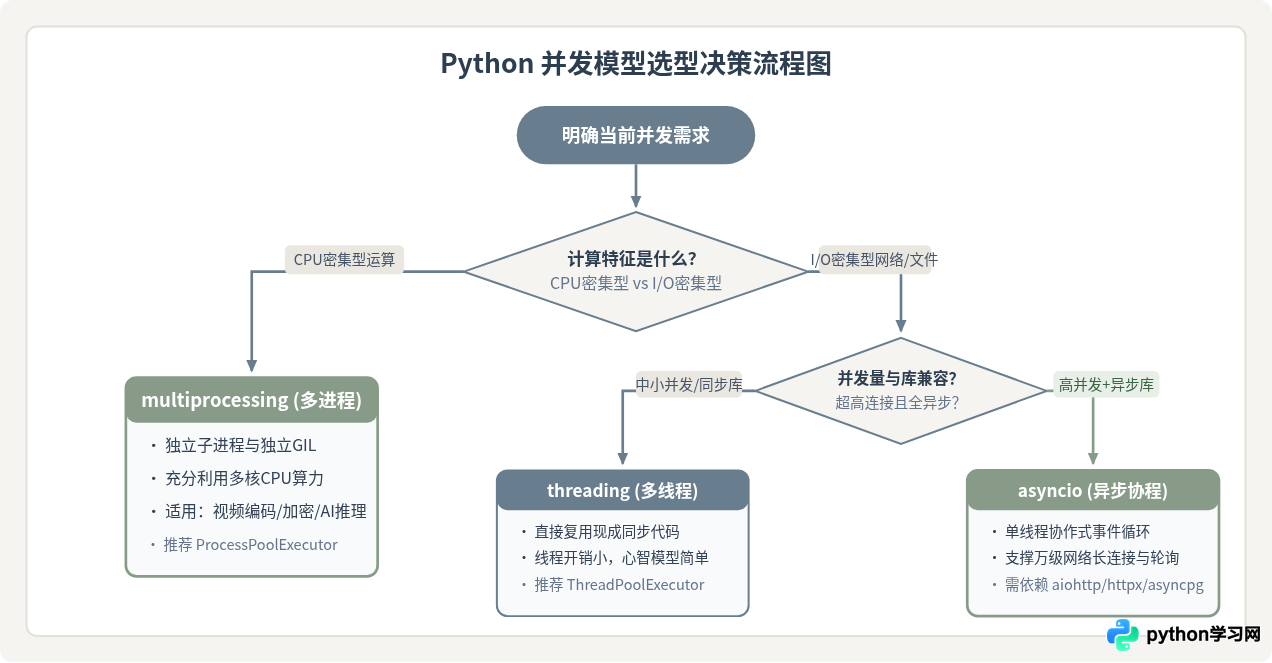
multiprocessing 绕过全局解释器锁(GIL);成百上千的高并发网络 I/O 且支持 async/await 的项目选用 asyncio;而中小规模网络请求、阻塞文件读写或既有同步旧代码的平滑加速,则首选 threading。
一、并发选型的核心分界:任务类型与 GIL 制约
在 Python 开发中,选择哪种并发工具并不能单凭“谁看起来更新潮”来决定。Python 官方标准库提供了三种成熟的并发手段:threading(多线程)、multiprocessing(多进程)和 asyncio(异步协程)。要做出正确选择,首先需要明确制约 Python 并发执行的核心机制——全局解释器锁(Global Interpreter Lock,简称 GIL)。
在标准的 CPython 实现中,GIL 保证同一时刻只有一个操作系统线程执行 Python 字节码。这意味着:
- CPU 密集型任务(如图像渲染、视频转码、复杂数学矩阵运算、加密哈希计算等):多个线程会被同一把 GIL 串行化,线程上下文切换反而会增加额外开销,导致运行速度不仅无法翻倍,甚至慢于单线程。这类任务必须通过
multiprocessing启动多个独立进程来利用多核 CPU。 - I/O 密集型任务(如 HTTP 网络请求、数据库查询、磁盘文件读写、套接字通信等):线程在等待网络或系统 I/O 返回时,会主动释放 GIL,允许其他线程获得 CPU 执行权。因此,
threading和asyncio均能显著提高 I/O 吞吐量。
二、底层工作机制与架构对比
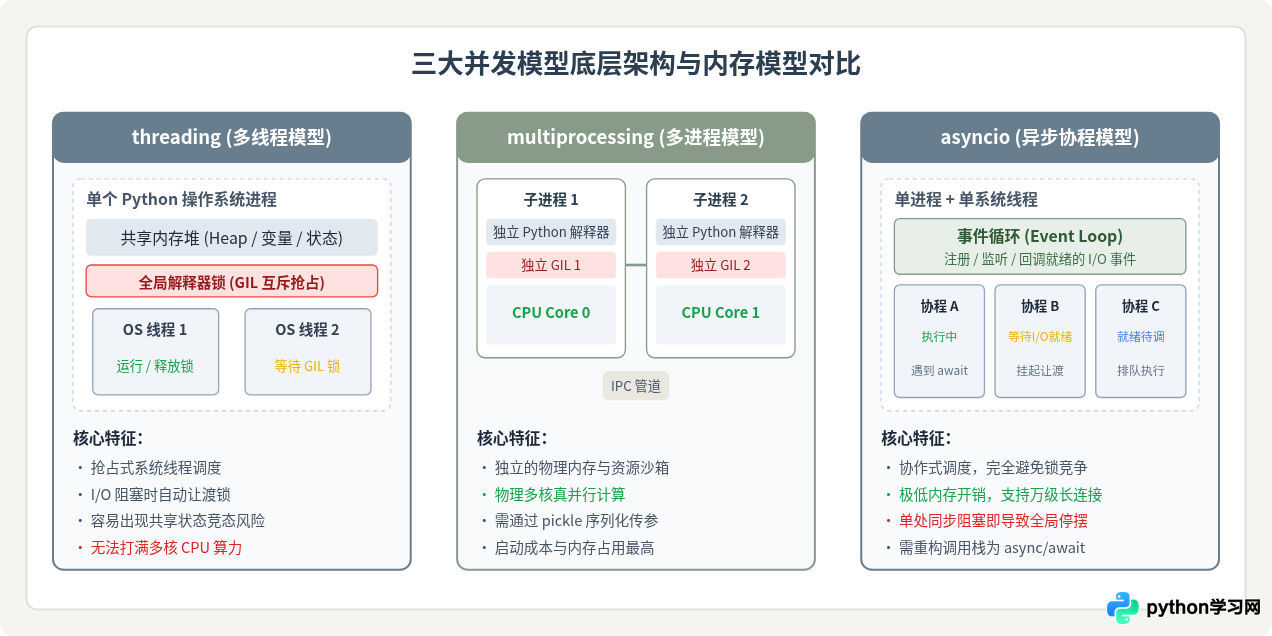
理解这三者的深层架构,能够避免盲目试错。下面逐一拆解它们在系统资源、调度策略以及内存隔离上的差异:
1. threading(多线程):共享内存与轻量调度
threading 模块使用的是操作系统原生提供的内核级线程(OS Thread)。同一进程内的多个线程共享同一个内存堆(Heap)、全局变量以及打开的文件句柄。由于所有线程都在同一个 CPython 进程内部运行,每次线程执行 Python 代码前,都必须抢占 GIL。当线程遇到 sleep()、网络等待或底层 C 扩展释放锁的 I/O 操作时,会主动释放 GIL,供其他等待中的线程执行。
优势:内存开销小(仅占用线程栈空间),不同任务之间通过共享变量、列表或队列传参极为方便。
缺陷:由于多线程共享内存,若多个线程同时读写同一资源,极易产生竞态条件(Race Condition),必须显式使用互斥锁(threading.Lock)予以保护;此外由于 GIL 的存在,无法实现多核 CPU 上的真正物理并行。
2. multiprocessing(多进程):资源隔离与真正并行
multiprocessing 通过直接在操作系统层面创建独立的子进程(使用系统调用 fork 或 spawn)来工作。每个子进程都拥有一份独立的 Python 解释器实例、独立的堆栈空间和独立的 GIL。这样一来,子进程可以分布在宿主机的不同物理 CPU 核心上,实现真正的同时并行计算。
优势:彻底摆脱 GIL 约束,CPU 计算性能可随 CPU 核心数量接近线性扩展;进程间内存严格隔离,一个子进程崩溃不会影响主进程或其他子进程。
缺陷:进程创建与销毁的系统开销显著高于线程;进程之间无法直接通过普通变量共享数据,跨进程通信(IPC)需要通过管道(Pipe)或队列(Queue)进行 pickle 序列化与反序列化,传输超大对象时会有不可忽视的性能损耗。
3. asyncio(异步协程):单线程事件循环与协作调度
asyncio 采用完全不同的非阻塞 I/O 驱动范式。它在单一操作系统线程内运行一个事件循环(Event Loop),通过协程(Coroutine)实现微观并发。与操作系统抢占式调度不同,协程是协作式调度的:一个协程必须通过 await 关键字主动交出控制权,事件循环才能去执行下一个就绪的协程。
优势:无需系统线程上下文切换的内核开销,协程对象仅消耗极少内存(数 KB),在一台普通服务器上轻松维持上万个并发连接。
缺陷:属于“传染性”架构,全链路必须使用异步库;如果协程内部出现任何一个耗时较长的 CPU 计算或同步阻塞调用(如 time.sleep(5) 或 requests.get()),整个事件循环都会被挂起,其余所有协程都会被同时卡住。
三、核心代码实现与实战对比
为了直观展现差异,我们在一致的业务情境下提供三组标准化的代码模式。优先推荐使用 Python 标准库中的高级抽象 concurrent.futures 与结构化协程 API,以提升代码的健壮性与可维护性。
1. I/O 密集型场景:ThreadPoolExecutor(推荐多线程方案)
直接创建裸 threading.Thread 容易导致线程数量失控,更推荐使用 concurrent.futures.ThreadPoolExecutor 线程池来管理生命周期。
import concurrent.futures
import time

def fetch_data(site_id: int) -> dict:
    # 模拟网络 I/O 延迟
    time.sleep(0.5)
    return {"site_id": site_id, "status": "success"}

def run_threads():
    sites = list(range(1, 21))
    # 创建容纳 5 个工作线程的线程池
    with concurrent.futures.ThreadPoolExecutor(max_workers=5) as executor:
        # submit 提交异步任务并返回 Future 对象
        futures = [executor.submit(fetch_data, site_id) for site_id in sites]
        for future in concurrent.futures.as_completed(futures):
            result = future.result()
            print(f"[线程池完成] 抓取结果: {result}")

if __name__ == '__main__':
    run_threads()
2. CPU 密集型场景:ProcessPoolExecutor(多进程方案)
对于大批量重度计算,使用 ProcessPoolExecutor 能够自动将任务分发给系统各个物理核。注意:在 Windows 和 macOS 平台,多进程脚本必须置于 if __name__ == '__main__': 保护块之下,防止子进程重复加载主模块引发递归创建崩溃。
import concurrent.futures
import math

def heavy_computation(number: int) -> int:
    # 模拟密集的数学因数分解或计算
    count = 0
    for i in range(1, number):
        count += int(math.sqrt(i))
    return count

def run_processes():
    numbers = [8000000 + i for i in range(8)]
    # 默认进程数通常等于本机 CPU 逻辑核心数
    with concurrent.futures.ProcessPoolExecutor() as executor:
        results = executor.map(heavy_computation, numbers)
        for num, res in zip(numbers, results):
            print(f"[进程池计算] 数值 {num} 结果: {res}")

if __name__ == '__main__':
    run_processes()
3. 超高并发网络场景:asyncio 与 aiohttp(异步协程方案)
当并发请求数达到数百甚至数千时,多线程会因为线程栈内存与内核调度开销耗尽资源。此时,asyncio 展现出无可比拟的吞吐优势:
import asyncio

async def fetch_async(client_id: int):
    # 模拟非阻塞网络 I/O
    await asyncio.sleep(0.5)
    return f"客户端 {client_id} 响应成功"

async def main():
    # 创建 500 个并发异步任务
    tasks = [fetch_async(i) for i in range(1, 501)]
    # 使用 gather 并发执行并等待全部返回
    results = await asyncio.gather(*tasks)
    print(f"[asyncio] 成功并发完成 {len(results)} 个请求")

if __name__ == '__main__':
    # Python 3.7+ 启动异步入口的标准方法
    asyncio.run(main())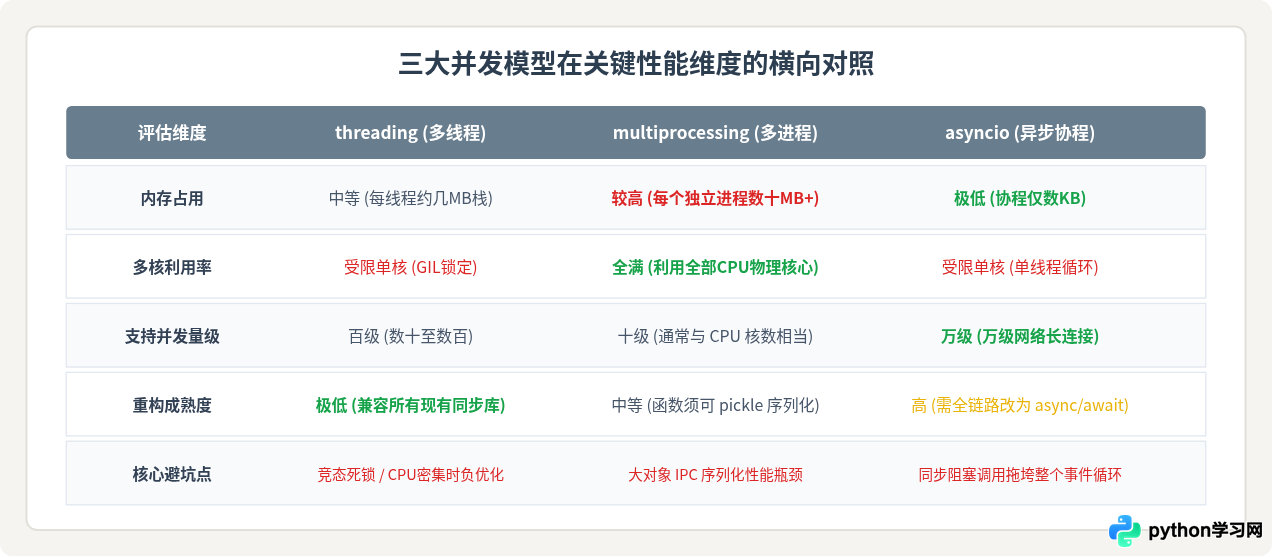
四、选型实践与常见踩坑清单
在真实项目中,许多系统并非非黑即白,以下是针对常见选型困境与工程落地时的明确应对方案:
1. 现有项目是传统同步代码,该用 threading 还是 asyncio?
明确结论:首选 threading。
如果项目中广泛使用了 requests、SQLAlchemy、传统文件 I/O 或只提供同步接口的第三方 SDK,将其强行改写为 asyncio 意味着需要替换为 httpx、asyncpg 等对应异步驱动,所有上层函数调用链均需要增加 async 和 await。如果当前并发量仅在几十到数百之间,改造成本远超收益。使用 ThreadPoolExecutor 只需包裹目标调用,几行代码即可获得数倍的 I/O 加速。
2. 既有异步事件循环,又必须调用同步耗时库怎么办?
如果系统整体基于 asyncio(如 FastAPI 或 Tornado),但必须调用一个耗时的阻塞函数(如生成 PDF、图片裁剪或调用同步 SDK),绝不能直接在协程中调用,否则会导致全局卡死。正确的做法是将同步函数委托给后台执行:
- Python 3.9+ 推荐写法:
await asyncio.to_thread(sync_function, arg1, arg2)。该方法会在后台线程池中运行该同步函数,同时保证主事件循环继续平稳处理其他网络请求。 - 更早版本写法:
await loop.run_in_executor(None, sync_function, arg1)。
3. 遇到混合负载:既有高并发接口,又有复杂计算
对于混合型应用(如 Web 服务接收高并发 HTTP 请求,收到请求后需要运行人脸识别或机器学习推断),最佳实践是组合使用:以 asyncio 处理外层高并发网络接入,计算部分通过 loop.run_in_executor(process_pool, compute_func) 派发给预热好的 ProcessPoolExecutor 进程池,兼得异步网络的高吞吐与多核 CPU 的强算力。
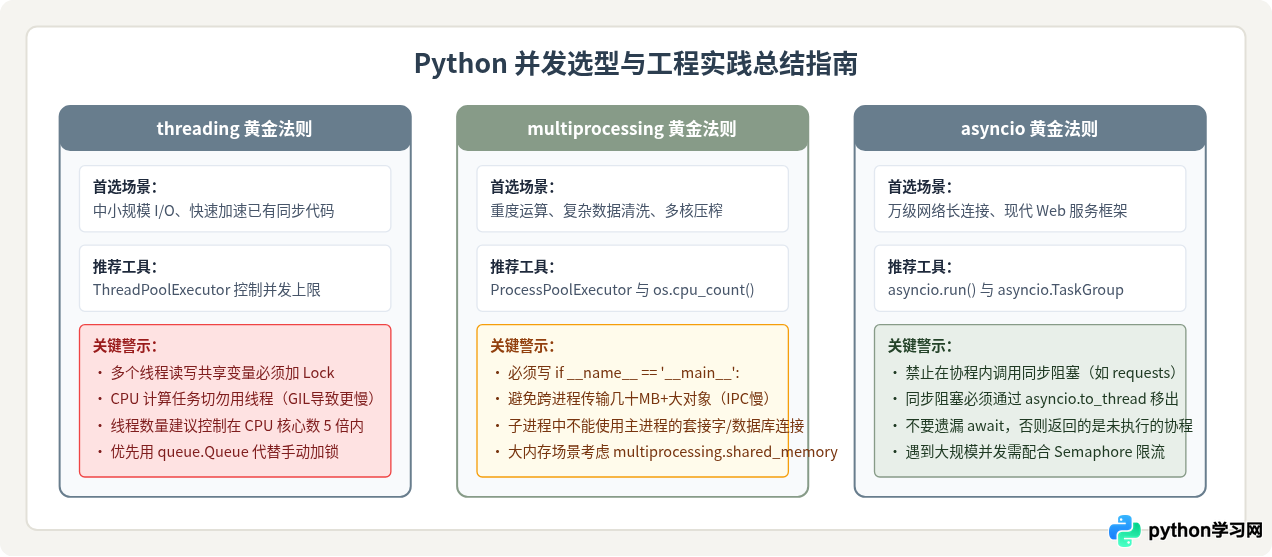
总结:三句话选型决策法则
- 需要压榨多核算力的计算任务:直接选用
multiprocessing(或ProcessPoolExecutor),这是绕开 GIL、利用多核处理器的唯一标准库解法。 - 万级并发长连接或全链路异步新项目:坚定选择
asyncio配套异步生态(如 FastAPI、aiohttp、httpx),以极低的内存和线程切换开销换取极致吞吐量。 - 常规 I/O 任务或基于既有同步代码库:果断选用
threading(推荐ThreadPoolExecutor),兼顾极低的迁移成本、直观的编程思维与充足的 I/O 并发加速效果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















