


Python内置函数速查表:参数说明、返回值及典型应用场景
全面整理Python常用内置函数速查指南,涵盖类型转换、数值计算、序列操作、作用域内省及输入输出等核心函数,提供详细参数说明、返回值规范、典型应用代码与避免陷阱指南。
Python 在启动解释器时会自动加载 builtins 模块,提供无需额外 import 即可直接调用的内置函数。本文将近 70 个高频内置函数按功能分类拆解,系统梳理其核心参数、返回值特性、底层行为与典型生产代码范例,并提供场景选型决策图与避坑排查方案,帮助开发者快速写出规范、高效的 Python 代码。
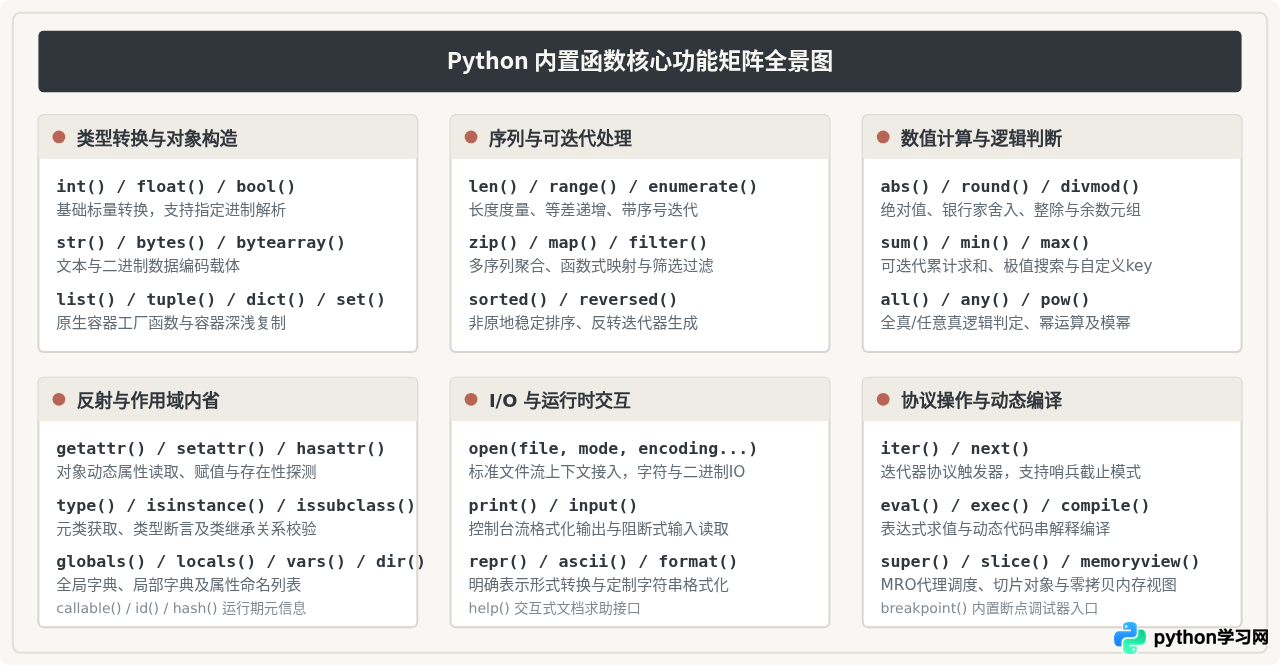
一、数据类型转换与对象构造函数
类型转换函数不仅负责将标量数据在整型、浮点型和字符串之间流转,同时也作为核心容器类的工厂构造器使用。这类函数的共同特性是:若不传参数,通常返回该类型的默认空值(例如 int() 返回 0,list() 返回 [])。
| 函数签名 | 核心参数说明 | 返回值类型 | 典型场景与注意事项 |
|---|---|---|---|
int(x=0, base=10) |
x: 字符串或数值;base: 进制数 (2~36) |
int |
字符串转进制整数。若 x 为浮点数,直接截断小数部分而非四舍五入。 |
float(x=0.0) |
x: 字符串或整数 |
float |
支持 "inf"、"-inf"、"nan" 字符串解析。 |
bool(x=False) |
x: 任意 Python 对象 |
bool |
基于对象的 __bool__() 或 __len__() 判定真假。0、空集合、None 返回 False。 |
str(object='') |
object: 目标对象;encoding, errors (针对 bytes) |
str |
返回适合人类可读的字符串形式;底层调用对象的 __str__()。 |
list(iterable=()) |
iterable: 可迭代容器或生成器 |
list |
将惰性流或元组具象化为可变列表;创建已有列表的一维浅拷贝。 |
tuple(iterable=()) |
iterable: 可迭代容器 |
tuple |
将数据固定为不可变元组,用于字典键或函数入参保护。 |
dict(**kwarg / mapping) |
键值对映射或 (key, value) 二元组序列 |
dict |
快速组装哈希表。例:dict(zip(keys, values))。 |
set(iterable=()) |
iterable: 元素需全部为可哈希对象 |
set |
去除重复项或进行集合代数运算(并集、交集、差集)。 |
典型应用代码
# 1. 进制解析与二进制转换
hex_str = "0x2A"
val = int(hex_str, 16)  # 返回 42

# 2. 构造唯一且保持次序的数据列表(结合字典特性)
raw_tags = ['python', 'web', 'python', 'backend', 'api']
unique_tags = list(dict.fromkeys(raw_tags))  # ['python', 'web', 'backend', 'api']

# 3. 浮点边界处理
import math
positive_infinity = float("inf")
assert math.isinf(positive_infinity) is True
二、数值计算与逻辑判断函数
数学计算类内置函数位于底层 C 实现层,在纯 Python 逻辑中执行效率显著高于手动编写的 Python 循环。使用时需要特别注意浮点数舍入规则与空迭代边界情况。
| 函数签名 | 核心参数说明 | 返回值类型 | 关键机制与应用 |
|---|---|---|---|
abs(x) |
x: 整数、浮点数或复数 |
int / float |
返回绝对值。若 x 为复数,返回其模长(等价于 math.hypot(x.real, x.imag))。 |
round(number, ndigits=None) |
ndigits: 保留小数位数(可为负数) |
int / float |
银行家舍入法(四舍六入五成双)。round(2.5) == 2,round(3.5) == 4。 |
divmod(a, b) |
a: 被除数,b: 除数 |
tuple(q, r) |
返回 (a // b, a % b)。在分页计算、时分秒换算时可一次完成两项运算。 |
sum(iterable, start=0) |
start: 累加基准初值(不能是字符串) |
数值类型 | 累加序列。若需要拼接字符串请使用 "".join(),不可用 sum()。 |
min(arg1, arg2, *args, key=None)max(...) |
iterable 或散列参数;key: 比较权重单参数函数;default: 空序列兜底 |
元素自身类型 | 寻找极值。传 default 参数可避免空可迭代对象抛出 ValueError。 |
all(iterable) |
iterable: 待测元素容器 |
bool |
所有元素为真时返回 True。空容器直接返回 True(空真概念)。具备短路特性。 |
any(iterable) |
iterable: 待测元素容器 |
bool |
任一元素为真即返回 True。空容器直接返回 False。具备短路特性。 |
典型应用代码
# 1. 结构化分页计算
total_records = 105
page_size = 20
pages, remainder = divmod(total_records, page_size)
total_pages = pages + (1 if remainder > 0 else 0)  # total_pages = 6

# 2. 结合 key 与 default 进行安全求值
users = [
    {"name": "Alice", "score": 85},
    {"name": "Bob", "score": 92},
    {"name": "Charlie", "score": 78}
]
top_student = max(users, key=lambda u: u["score"], default=None)

# 3. 权限与状态短路断言
permissions = [True, True, False]
has_any_access = any(permissions)  # True
has_full_access = all(permissions)  # False
三、序列与可迭代对象处理函数
Python 高性能代码的核心在于利用迭代器(Iterator)避免不必要的内存开销。许多内置函数返回的是惰性求值对象,仅在被循环或显式转化(如 list())时才逐个产生数据。
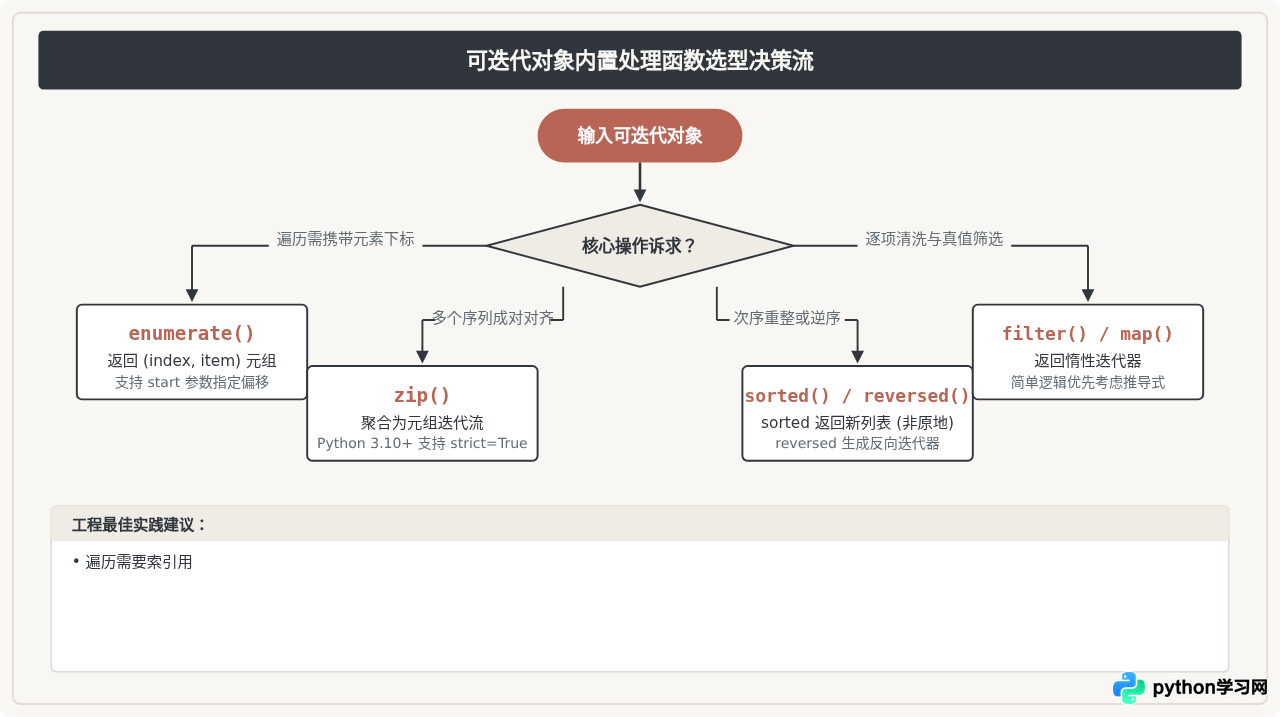
| 函数签名 | 核心参数说明 | 返回值类型 | 典型场景与注意事项 |
|---|---|---|---|
len(s) |
s: 序列或映射 |
int |
调用内部 __len__()。由于内置对象维护有长度属性,其时间复杂度为 $O(1)$。生成器不支持 len()。 |
range(stop)range(start, stop[, step]) |
start (默认0), stop (开区间不含), step (步长) |
range 对象 |
不可变惰性数值序列,无论区间多大仅占用固定微量内存。支持索引、切片及成员运算 in。 |
enumerate(iterable, start=0) |
iterable: 数据流;start: 起始下标索引 |
enumerate 迭代器 |
输出 (index, item) 元组。打印报表行号时可设置 start=1。 |
zip(*iterables, strict=False) |
可变参数:多个可迭代对象;strict: 长度严格一致性检查 |
zip 迭代器 |
并行打包数据。默认以最短输入截断;Python 3.10+ 建议开启 strict=True 以防意外截断。 |
sorted(iterable, /, *, key=None, reverse=False) |
key: 排序权重单入参函数;reverse: 是否倒序 |
新 list |
采用稳定高效的 Timsort 算法,原输入对象内容保持不变(与 list.sort() 原地修改相对)。 |
reversed(seq) |
seq: 实现了 __reversed__() 或具有长度及整数索引的对象 |
反向迭代器 | 不分配新列表空间,直接以反向步进返回元素。 |
filter(function, iterable) |
function: 判定布尔函数(传 None 则保留真值项) |
filter 迭代器 |
按条件逐项筛除元素。生产中常等价替代为 (x for x in seq if cond(x))。 |
map(function, *iterables) |
function: 转换函数;后接一个或多个数据序列 |
map 迭代器 |
将函数逐项施加在元素上。若提供多个序列,函数须接收对应数量的形参。 |
典型应用代码
# 1. 结构化矩阵转置
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]
transposed = [list(row) for row in zip(*matrix)]
# 结果: [[1, 4, 7], [2, 5, 8], [3, 6, 9]]

# 2. 多维度复杂排序
records = [
    ("Alice", 90, 25),
    ("Bob", 85, 23),
    ("Charlie", 90, 21)
]
# 优先按分数降序(-x[1]),分数相同按年龄升序(x[2])
sorted_records = sorted(records, key=lambda x: (-x[1], x[2]))

# 3. 严格配对与字典构建
keys = ["host", "port", "database"]
values = ["127.0.0.1", 5432, "master_db"]
config = dict(zip(keys, values, strict=True))
四、反射与作用域内省函数
内省(Introspection)是 Python 动态语言特性的基石。反射函数允许程序在运行时动态探查对象属性、校验类型归属、检索局部与全局命名空间,常用于插件体系、ORM 框架与依赖注入容器的设计中。
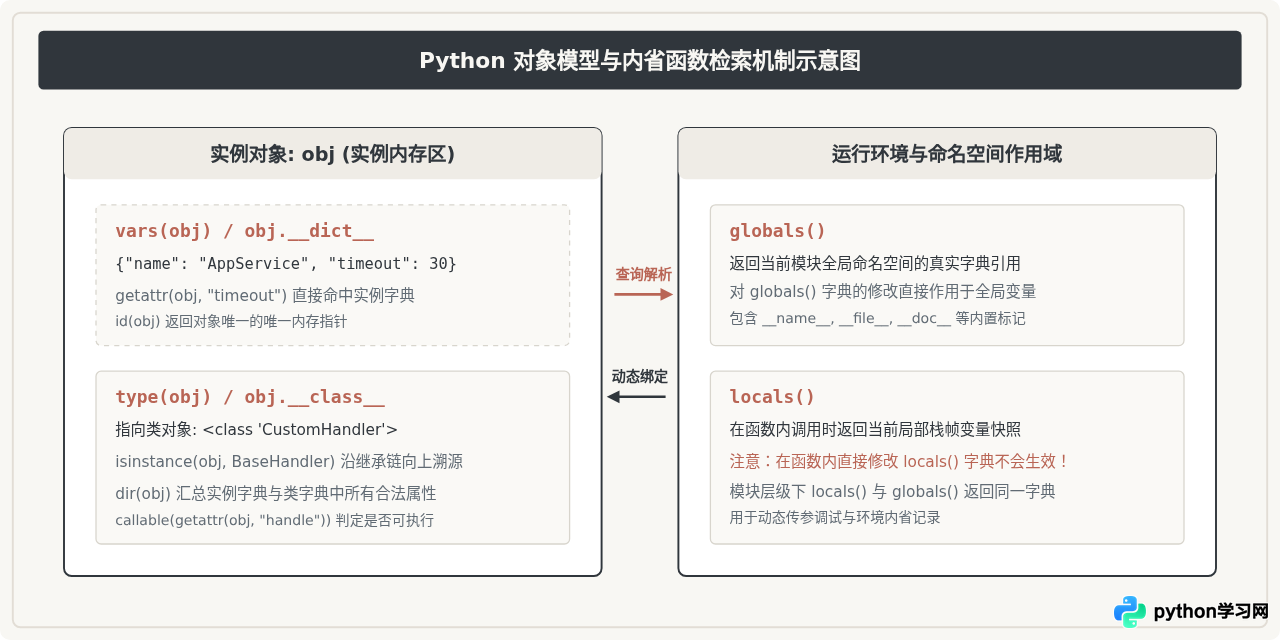
| 函数签名 | 核心参数说明 | 返回值类型 | 机制解析与工程建议 |
|---|---|---|---|
getattr(obj, name[, default]) |
name: 属性名字符串;default: 缺失默认值 |
属性值 | 安全反射。传 default 可抑制 AttributeError,实现优雅降级。 |
setattr(obj, name, value) |
name: 字符串;value: 赋给属性的新值 |
None |
动态为对象装配属性或打桩打补丁(Monkey Patching)。 |
hasattr(obj, name) |
name: 属性名字符串 |
bool |
内部通过调用 getattr 并捕获 AttributeError 实现。 |
isinstance(obj, class_or_tuple) |
class_or_tuple: 目标类型或类型元组 |
bool |
支持继承链校验。若子类继承基类,判定结果仍为 True(优先于 type(obj) is Cls)。 |
issubclass(class, classinfo) |
待验证类对象及目标基类 | bool |
校验类型之间的继承继承关系,第一个参数必须是类,传入实例会报 TypeError。 |
callable(object) |
object: 待判定目标 |
bool |
判断对象是否可调用(是否是函数、类、或实现了 __call__() 的实例)。 |
id(object) |
object: 任意目标 |
int |
返回对象生命周期内唯一的整数内存标识(CPython 下为虚拟内存地址)。用于 is 恒等对比。 |
典型应用代码
# 1. 动态调度插件或路由方法
class EventHandler:
    def on_click(self, event):
        return f"Clicked: {event}"

handler = EventHandler()
action_name = "click"
method_name = f"on_{action_name}"

# 安全获取并调用
method = getattr(handler, method_name, None)
if callable(method):
    result = method({"x": 10, "y": 20})

# 2. 严谨的类型边界断言
class CustomList(list):
    pass

data = CustomList([1, 2, 3])
# 推荐做法:继承多态友好
assert isinstance(data, list) is True
# 不推荐:强类型单点锁死,阻断了派生拓展
assert (type(data) is list) is False
五、I/O 操作与运行控制函数
标准输入输出与文件流控制是程序与外部物理世界交换数据的枢纽。在实际生产部署中,需要对字符编码、输出缓冲刷新以及异常退出保持足够的掌控。
| 函数签名 | 核心参数说明 | 返回值类型 | 关键选项与安全规范 |
|---|---|---|---|
open(file, mode='r', buffering=-1, encoding=None...) |
mode: 模式 (r, w, a, b, +);encoding: 字符集 (建议显式传 'utf-8') |
文件流对象 | 生产环境必须显式指定 encoding='utf-8',严禁依赖系统平台默认编码;必须使用 with 上下文管理器确保资源释放。 |
print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False) |
sep: 分隔符;end: 结尾符;file: 目标流;flush: 是否强制刷新缓冲 |
None |
容器或后台管道日志输出时,若需要即时查看,需设置 flush=True。通过 file=sys.stderr 可将错误流分流。 |
input([prompt]) |
prompt: 终端交互提示语 |
str |
读取一行输入,自动剥除结尾换行符。遇到 EOF 时触发 EOFError。 |
repr(object) |
object: 目标对象 |
str |
返回供开发者调试排查的规范字符串,尽量满足 eval(repr(obj)) == obj 的准则。 |
典型应用代码
import sys

# 1. 生产级安全文本读写模板
file_path = "app_config.json"
try:
    with open(file_path, mode="r", encoding="utf-8") as f:
        content = f.read()
except FileNotFoundError:
    print(f"[ERROR] 配置文件未找到: {file_path}", file=sys.stderr, flush=True)

# 2. 定制格式与重定向日志
metrics = {"cpu": 24.5, "mem": 68.2}
print("METRIC", "SYSTEM", metrics, sep=" | ", end="\n", file=sys.stdout)
六、高频内置函数避坑排查与场景对照
由于部分内置函数具有隐式行为(例如短路计算、多态继承判定、单次消耗迭代器等),如果理解不深刻,很容易引入隐蔽的生产 Bug。下表总结了最易出错的 4 个典型场景及解决方案:
技术要点归纳:熟练掌握内置函数不仅可以减少重复造轮子的工作量,更能通过底层的 C 级加速提升执行效率。在工程实践中,建议对数据长度要求严苛的场景启用 zip(..., strict=True);在做类型分支处理时始终优先使用 isinstance() 而非 type();对于迭代产物,如果后续流程需要多次使用,务必及时物化为 list 或 tuple 避免重复计算或数据耗尽。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















