


Python列表索引基础:正向取值与负数下标用法
系统讲解Python列表索引的核心机制,涵盖正向0基索引寻址、负数倒序下标原理、数学换算关系、边界溢出防御及实操场景对比。
一、双向索引模型与存储映射原理
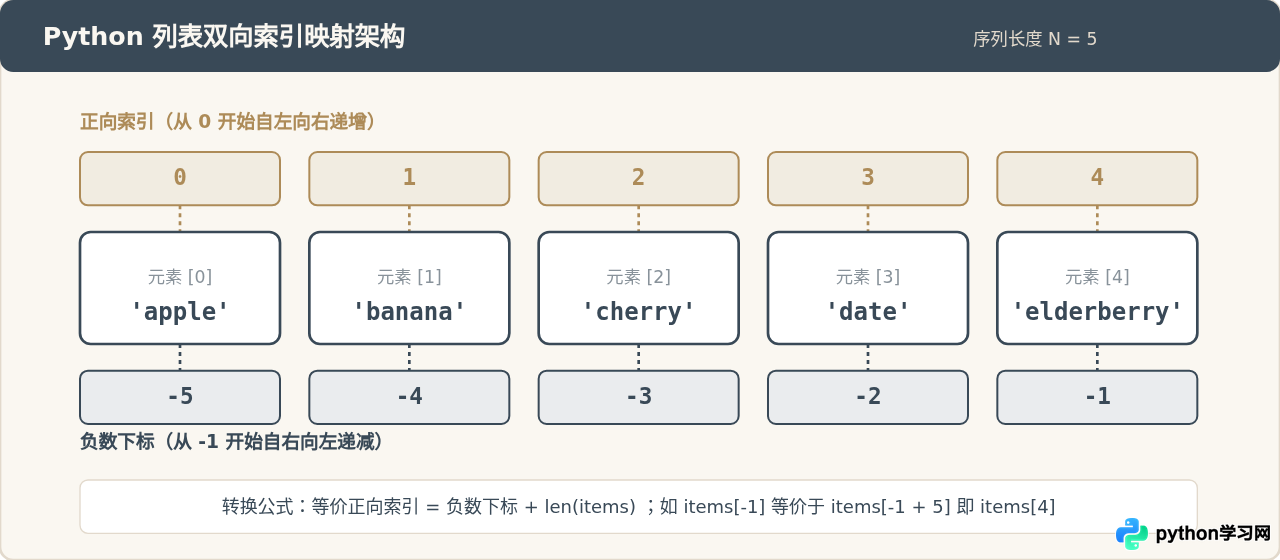
Python列表内部基于连续内存指针数组实现。每个存储槽位(Slot)在逻辑上具备两个互相对称的坐标标识:一个是从左向右的正向索引(Positive Index),另一个是从右向左的负数下标(Negative Index)。
假设列表包含 N 个元素,其正向索引的合法有效范围是 [0, N-1],而负数下标的合法有效范围是 [-N, -1]。对于同一个存储单元,负数下标与其等价正向索引满足明确的数学转换关系:正向索引 = 负数下标 + 列表长度。当解释器接收到负数下标时,会在底层自动将其加上序列长度,将其归一化为非负偏移量后再执行指针寻址。
二、正向索引取值:基础用法与代码实践
正向索引采用标准的 0 基寻址(Zero-based Indexing)。这意味着序列中首个元素的偏移量为 0,第二个元素偏移量为 1,以此类推。使用方括号 [] 配合非负整数即可获取指定槽位的元素。
# 示例:正向索引基本取值
fruits = ['apple', 'banana', 'cherry', 'date', 'elderberry']

first_item = fruits[0]     # 获取第一个元素: 'apple'
second_item = fruits[1]    # 获取第二个元素: 'banana'
last_item = fruits[4]      # 获取第五个元素: 'elderberry'

print("首项:", first_item)
print("次项:", second_item)
print("末项:", last_item)
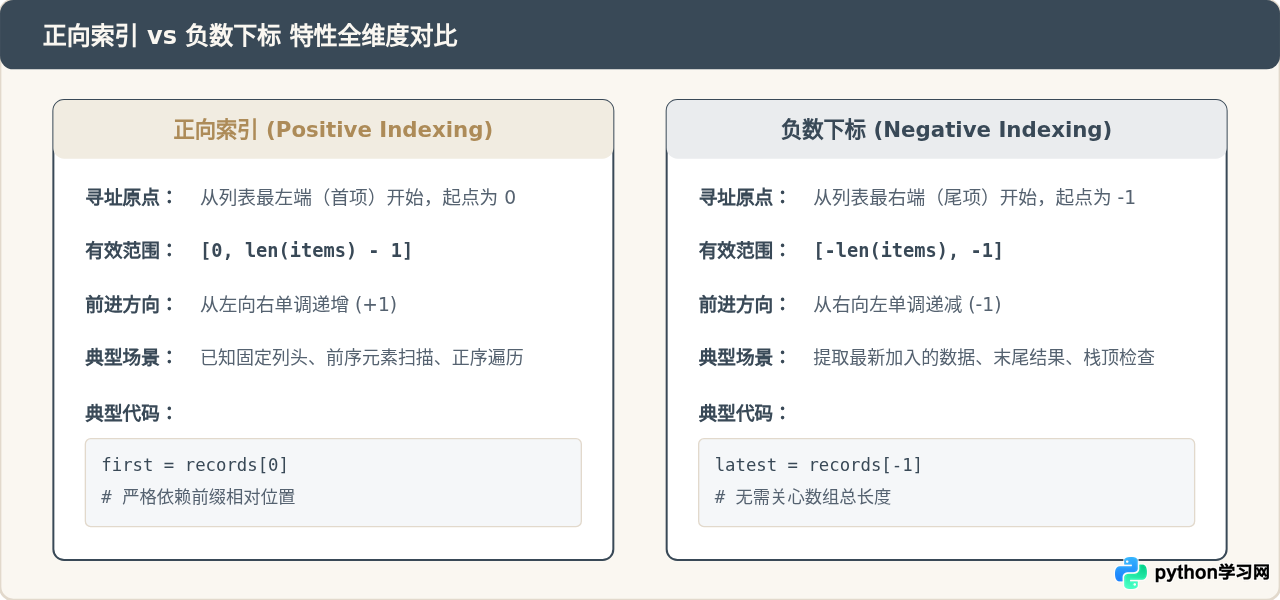
在工程开发中,正向索引最适合用于“确定从序列头部向后偏移固定距离”的业务逻辑。例如解析具有固定格式的表格行、CSV 数据列或固定的协议头字段。
三、负数下标取值:倒序检索机制与优势
在许多编程语言(如 C 或 Java 原生数组)中,如果需要获取序列的最后一个元素,通常必须显式计算长度:array[array.length - 1]。这种写法不仅繁琐,而且多次调用 len() 会增加代码冗余。
Python 提供了原生的负数下标语法,直接将倒数第一项定义为 -1,倒数第二项定义为 -2。负数索引消除了显式书写 len() 的需要,极大提升了代码的可读性与简洁度。
# 示例:负数下标常用操作
log_records = ['LOGIN', 'AUTH_OK', 'FETCH_DATA', 'UPDATE_PROFILE', 'LOGOUT']

current_action = log_records[-1]    # 倒数第1项 (最新事件): 'LOGOUT'
previous_action = log_records[-2]   # 倒数第2项 (前置事件): 'UPDATE_PROFILE'
earliest_action = log_records[-5]   # 倒数第5项 (初始事件): 'LOGIN'

print("最近操作:", current_action)
print("倒数第二项:", previous_action)-1 而不是 -0。在数学与计算机表示中,-0 等同于 0,因此 items[-0] 返回的依然是序列首项 items[0],无法表示倒数第一个元素。
四、标准取值操作与安全防范流程
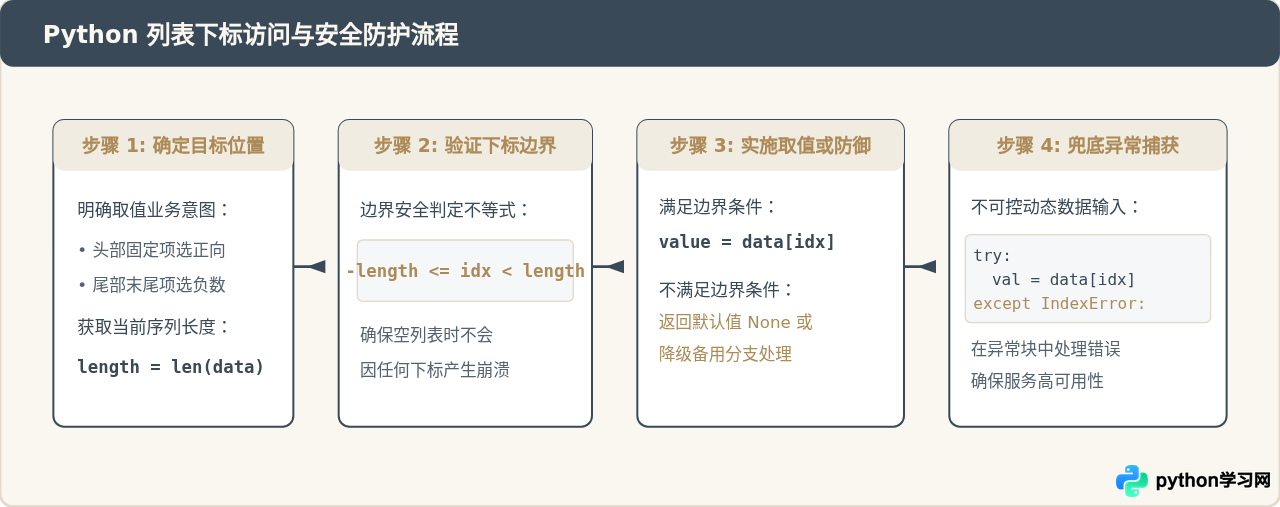
无论采用正向索引还是负数下标,直接下标访问都是一种“硬访问”。一旦传入的下标超出了列表的有效索引区间,Python 解释器将立刻抛出 IndexError: list index out of range 异常并中断程序执行。
为了保障生产代码的稳健运行,开发者应当建立标准化的元素检索检查流程。
边界检查与异常捕获对比示例
在实际编码中,针对边界越界问题主要有两种应对方案:预先长度判定(LBYL)与异常捕获(EAFP)。
# 方案一:预先检查长度(Look Before You Leap)
def safe_get_by_check(items, index, default=None):
    if not items:
        return default
    # 统一验证是否处于合法正负区间内
    if -len(items) <= index < len(items):
        return items[index]
    return default

# 方案二:异常捕获机制(Easier to Ask for Forgiveness than Permission)
def safe_get_by_try(items, index, default=None):
    try:
        return items[index]
    except IndexError:
        return default

# 验证测试
test_list = [10, 20, 30]
print(safe_get_by_check(test_list, 1))    # 输出: 20
print(safe_get_by_check(test_list, -1))   # 输出: 30
print(safe_get_by_check(test_list, 5))    # 输出: None(未发生崩溃)
print(safe_get_by_try([], 0))             # 输出: None(空列表安全)
五、正向取值与负数下标核心差异对比
正向索引与负数下标虽同属列表的单项访问机制,但二者在心智模型、表达意图和使用场景上存在显著差异。
| 对比维度 | 正向取值 (Positive) | 负数下标 (Negative) |
|---|---|---|
| 起始坐标 | 0(指向第 1 个元素) |
-1(指向最后 1 个元素) |
| 界限极值 | 上界为 len - 1 |
下界为 -len |
| 长度依赖度 | 取末尾项依赖序列长度(需 items[len-1]) |
取末尾项完全解耦(直接 items[-1]) |
| 空列表行为 | [][0] 抛出 IndexError |
[][-1] 抛出 IndexError |
六、总结与实战速查决策指南
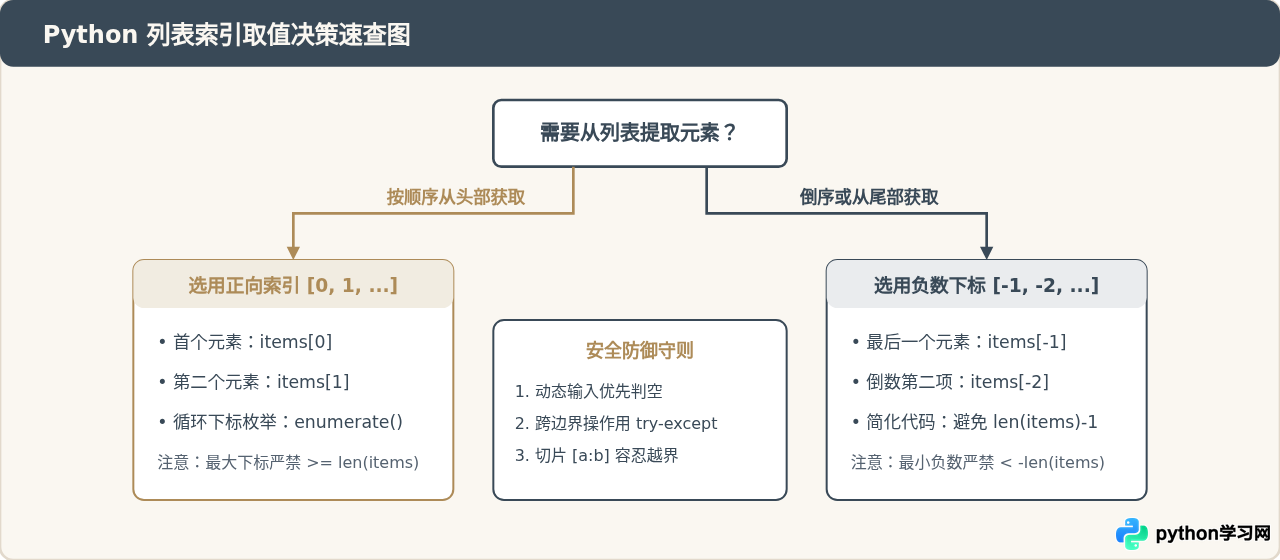
在编写日常业务代码时,根据访问目标的位置特性选择合适的下标形式,能够大幅减少冗余代码并提升系统的健壮性。以下决策图与速查规则可作为工程规范参考。
关键要点回顾
- 0 基寻址:列表起始索引为
0,而非1。获取长度为 N 的列表前部元素时,正向索引范围为0到N - 1。 - 负数下标简洁优雅:以
-1代表末尾元素,底层等价于-1 + len(items)。在需要读取最新插入或尾部元素时,优先使用items[-1]代替items[len(items)-1]。 - 不存在 -0 索引:由于数值上
-0 == 0,因此items[-0]等价于items[0],无法用于反向检索。 - 严格的边界防御:单项索引越界必然触发
IndexError。处理不可控或动态长度数据时,务必结合长度条件判断或try-except IndexError结构确保系统健壮性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















