


Python在线编译器不支持文件下载时的数据获取技巧
针对Python在线编译器没有文件管理界面或禁用下载功能的限制,深入讲解利用内存流对象、Base64编码转换、定界符输出以及本地还原脚本获取数据与文件的完整实用技巧。
在使用轻量级 Python 在线编译器、在线判题系统或竞赛练习沙箱时,环境通常只开放一个标准输出终端,不提供物理磁盘浏览器或文件下载按钮。面对这种限制,最直接有效的解法是:放弃物理写盘,改用 io.BytesIO 等内存流暂存数据,将其编码为可打印的纯文本(如 Base64 字符串或带明确边界标记的 JSON/CSV),通过标准输出打印后,在本地电脑上反向解码为原本的文件。
一、核心思路:把标准输出转化为数据传输通道
很多在线编译器为了运行安全,会开启严格的容器沙箱。除了禁止调用部分系统级命令外,它们往往不开放文件管理面板,甚至对 open('data.csv', 'w') 设置了只读文件系统拦截。即使代码成功把文件写入当前工作目录,由于界面没有“点击下载”或“导出为附件”的入口,容器一旦在运行结束后销毁,生成的文件便随之消失。
虽然物理文件下载被封堵,但所有的在线编译器都必须保留控制台输出通道(stdout),否则用户无法看到运行结果。因此,跨越沙箱壁垒的通用核心路径是:在内存中构建目标文件,将非文本字节转换为 ASCII 字符串,通过 print() 刷入控制台,最后在本地通过脚本或编辑器完成逆向重建。
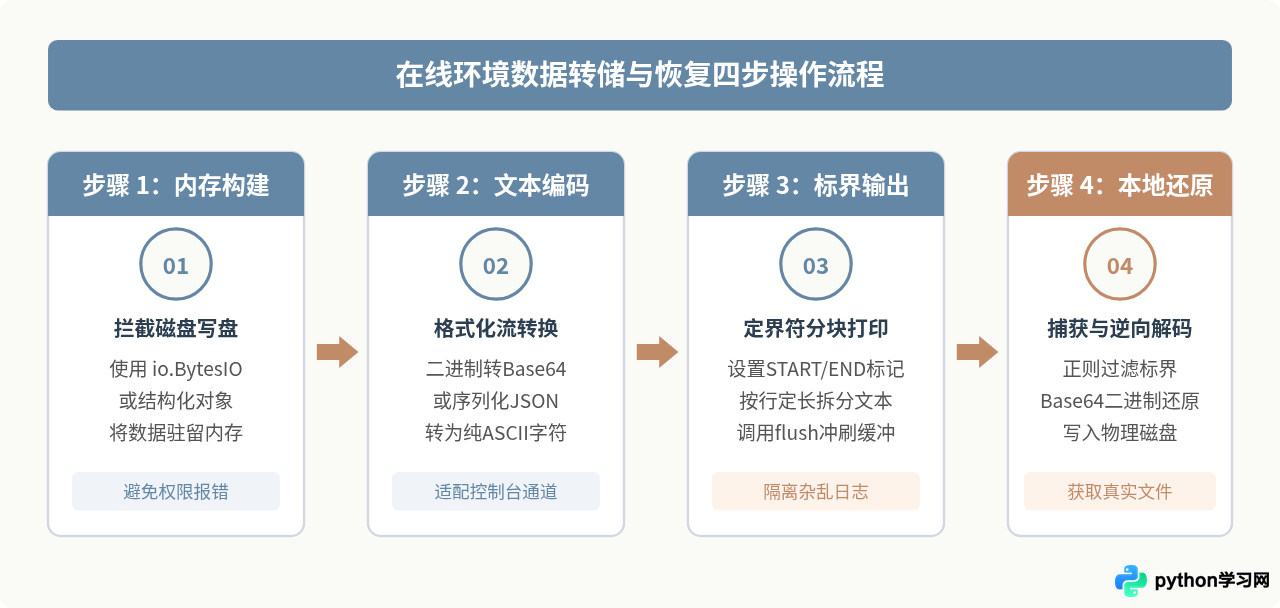
二、结构化纯文本数据的“定界符转储法”
如果程序生成的是表格、统计指标、清洗后的列表或字典数据,直接使用结构化纯文本转储是最简单、零依赖的方案。但在线环境往往伴随解释器输出的提示信息(如警告、耗时或第三方库的初始化日志)。如果直接打印,混杂在一起的输出很难被手动或正则准确提取。
推荐采用“定界符标记法”(Boundary Markers),在核心数据首尾包裹唯一的标记行。以下是在在线编译器中运行的代码示例:
import json
import sys

# 假设这是在线处理后需要导出的结构化数据
data_to_export = [
    {"id": 101, "item": "传感器A", "value": 24.5, "status": "ok"},
    {"id": 102, "item": "传感器B", "value": 26.1, "status": "warning"},
    {"id": 103, "item": "传感器C", "value": 23.8, "status": "ok"}
]

# 序列化为紧凑或格式化的 JSON 字符串
json_content = json.dumps(data_to_export, ensure_ascii=False, indent=2)

# 使用显式边界定界符输出
print("===DATA_PAYLOAD_START===")
print(json_content)
print("===DATA_PAYLOAD_END===")
sys.stdout.flush()
复制控制台文本后,可以直接粘贴到本地文本编辑器中并另存为 .json。若数据量较大或需要自动化,可以在本地执行一段极简脚本直接过滤捕获:
import re

# 将从在线终端复制的内容存入 raw_console.txt
with open("raw_console.txt", "r", encoding="utf-8") as f:
    text = f.read()

# 正则匹配定界符内部的有效数据
match = re.search(r"===DATA_PAYLOAD_START===\s*(.*?)\s*===DATA_PAYLOAD_END===", text, re.DOTALL)
if match:
    with open("extracted_data.json", "w", encoding="utf-8") as out:
        out.write(match.group(1))
    print("数据成功提取并保存至 extracted_data.json")
else:
    print("未找到有效的数据定界标记")
三、二进制文件(图表/Excel/压缩包)的 Base64 内存流转法
当需要导出的不是文本,而是 Matplotlib 生成的数据可视化图表(PNG)、Pandas 导出的 Excel 工作簿(.xlsx)或者打包好的压缩包(.zip)时,文本打印无法直接输出二进制字节,否则会引发编码错误或控制台乱码截断。
此时的标准做法是使用 io.BytesIO 作为虚拟内存磁盘,将数据写入内存缓冲区,然后调用 base64.b64encode() 将全部二进制字节转换为标准 ASCII 字符。
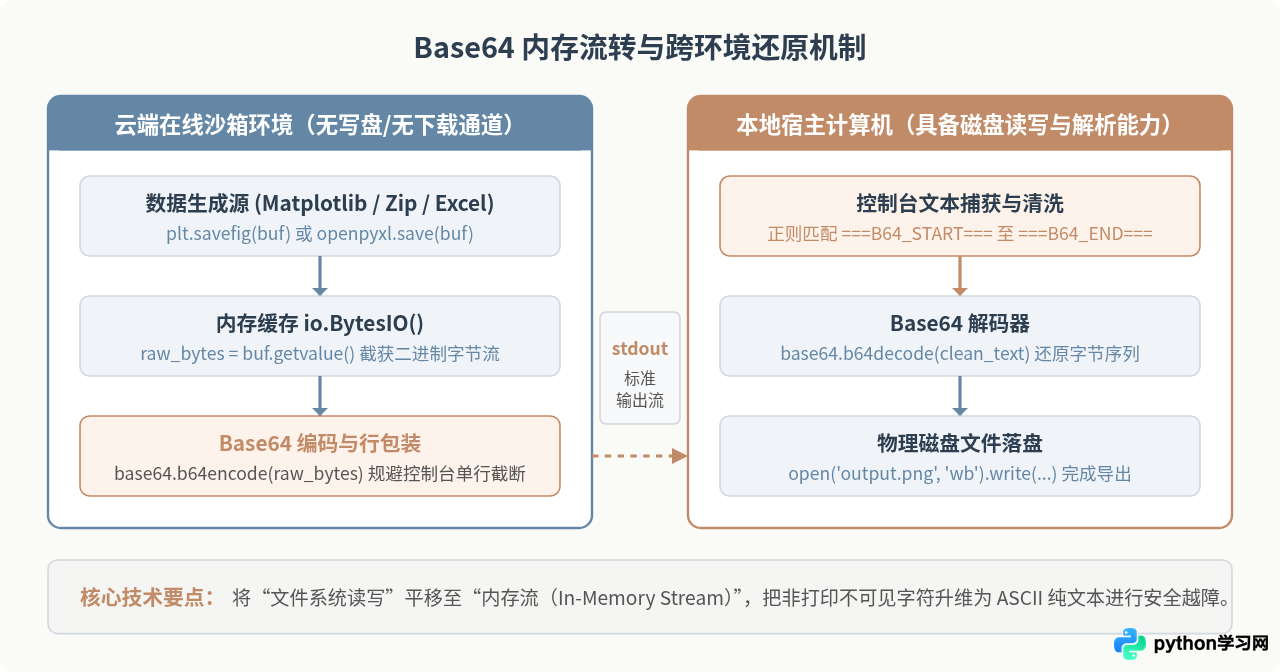
1. 在线端代码:生成图表并以定长切块输出
很多网页端终端对单行最大字符数有限制(例如单行超过 4096 字符会自动折行甚至吞字)。为了保证输出可靠,推荐将 Base64 字符串按照每行 76 或 100 字符进行切片分行打印:
import io
import base64
import sys
import matplotlib.pyplot as plt

# 1. 模拟生成图表
plt.figure(figsize=(6, 4))
plt.plot([1, 2, 3, 4], [10, 20, 25, 30], marker='o', color='#6487A5')
plt.title("Sample Performance Curve")

# 2. 保存到内存缓冲区,不接触物理磁盘
buffer = io.BytesIO()
plt.savefig(buffer, format="png", dpi=100)
buffer.seek(0)

# 3. 读取二进制并转为 Base64 字符串
b64_str = base64.b64encode(buffer.getvalue()).decode("ascii")

# 4. 定长切块打印,防止单行过长被截断
CHUNK_SIZE = 76
print("===B64_FILE_START:chart.png===")
for i in range(0, len(b64_str), CHUNK_SIZE):
    print(b64_str[i:i + CHUNK_SIZE])
print("===B64_FILE_END:chart.png===")

sys.stdout.flush()
2. 本地端代码:一键还原为物理文件
将在线终端包含标记的内容保存至 console.log,运行以下脚本即可直接还原出 chart.png:
import re
import base64

with open("console.log", "r", encoding="utf-8") as f:
    log_content = f.read()

pattern = r"===B64_FILE_START:(.*?)===\s*(.*?)\s*===B64_FILE_END:\1==="
match = re.search(pattern, log_content, re.DOTALL)

if match:
    filename = match.group(1).strip()
    # 过滤掉换行符与空格
    clean_b64 = re.sub(r"\s+", "", match.group(2))
    file_bytes = base64.b64decode(clean_b64)

    with open(filename, "wb") as out_file:
        out_file.write(file_bytes)
    print(f"成功恢复文件:{filename}(文件大小:{len(file_bytes)} 字节)")
else:
    print("未匹配到合法的 Base64 标记块")
四、四种主流获取方案的横向对比与选型
针对不同规模、格式和网络条件的数据,在线环境下的获取方法各具特点。盲目采用复杂方案会增加调试负担,而使用过于简单的方法又可能遭遇体积或截断瓶颈。
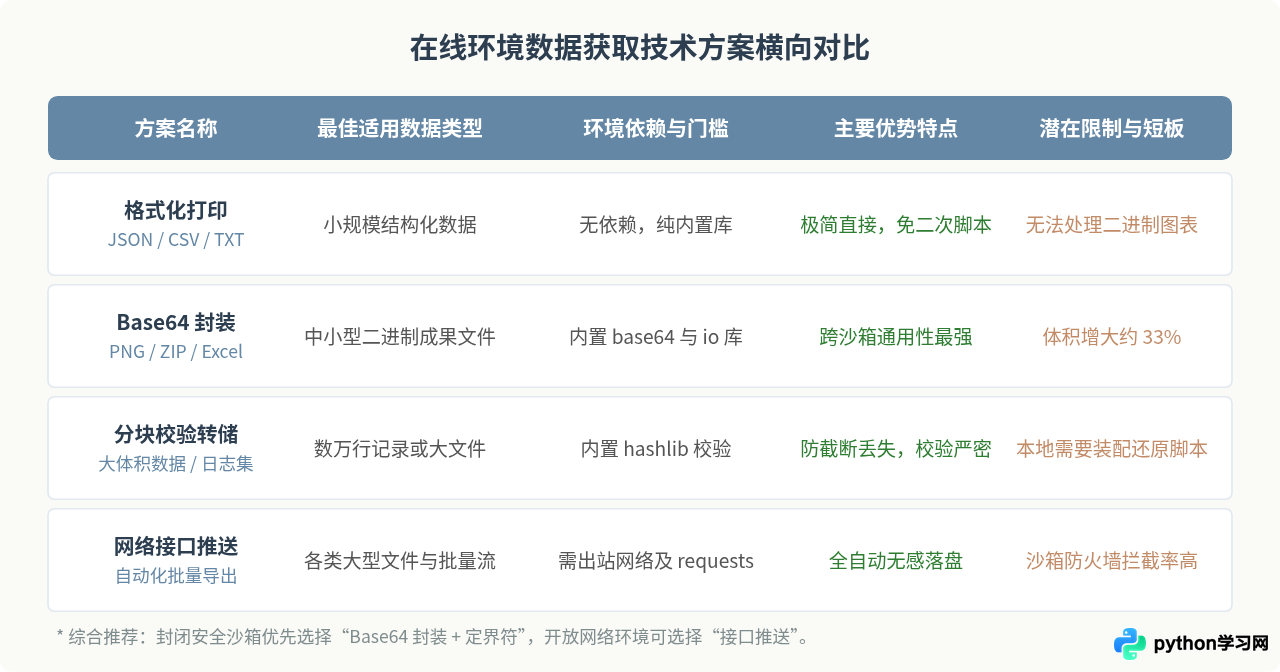
五、大容量数据:zlib压缩与MD5分块校验技巧
在线终端通常有缓冲区大小上限。例如某些平台当单次输出超过 50KB 或 2000 行时,会自动丢弃后续字符(显示 ... Output truncated ...),或者浏览器在渲染超长文本框时直接假死崩溃。
为了在有限配额内塞入更多数据,并且在数据被截断时能立刻察觉,可采用“内置压缩 + 块级哈希校验”策略:
- 使用内置 zlib 压缩: 纯文本或重复率高的数据在压缩后体积通常能缩减 70% 至 90%,大幅降低控制台总输出字符数。
- 加入分块计数与 MD5: 每一个输出块附带
[CHUNK_INDEX:TOTAL_CHUNKS:MD5],本地还原时若发现少了一块,便能明确知道哪一段丢失,而不是在解压报错时毫无头绪。
import zlib
import base64
import hashlib
import sys

raw_data = ("sensor_data_record_line_content_" * 2000).encode("utf-8")

# 1. 内存压缩
compressed_data = zlib.compress(raw_data, level=9)
b64_data = base64.b64encode(compressed_data).decode("ascii")

# 2. 计算完整数据 MD5
total_md5 = hashlib.md5(b64_data.encode("ascii")).hexdigest()

# 3. 按块输出
CHUNK_LEN = 1000
chunks = [b64_data[i:i + CHUNK_LEN] for i in range(0, len(b64_data), CHUNK_LEN)]
total_chunks = len(chunks)

print(f"===CHUNKED_STREAM_START:TOTAL={total_chunks}:MD5={total_md5}===")
for idx, chunk in enumerate(chunks):
    chunk_hash = hashlib.md5(chunk.encode("ascii")).hexdigest()[:8]
    print(f"[CHUNK:{idx+1}/{total_chunks}:{chunk_hash}]{chunk}")
print("===CHUNKED_STREAM_END===")

sys.stdout.flush()
六、开放网络环境:临时接口外发通道
部分在线编译器(如面向数据科学的云端笔记本或允许访问外部 API 的评测机)开放了出站 HTTP 网络连接。如果确认环境支持联网,可以通过内置的 urllib.request 或 requests 库,直接将数据 POST 发送至临时的接收服务(如 RequestBin、Webhook.site 或自建的接收服务器)。
这种方法可以完全绕过控制台的复制粘贴与格式解析,适合自动化批量提取:
import urllib.request
import json

# 准备需要导出的数据
payload = {
    "task": "analysis_result",
    "dataset": [10.2, 15.6, 18.9, 22.4]
}

data_bytes = json.dumps(payload).encode("utf-8")

# 替换为你的临时接收服务端点
target_url = "https://webhook.site/your-unique-uuid"

req = urllib.request.Request(
    target_url,
    data=data_bytes,
    headers={"Content-Type": "application/json"}
)

try:
    with urllib.request.urlopen(req, timeout=10) as response:
        print(f"数据已远程推送,状态码: {response.status}")
except Exception as e:
print(f"网络发送受阻(可能沙箱开启了出站防火墙): {e}")绝大多数编程做题或考试平台的安全策略都会彻底切断外网访问(Egress Block)。在尝试网络外发前,可以先用简单的 urllib.request.urlopen("https://www.baidu.com") 测试连通性。如果返回 Connection Refused 或 Timeout,应立即退回第二、三节介绍的 Base64 与定界符方案。
七、决策与避坑指南
在不同场景下选择合适的方法,可以参考以下决策路径:
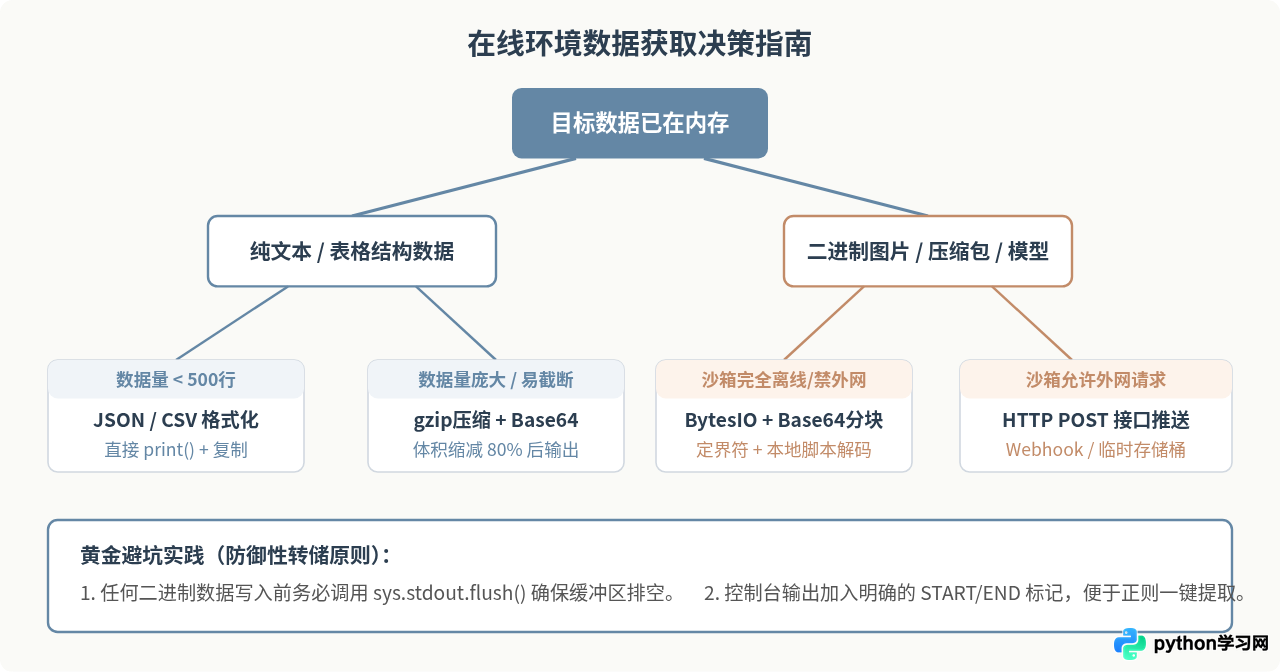
常见细节与避坑点:
- 必须调用
sys.stdout.flush(): 在非交互式沙箱中,标准输出通常采用块缓冲(Block Buffered)而非行缓冲。如果脚本在输出最后几行后立即退出,缓冲区中的尾部数据可能还未推送到前端就被杀进程,导致结尾丢失。显式调用flush()可以确保所有字符进入终端。 - 避免手动换行污染: 复制终端文本时,部分网页前端会将很长的一行自动打断并插入
\r\n或软换行符。在本地解码 Base64 之前,务必使用re.sub(r"\s+", "", raw_text)清除所有空白字符。 - 注意控制台截断提示: 复制前请检查输出文本底部是否包含类似
Output limit exceeded或... Truncated ...的字样。若存在截断,必须降低数据精度、采用 zlib 压缩后再导出,或者分批次多次运行提取。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















