


头歌Python re模块正则匹配难点与解题思路

在头歌(EduCoder)等在线实训平台完成 Python re 模块的评测任务时,很多初学者常常遇到本地运行通过、提交评测却总是扣分或输出不符的问题。这通常不是因为逻辑完全写错,而是由平台内置评测脚本的输出比对机制、关键正则函数的边界判定,以及分组提取与量词贪婪性造成的细节疏漏。本文梳理头歌评测环境中的高频踩坑点,并给出一套清晰可复现的排错与解题流程。
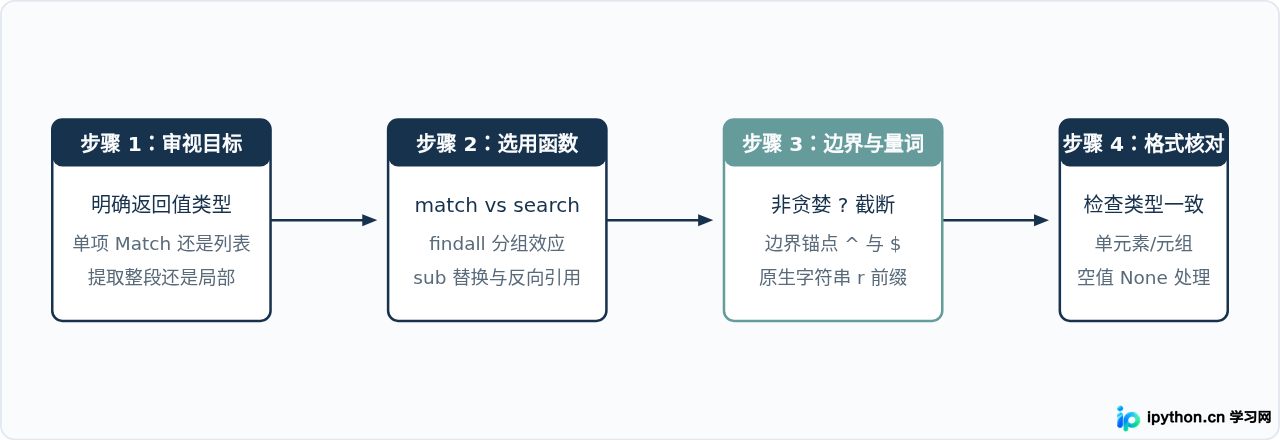
一、难点一:核心函数的匹配机制混淆
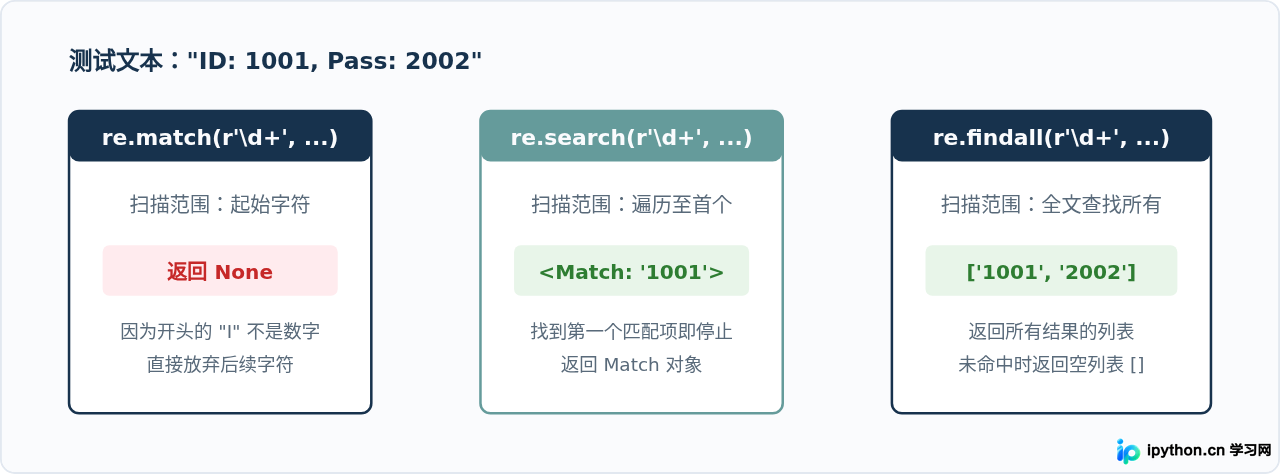
头歌实训题通常会提供一个函数框架让学员填空,或者直接根据标准输出比对结果。re.match()、re.search() 与 re.findall() 是最容易被选错的三大入口函数。
re.match() 仅从目标字符串的起始位置开始匹配。如果起始字符不符合规则,即使中间存在符合条件的内容,它也会立刻返回 None。很多题目要求提取文本内部的一段内容,如果误用 match(),代码将返回空对象,后续调用 .group() 时就会触发 AttributeError: 'NoneType' object has no attribute 'group'。
re.search() 会扫描整个字符串,找到第一个匹配项就返回 Match 对象;而 re.findall() 会扫描整段文本并返回所有匹配结果构成的列表。选择函数时,首先要看题干要求提取的是“首次出现的子串”还是“所有符合条件的集合”。
二、难点二:findall 中捕获括号导致的输出形变
这是头歌评测中最典型的失分陷阱:当正则表达式中使用了小括号 (),re.findall() 的返回规则会发生改变。
如果不加括号,findall() 返回的是完整匹配到的字符串列表。但是,一旦在表达式内部添加了捕获括号,findall() 将只返回括号内所捕获的部分;如果有多个捕获括号,它会返回一个由元组组成的列表 [(group1, group2), ...]。
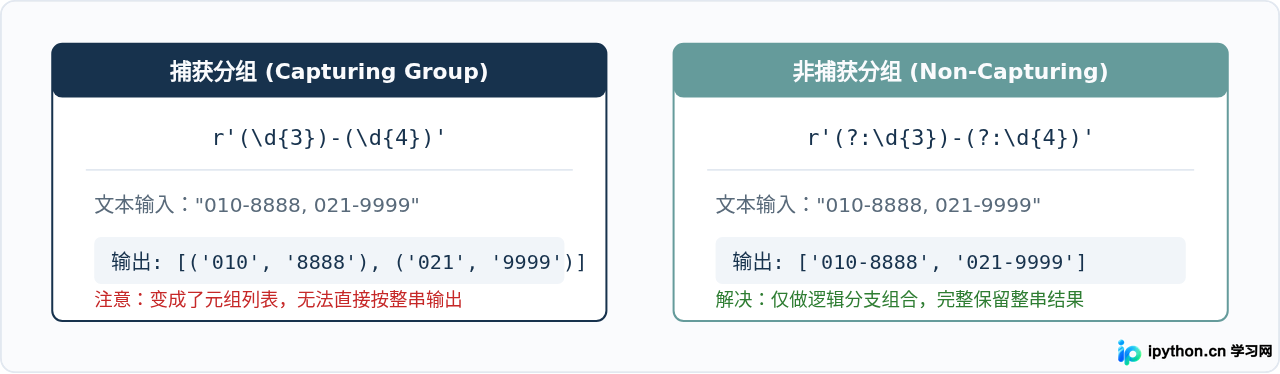
解决思路:如果你只是为了在正则中使用 | 候选分支或量词修饰,而不需要单独拆分字段,请务必使用非捕获分组 (?:...)。例如匹配 HTTP 协议头时,写 (?:https|http):// 而不要写 (https|http)://,否则 findall() 的输出就只剩下协议名,导致平台比对失败。
三、难点三:贪婪匹配与非贪婪截断
在涉及提取网页标签内容、双引号内文本或固定闭合区间(如 <a>...</a>、[...])的题目中,初学者常直接使用 .*。Python 默认处于贪婪模式,量词 * 和 + 会尽可能多地向右“吞掉”字符,直到整行末尾才开始回溯,往往把两个不想关联的标签连同中间内容整体吃掉。
import re

text = '<span>苹果</span><span>香蕉</span>'

# 贪婪模式(错误:跨界匹配到最末尾标签)
res1 = re.findall(r'<span>.*</span>', text)
# 实际输出: ['<span>苹果</span><span>香蕉</span>']

# 非贪婪模式(正确:遇到第一个结束标签即停)
res2 = re.findall(r'<span>(.*?)</span>', text)
# 实际输出: ['苹果', '香蕉']?(如 .*?、.+?),在特定字符闭合场景下,使用排除型字符集 [^<]* 往往比 .*? 更高效且稳定。例如提取双引号内容,写 r'"([^"]*)"' 可以避免多行回溯导致的意外漏检。
四、难点四:转义字符与原生字符串 r 前缀
头歌中常出现提取 Windows 文件路径、带括号的数学表达式或 IP 地址等题目。很多学员在编写正则表达式时没有加 r 前缀,直接写入类似 "\\d+" 的普通字符串。
在 Python 解释器中,普通字符串本身会对 \ 进行一层语法转义,随后传递给 re 引擎时又会被转义一次。如果需要匹配字面量反斜杠 \:
- 未声明原生字符串时,必须书写四个反斜杠:
"\\\\"; - 声明原生字符串时,只需书写两个反斜杠:
r"\\"。
养成书写正则时一律以 r'...' 开头的习惯,可以完全杜绝因 Python 字符串转义层导致的边界符号失效问题。
五、实战排错检查清单与完整用例
当在头歌平台提交代码提示“未通过,实际输出与预期不一致”时,建议按照以下排查表逐项定位问题:
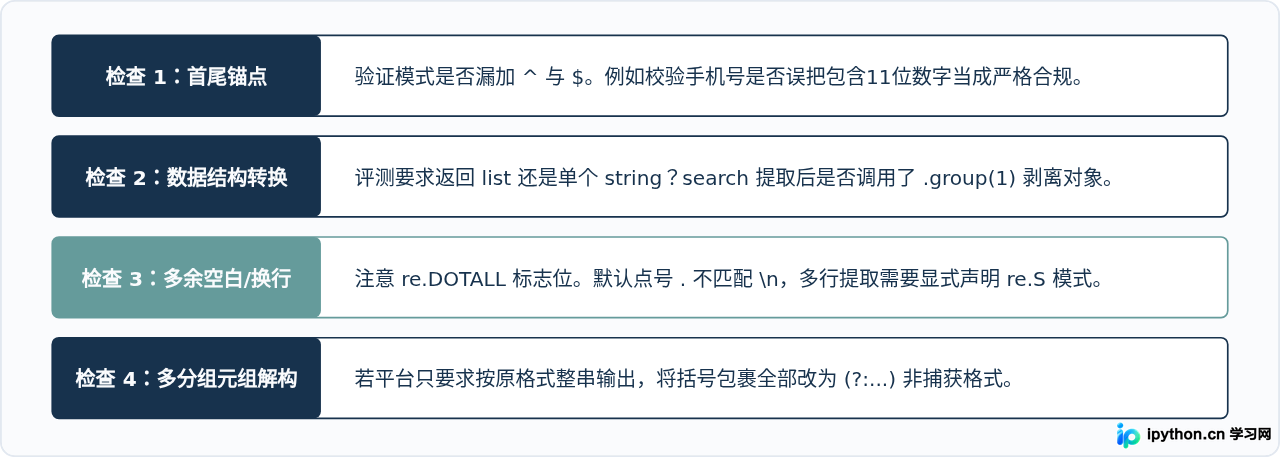
标准实战示例:提取商品名称与单价
假设头歌题目要求:编写函数 parse_goods(log_text),提取文本中类似 [商品: 机械键盘, 单价: 299元] 的所有条目,并以格式化字典列表返回。如果未找到任何符合项,返回空列表。
import re

def parse_goods(log_text):
    # 核心要点:
    # 1. 使用 r 前缀防止转义混淆
    # 2. 对方括号 \[ \] 进行转义
    # 3. 使用非贪婪或排除型字符匹配商品名称
    # 4. 括号提取捕获项,通过 findall 直接产出元组列表
    pattern = r'\[商品:\s*([^,]+?),\s*单价:\s*(\d+)元\]'

    matches = re.findall(pattern, log_text)

    result = []
    for item, price in matches:
        result.append({
            "name": item.strip(),
            "price": int(price)
        })
    return result

# 示例输入测试
raw_data = "系统日志:[商品: 无线鼠标, 单价: 89元] 已出库,[商品: 高清显示器, 单价: 1299元] 正在打包。"
print(parse_goods(raw_data))
# 期望输出: [{'name': '无线鼠标', 'price': 89}, {'name': '高清显示器', 'price': 1299}]
在面对头歌评测时,不要急于一次性拼出过长、过于复杂的单行正则表达式。先看清待测字符串的起止特征,明确需要的是匹配对象还是子串列表,合理运用非捕获分组 (?:) 和非贪婪模式 ?,即可稳定保证每一次提交都能精确匹配预期结果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















