


Python 基本数据结构:列表、元组、集合与字典实战指南

Python 提供了四种内置的基本数据结构:列表(List)、元组(Tuple)、集合(Set)和字典(Dictionary)。它们各自具有独特的特性,适用于不同的数据处理场景。本文将通过具体的代码示例,详细解析这四种数据结构的使用方法、特性以及相关的推导式技巧。
列表(List):灵活多变的数据容器
列表是 Python 中最常用的数据结构之一,它是一个可变序列,支持动态添加、删除和修改元素。与字符串和元组不同,列表的内容可以随时改变。
列表的基本操作
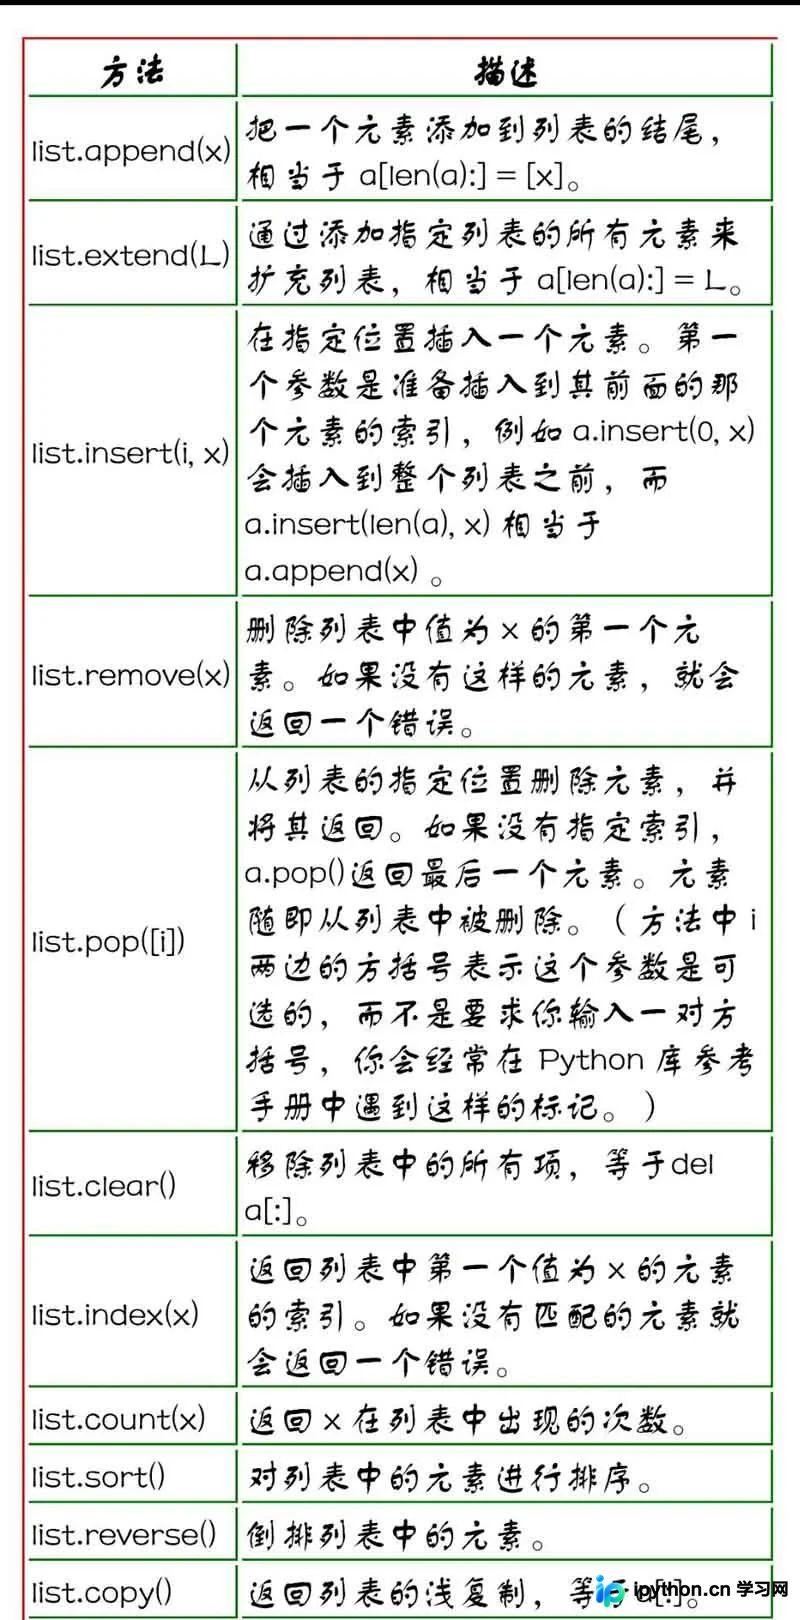
列表提供了丰富的内置方法,用于处理元素。例如,count() 可以统计特定元素出现的次数,insert() 用于在指定位置插入元素,而 append() 则在列表末尾添加元素。需要注意的是,insert、remove 和 sort 这些方法在执行后没有返回值(返回 None),它们直接修改原列表。
>>> a = [66.25, 333, 333, 1, 1234.5]
>>> print(a.count(333), a.count(66.25), a.count('x'))
2 1 0
>>> a.insert(2, -1)
>>> a.append(333)
>>> a
[66.25, 333, -1, 333, 1, 1234.5, 333]
>>> a.index(333)
1
>>> a.remove(333)
>>> a
[66.25, -1, 333, 1, 1234.5, 333]
>>> a.reverse()
>>> a
[333, 1234.5, 1, 333, -1, 66.25]
>>> a.sort()
>>> a
[-1, 1, 66.25, 333, 333, 1234.5]
列表作为堆栈和队列
利用列表的 append() 和 pop() 方法,可以非常方便地实现堆栈(Stack)结构,即后进先出(LIFO)的数据访问模式。
>>> stack = [3, 4, 5]
>>> stack.append(6)
>>> stack.append(7)
>>> stack
[3, 4, 5, 6, 7]
>>> stack.pop()
7
>>> stack [3, 4, 5, 6]
>>> stack.pop()
6
>>> stack.pop()
5
>>> stack
[3, 4]
然而,如果使用列表来实现队列(先进先出,FIFO),由于在列表开头插入或弹出元素的时间复杂度为 O(n),效率较低。对于队列操作,建议使用 collections.deque,它支持从两端高效地添加和弹出元素。
>>> from collections import deque
>>> queue = deque(["Eric", "John", "Michael"])
>>> queue.append("Terry")                       # Terry arrives
>>> queue.append("Graham")                    # Graham arrives
>>> queue.popleft()                            # The first to arrive now leaves
'Eric'
>>> queue.popleft()                            # The second to arrive now leaves
'John'
>>> queue                               # Remaining queue in order of arrival
deque(['Michael', 'Terry', 'Graham'])
列表推导式(List Comprehensions)
列表推导式提供了一种简洁且高效的方式来创建列表。它由方括号包裹,包含一个表达式,后跟一个或多个 for 或 if 子句。其结果是一个新的列表,由表达式对输入序列进行计算后生成。
基本的列表推导式示例如下:
>>> vec = [2, 4, 6]
>>> [3*x for x in vec]
[6, 12, 18]
推导式可以包含复杂的表达式,甚至嵌套函数。例如,创建嵌套列表:
>>> [[x, x**2] for x in vec]
[[2, 4], [4, 16], [6, 36]]
通过 if 子句,可以过滤元素。例如,只保留大于 3 的元素:
>>> [3*x for x in vec if x > 3]
[12, 18]
>>> [3*x for x in vec if x < 2]
[]
列表推导式还可以包含多个 for 子句,用于处理多个序列。例如,计算两个向量的笛卡尔积:
>>> vec1 = [2, 4, 6]
>>> vec2 = [4, 3, -9]
>>> [x*y for x in vec1 for y in vec2]
[8, 6, -18, 16, 12, -36, 24, 18, -54]
此外,推导式还可以用于处理字符串,例如去除首尾空格:
>>> freshfruit = [' banana', ' loganberry ', 'passion fruit ']
>>> [weapon.strip() for weapon in freshfruit]
['banana', 'loganberry', 'passion fruit']
使用 del 语句删除元素
除了使用 pop() 方法,还可以使用 del 语句根据索引删除列表中的元素。与 pop() 不同,del 不会返回被删除的值。它还可以用于删除切片,甚至清空整个列表。
>>> a = [-1, 1, 66.25, 333, 333, 1234.5]
>>> del a[0]
>>> a
[1, 66.25, 333, 333, 1234.5]
>>> del a[2:4]
>>> a
[1, 66.25, 1234.5]
>>> del a[:]
>>> a
[]
此外,del 语句还可以用于删除整个变量。
>>> del a
元组(Tuple):不可变的序列
元组与列表类似,但元组是不可变的。元组由逗号分隔的值组成,通常用括号括起来。虽然括号不是必须的,但使用括号可以使代码更清晰。
>>> t = 12345, 54321, 'hello!'
>>> t[0]
12345
>>> t
(12345, 54321, 'hello!')
>>> # Tuples may be nested:
... u = t, (1, 2, 3, 4, 5)
>>> u
((12345, 54321, 'hello!'), (1, 2, 3, 4, 5))
需要注意的是,创建只包含一个元素的元组时,必须在该元素后添加一个逗号,否则括号会被解释为普通的分组操作符。
集合(Set):无序且不重复的元素集
集合是一个无序且不包含重复元素的数据结构。它主要用于成员资格测试和消除重复项。可以使用 set()) 函数创建集合,而花括号 {} 用于创建空字典。
>>> basket = {'apple', 'orange', 'apple', 'pear', 'orange', 'banana'}
>>> print(basket) # show that duplicates have been removed
{'orange', 'banana', 'pear', 'apple'}
>>> 'orange' in basket # fast membership testing
True
>>> 'crabgrass' in basket
False
集合支持标准的数学集合运算,如并集、交集、差集和对称差集。例如:
>>> a = set('abracadabra')
>>> b = set('alacazam')
>>> a            # unique letters in a
{'a', 'r', 'b', 'c', 'd'}
>>> a - b          # letters in a but not in b
{'r', 'd', 'b'}
>>> a | b          # letters in either a or b
{'a', 'c', 'r', 'd', 'b', 'm', 'z', 'l'}
>>> a & b             # letters in both a and b
{'a', 'c'}
>>> a ^ b             # letters in a or b but not both
{'r', 'd', 'b', 'm', 'z', 'l'}
字典(Dictionary):高效的键值映射
字典是 Python 中另一种内置的数据结构,它以键(Key)为索引,存储值(Value)。字典中的键必须是不可变类型(如字符串、数字或元组),且必须互不相同。字典是无序的(在 Python 3.7 之前),但会保持插入顺序。
字典的基本操作
可以使用花括号 {} 创建空字典,或者通过键值对直接初始化。字典支持通过键访问、添加和删除元素。
>>> tel = {'jack': 4098, 'sape': 4139}
>>> tel['guido'] = 4127
>>> tel
{'sape': 4139, 'guido': 4127, 'jack': 4098}
>>> tel['jack']
4098
>>> del tel['sape']
>>> tel['irv'] = 4127
>>> tel
{'guido': 4127, 'irv': 4127, 'jack': 4098}
可以使用 list(tel.keys()) 获取所有键,或使用 sorted(tel.keys()) 获取排序后的键列表。通过 in 关键字可以高效地检查键是否存在。
>>> list(tel.keys())
['irv', 'guido', 'jack']
>>> sorted(tel.keys())
 ['guido', 'irv', 'jack']
>>> 'guido' in tel
True
>>> 'jack' not in tel
False
构建字典的其他方法
除了使用花括号,还可以使用 dict() 构造函数从键值对元组列表构建字典。此外,如果键是字符串,还可以使用关键字参数来创建字典。
>>> dict([('sape', 4139), ('guido', 4127), ('jack', 4098)])
{'sape': 4139, 'jack': 4098, 'guido': 4127}
>>> dict(sape=4139, guido=4127, jack=4098)
{'sape': 4139, 'jack': 4098, 'guido': 4127}
字典推导式
类似于列表推导式,字典推导式可以创建任意键和值的字典。
>>> {x: x**2 for x in (2, 4, 6)}
{2: 4, 4: 16, 6: 36}
遍历技巧
在遍历字典时,可以使用 items() 方法同时获取键和值。
>>> knights = {'gallahad': 'the pure', 'robin': 'the brave'}
>>> for k, v in knights.items():
...   print(k, v)
...
gallahad the pure
robin the brave
对于序列,可以使用 enumerate() 函数同时获取索引和值。
>>> for i, v in enumerate(['tic', 'tac', 'toe']):
...   print(i, v)
...
0 tic
1 tac
2 toe
当需要同时遍历多个序列时,可以使用 zip() 函数将它们打包在一起。
>>> questions = ['name', 'quest', 'favorite color']
>>> answers = ['lancelot', 'the holy grail', 'blue']
>>> for q, a in zip(questions, answers):
...   print('What is your {0}? It is {1}.'.format(q, a))
...
What is your name? It is lancelot.
What is your quest? It is the holy grail.
What is your favorite color? It is blue.
如果需要反向遍历序列,可以使用 reversed() 函数。
>>> for i in reversed(range(1, 10, 2)):
... print(i)
...
9
7
5
3
1
如果需要按排序顺序遍历序列,可以使用 sorted() 函数,它返回一个新的已排序列表,而不修改原序列。
>>> basket = ['apple', 'orange', 'apple', 'pear', 'orange', 'banana']
>>> for f in sorted(set(basket)):
...   print(f)
...
apple
banana
orange
pear
 以上就是 Python 基本数据结构与用法详解【列表、元组、集合、字典】的详细内容,更多关于 Python 数据结构教程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















