


Python高效数据处理与格式化技巧:Counter、sorted与F-strings实战

面对Python开发中常见的遍历冗余与格式拼接耗时问题,合理使用collections模块的Counter类、内置的sorted与all函数,以及F-strings语法能显著精简代码体积。本文将结合实际运算逻辑与算法场景,逐步拆解各工具的入参规则、返回值特征与最佳实践路径。
解决代码冗余与数据处理的常见痛点
Python生态提供了大量高效工具,合理运用不仅能减少循环嵌套,还能显著降低内存占用。以下重点介绍常用于替代手动遍历的Counter类、支持自定义规则的sorted函数,以及底层实现更简洁的F-strings机制。
精准统计与频次分析:Counter类应用
Collections模块定位为高性能容器数据类型,其中Counter继承自dict,专门用于可哈希对象的快速计数。相比传统的字典手动累加,它能直接映射频次并配套专用查询方法。
第1步:引入模块并执行基础词频统计
目的:将手动遍历计数的模板代码替换为单行调用。
入口:已安装的标准Python环境内置collections模块。
动作:导入Counter并通过构造函数接收可迭代对象,观察控制台输出的键值对映射结果。
# 原始手动计数逻辑
fruits = ['apple', 'peach', 'apple', 'lemon', 'peach', 'peach']
result = {}
for fruit in fruits:
    result[fruit] = result.get(fruit, 0) + 1

# 使用Counter简化
from collections import Counter
c = Counter(fruits)
print(dict(c))
# 输出:{'apple': 2, 'peach': 3, 'lemon': 1}
第2步:配置参数展开元素与筛选高频项
目的:根据计数值还原元素副本或锁定Top N热门数据。
入口:已创建的Counter实例对象。
动作:调用elements()获取按首次出现顺序排列的元素迭代器;传入整数n给most_common(n)获取降序列表。若计数值小于1,elements()会自动过滤。
c = Counter(a=4, b=2, c=0, d=-2)
# 展开计数对应次数的元素
print(sorted(c.elements()))  # 忽略c和d,输出:['a', 'a', 'a', 'a', 'b', 'b']
# 获取最高频的前两项
print(c.most_common(2))      # 输出:[('a', 4), ('b', 2)]
第3步:结合交集运算处理多字符串共用字符
目的:利用&运算符求取多个Counter的公共部分,解决算法题中的字符共现问题。
入口:字符串列表或数组。
动作:初始化第一个元素的Counter作为基准,随后遍历剩余元素并使用 &= 进行频次取最小值操作,最后通过elements()展开结果。执行完毕后列表长度即为真实共现字符数。
class Solution:
    def commonChars(self, words: list[str]) -> list[str]:
        from collections import Counter
        ans = Counter(words[0])
        for w in words[1:]:
            ans &= Counter(w)
        return list(ans.elements())

# 输入:words = ["bella", "label", "roller"]
# 输出:["e", "l", "l"]
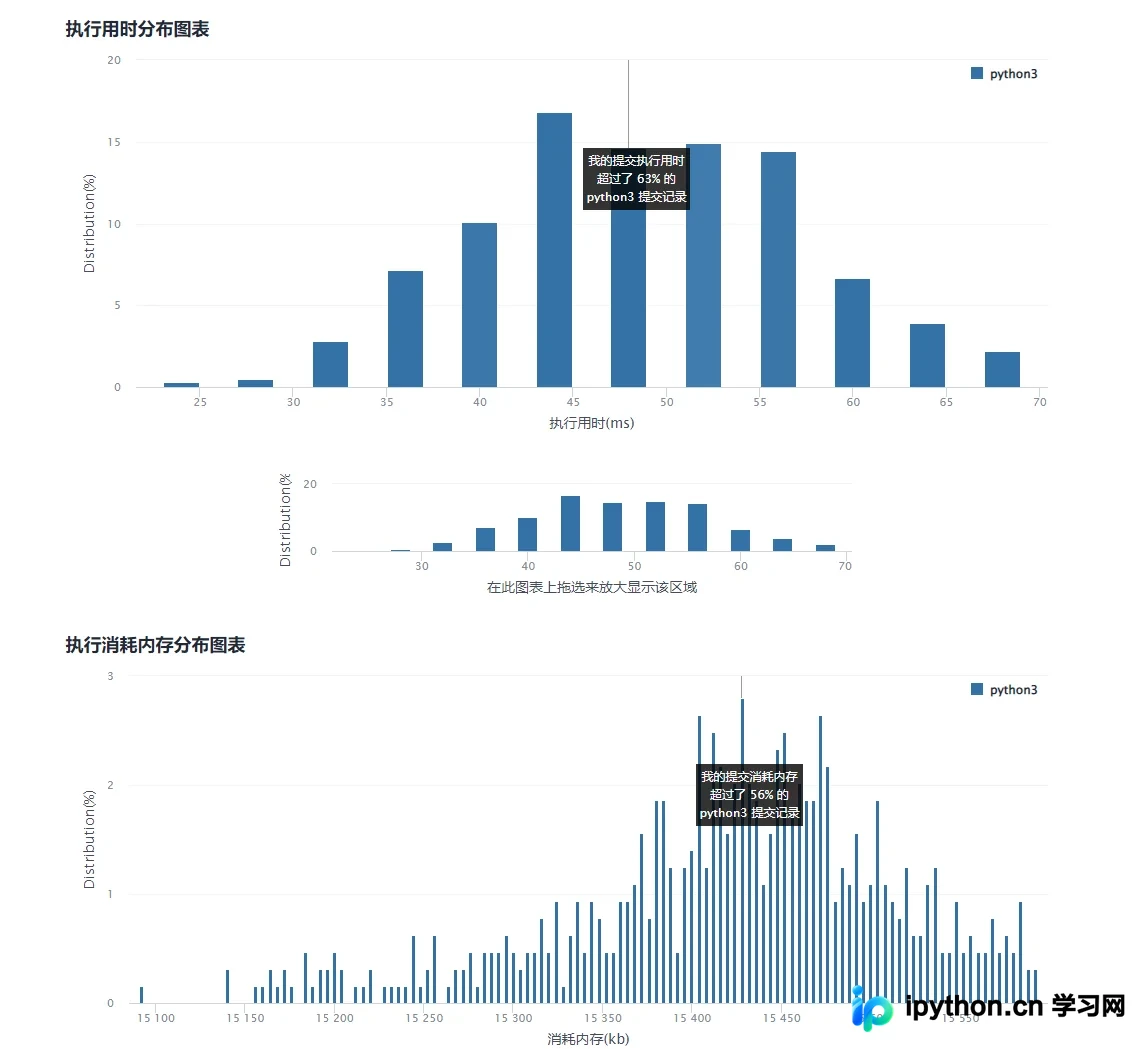
实际提交测试时,该逻辑在常规测试用例中耗时约48ms,内存占用较低,适合替换多层嵌套循环。
灵活排序与条件校验工具
第4步:设定规则对任意可迭代对象定向排序
目的:突破默认数值升序限制,实现列表、元组或混合结构的多维度排序。
入口:待排序的可迭代对象。
动作:调用sorted(data, key=lambda x: ..., reverse=True/False)。key参数绑定排序依据函数,reverse控制升降序。该方法始终返回新列表,不修改原数据,可通过打印确认排序后的索引对应关系。
a = [2, 4, 3, 7, 1, 9]
sorted(a, reverse=True)  # 降序:[9, 7, 4, 3, 2, 1]

fruits = ['apple', 'watermelon', 'pear', 'banana']
sorted(fruits, key=len)  # 按字符串长度升序:['pear', 'apple', 'banana', 'watermelon']
第5步:快速判定序列元素的真假阈值
目的:在一行代码内完成非空、非零状态的批量验证,替代for循环断言。
入口:包含任意类型元素的tuple或list。
动作:传入all()检查是否全部为真值(非0、非空、非None);传入any()检查是否存在至少一个真值。需留意Python规范:空列表[]与空元组()统一返回True。
all(['a', 'b', '', 'd'])  # 含空字符串,返回 False
all((0, 1, 2, 3))         # 含0,返回 False
all([])                   # 空列表特例,返回 True
any([False, None, [], 0]) # 全为空/假值,返回 False
告别传统格式化:F-strings语法特性
自Python 3.6起引入的F-strings提供了一种内联表达式求值的字符串拼接机制。其核心优势在于编译期优化,运行时性能优于老旧的%-占位符与str.format(),且语法声明即所得,大幅缩短调试链路。
x = 4
def power(val):
    return val * val

# 直接嵌入变量名、数学运算及函数调用
msg = f'{x} * {x} = {power(x)}'
print(msg)  # 输出:4 * 4 = 16
F-strings内部支持等号对齐、精度控制等高级特性。结合前文的计数器与排序逻辑,可在日志打印或API响应构造阶段实现无阻塞的高效输出。以上就是Python高效数据处理与格式化技巧的详细内容,更多关于Python进阶编程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















