


MySQL字符串字段加索引:前缀、覆盖与特殊场景优化

发布时间:2026-10-16 |
6人浏览过
面对支持邮箱或唯一标识登录的系统,直接在长字符串字段(如email)建全索引会消耗大量存储且可能导致页分裂。本文解析如何在MySQL中使用前缀索引平衡空间与性能,分析其在覆盖索引上的局限,并针对身份证号等低区分度场景提供哈希校验与倒序存储的替代方案。
前缀索引的数据结构与查询机制
在使用邮箱登录的场景下,用户表的 email 字段通常较长。若不设置索引,select ... where email='xxx' 将导致全表扫描。虽然可以直接对整个字符串创建索引,但在数据量较大时,这会占用显著的磁盘空间。
1. 全字段索引 vs 前缀索引
alter table SUser add index index1(email);:索引包含每个记录完整的字符串。alter table SUser add index index2(email(6));:索引仅包含前 6 个字节的字符串。
由于 InnoDB B+ 树叶子节点存储的是索引列值,email(6) 的结构因键值变短,单页可容纳更多记录,从而节省了整体存储空间。
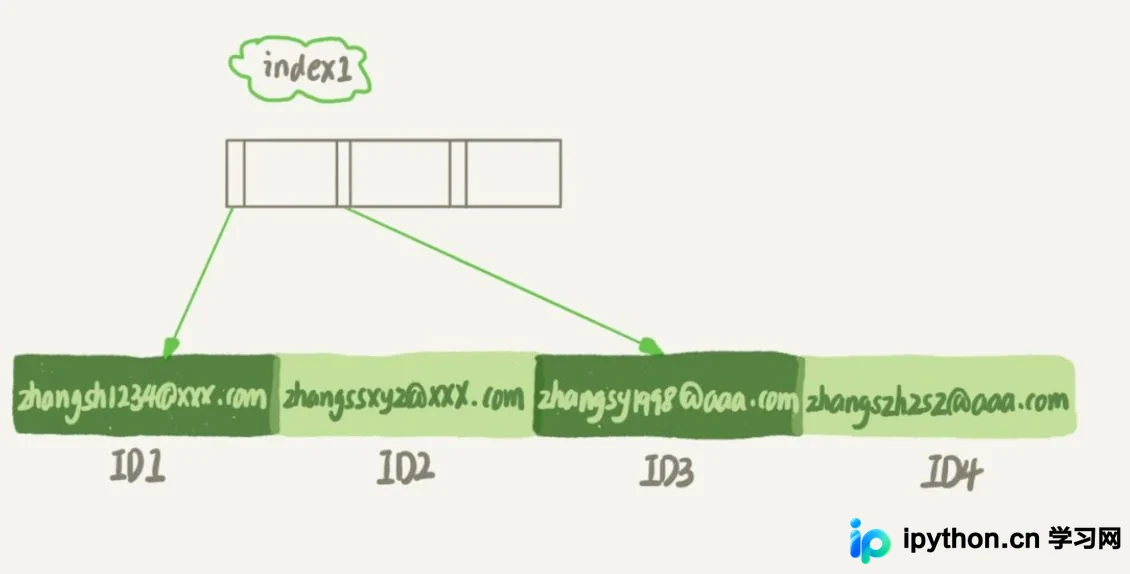
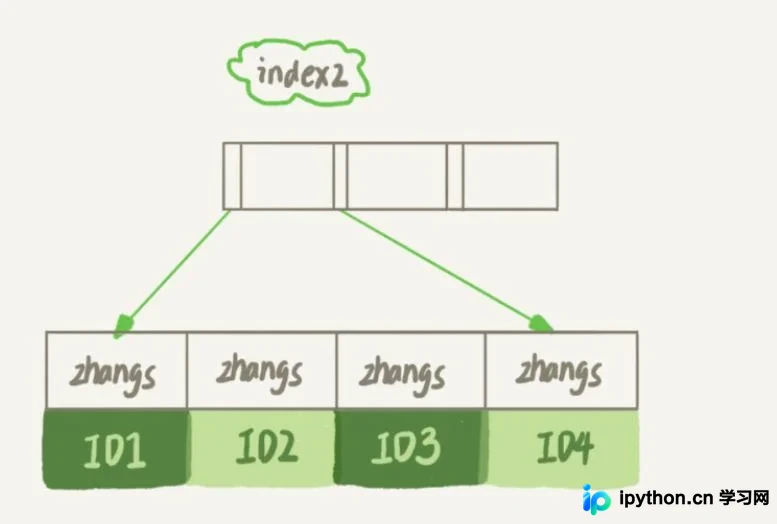
2. 查询执行流程的差异
假设查询where email='zhangssxyz@xxx.com':
- 全字段索引 (index1):根据精确的完整键值直接从索引树定位到主键 ID,再回表获取一行数据。整个过程仅扫描索引 1 行。
- 前缀索引 (index2, 长度6):根据前缀 'zhangs' 在索引树中查找,可能匹配到多条记录(如 ID1, ID2...)。必须依次回表,逐行判断全字段是否等于 'zhangssxyz@xxx.com'。若前缀区分度不足,扫描行数将显著增加。
结论:使用前缀索引以节省空间的同时,增加了查询时的回表次数(扫描行数)。
前缀索引的选取策略与覆盖索引限制
1. 如何选择合适的前缀长度?
应确保前缀能区分绝大部分记录。统计步骤如下:-- 1. 统计整个字段的唯一值总数 L select count(distinct email) as L from SUser; -- 2. 逐步增加前缀长度,查看不同长度的唯一值数量 select count(distinct left(email,4)) as L4, count(distinct left(email,5)) as L5, count(distinct left(email,6)) as L6, count(distinct left(email,7)) as L7 from SUser;
L_n >= L * 95% 的长度作为前缀长度。如上文所述,若选为 7 位使得区分度达到 95% 以上,则只需偶尔回表验证,性能可接受。
2. 前缀索引对“覆盖索引”的影响
覆盖索引是指查询所需的所有列都包含在索引中,无需回表。select id, email from SUser where email='...';
email(6)),索引中缺失了后几位字符的信息。即使 MySQL 优化器知道请求的值可能与索引值部分匹配,它仍无法直接确认未查询部分的精确性,因此 前缀索引通常会导致覆盖索引失效,依然需要回表进行二次过滤。
低区分度字段的索引优化方案
当字符串字段的重复前缀较多(如身份证号前 6 位多为地区代码)时,单纯增加前缀长度会降低 B+ 树的效率。此时可采用以下两种方法:Hash 校验法与倒序存储法。1. Hash 校验法(推荐用于高精度场景)
在表中增加一个整型字段存储字符串的 CRC32 校验码:alter table t add id_card_crc int unsigned, add index(id_card_crc);
crc32() 函数计算,查询时先匹配短索引,再做精确校验:
select field_list from t where id_card_crc=crc32('input_id_card_string') and id_card='input_id_card_string';2. 倒序存储法
利用业务库功能对特定字段反转存储,使高频重复的后缀变为前缀,提高区分度:select field_list from t where id_card = reverse('input_id_card_string');方案对比与总结
| 维度 | Hash 校验法 | 倒序存储法 |
| 额外存储空间 | 需新建一个字段(+4字节/行) | 无额外存储,复用原字段存储结构 |
| CPU 消耗 | 每行写入读取需执行 crc32 计算 | 每行写入读取需执行 reverse 操作,CPU 开销较低 |
| 范围查询 | 不支持(Hash 值无序) | 不支持(按倒序字符串排序) |
| 稳定性 | 高(极少哈希冲突) | 一般(依赖前缀区分度,可能有扫描行数波动) |
实际案例提示:
在学校学生系统中,若学号格式固定为 “15位数字 + @gmail.com”,考虑到学校年增人数有限,维护成本不高,建议直接使用 left(school_login_name, 15) 或干脆采用 prefix_index(full_string)。只有在海量并发且存储受限时,才考虑上述复杂的倒序或 Hash 方案。
以上就是 MySQL 字符串字段加索引的详细解析,涵盖了从基础的前缀优化到低区分度场景的特殊处理,更多关于数据库高性能设计的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















