


MySQL索引失效的10种情况详解

在MySQL数据库开发中,不当的SQL写法或索引设计会导致查询效率骤降。本文深入分析了导致MySQL索引失效的十种典型场景,涵盖最左匹配原则边界、范围查询对后续字段的影响、函数计算、类型隐式转换、逻辑运算符限制等方面。通过具体的EXPLAIN执行计划数据验证,揭示索引失效的根本原因,并提供相应的优化策略。
准备工作:构建测试环境
为了直观展示索引失效的效果,我们需要准备两张表进行演示:
1. 学生信息表 student_info(百万级数据):
CREATE TABLE `student_info` (
  `id` int NOT NULL AUTO_INCREMENT,
  `student_id` int NOT NULL,
  `name` varchar(20) DEFAULT NULL,
  `course_id` int NOT NULL,
  `class_id` int DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8;
2. 课程表 course(少量数据):
CREATE TABLE `course` (
  `id` int NOT NULL AUTO_INCREMENT,
  `course_id` int NOT NULL,
  `course_name` varchar(40) DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=101 DEFAULT CHARSET=utf8;初始化数据后:select count(*) from student_info;(约100万行),select count(*) from course;(100行)。
一、违反最左匹配原则
在使用联合索引时,必须严格遵守“最左前缀”原则。以下四种操作会导致索引部分或完全失效:
第1步:查询跳过中间字段或丢失最左侧字段
前提:建立联合索引 idx_name_cou_cls on student_info(name,course_id,class_id)。
场景① 全部匹配(最优):
explain select * from student_info where name='11111' and course_id=10068 and class_id=10154;该语句符合最左前缀原则,利用单个联合索引即可快速定位,性能最佳。

场景② 抹去最右边(有效但减少):
explain select * from student_info where name='11111' and course_id=10068;联合索引依然生效,但仅利用了 (name, course_id)。通过观察执行计划的 key_len,可以发现它比全匹配时少了5字节(对应未用的 class_id)。

场景③ 跳过中间字段(部分失效):
explain select * from student_info where name='11111' and class_id=10154;虽然使用了联合索引,但因为跳过了 course_id,B树只能快速查到所有 name='11111' 的记录,然后在内存中进行全表过滤来查找 class_id=10154。这比直接索引扫描要慢得多。key_len 只体现了最左边字段的长度。

场景④ 缺失最左侧(完全失效):
explain select * from student_info where class_id=10154 and course_id=10068;未包含联合索引的最左列 name,导致联合索引彻底失效,退化为全表扫描。

第2步:范围条件导致右侧索引失效
原理:如果在联合索引中某个字段使用了范围查询(如 >, <),则其右边的所有列索引都会失效。
演示:使用 course_id > 1 作为范围条件,即使后面跟着精确条件的 class_id,class_id 也会被忽略。
explain select * from student_info where name='11111' and course_id>1 and class_id=1;此时 key_len 只有68(仅为 name + course_id),证明 class_id 并未参与索引查找。

解决方案:将可能发生范围查询的字段尽量放在联合索引的最后面;或者将 >, < 转化为 >=, <= 的形式(此时右端索引不会失效)。例如:
explain select * from student_info where name='11111' and course_id>=20 and course_id<=40 and class_id=1;这种写法下,所有索引字段均被用到。
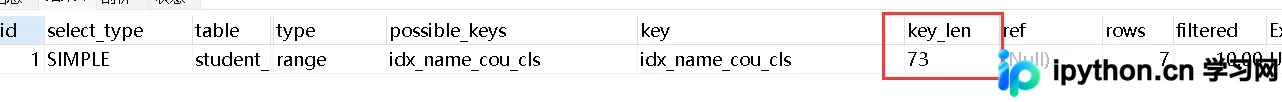
二、字符集不统一与类型转换
第3步:字符串上的函数和运算
在查询时对索引列使用函数或表达式计算,会使得优化器无法直接使用B树中的值。
# 不使用索引(因为触发了LEFT函数)
explain select * from student_info where LEFT(name,2)='li';
# 不使用索引(因为进行了 name+'' 运算)
explain select * from student_info where name+''='lisi';注意:使用通配符开头的模糊搜索同样会让B树失去意义:
# 以 % 开头,索引失效
explain select * from student_info where name like '%li';
第4步:隐式类型转换
当字段定义的格式与传入值的格式不一致时,MySQL会自动进行隐式转换,这本质上等同于对字段应用了函数,从而导致索引失效。
# name 是 varchar,这里传入了 int (123),导致隐式转为字符串比较失败或全表检索
explain select * from student_info where name=123;
# 正确使用字符串比较,能命中索引
explain select * from student_info where name='123';
三、特殊符号与逻辑判断的限制
第5步:不等于 (!= 或 <>)
不等号通常意味着需要进行全表查找,因此不会使用索引。
# 索引失效
explain select * from student_info where name <> 'zhangsan';
explain select * from student_info where name != 'zhangsan';
第6步:空值判断 (IS NULL vs IS NOT NULL)
IS NULL 可以利用索引快速定位空值,而 IS NOT NULL 无法通过常规索引加速。
# 可使用索引
explain select * from student_info where name is null;
# 索引失效
explain select * from student_info where name is not null;建议:在设计表结构时,尽量给字段设置 NOT NULL 约束(例如INT默认0,字符串默认空串),以避免此类问题。
第7步:OR 条件混杂无索引列
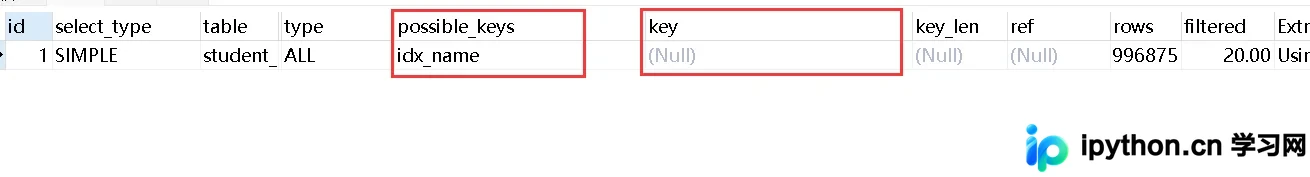
如果 OR 前后的两个条件中,有一方没有索引,那么整个查询通常会放弃索引,转为全表扫描。
# OR两边都有索引 -> 可以使用索引
explain select * from student_info where name like 'li%' or course_id=200;
# class_id 没有索引 -> 索引失效,走全表扫描
explain select * from student_info where name like 'li%' or class_id=1;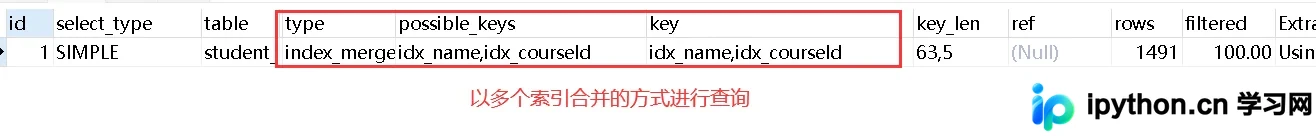
四、创建高效索引的建议
为了避免上述索引失效的情况,在实际开发中可以遵循以下原则:
- 单列索引选择:优先针对当前查询过滤性更高的字段创建索引。
- 组合索引设计:在组合索引中,应当把过滤性最好的字段放在最前面,同时尽可能包含
WHERE子句中更多的字段。 - 处理范围查询:对于可能出现范围查询(>、<)的字段,务必将其放置在联合索引的后段,以免污染前面的匹配精度并导致后续字段失效。
以上就是 MySQL 导致索引失效的几种情况的详细内容,更多关于 MySQL 索引优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















