


MySQL 索引原理与实战指南:从创建到 EXPLAIN 优化

本文深入解析 MySQL 索引的底层原理,详细介绍 B-Tree、哈希等算法及四种索引类型。通过 EXPLAIN 命令详解执行计划各字段含义,指导开发者识别全表扫描并优化查询。重点阐述组合索引的最左前缀匹配原则、前缀索引技巧,以及函数运算、模糊查询和 OR 条件等导致失效的场景,帮助提升数据库检索性能。
索引基础与 EXPLAIN 分析
索引是快速搜索的关键。MySQL 默认使用 B-Tree(二叉树)算法建立索引,相比无序数据的 O(N) 查找,能极大降低扫描行数。例如,在特定数据分布下,使用 B-Tree 可能仅需扫描数十行即可定位目标,而未使用索引则可能需要扫描数百万行。
第1步:使用 EXPLAIN 分析 SQL 执行计划
目的:查看 MySQL 如何执行 SELECT 语句,判断是否使用了索引,识别全表扫描或临时表创建等性能瓶颈。
操作:在 SELECT 语句前添加 EXPLAIN 关键字。
EXPLAIN SELECT * FROM blog WHERE false;由于 WHERE 条件永远为假,MySQL 优化器会直接判断无结果返回而不执行实际查询,但这仍展示了 SQL 分析器的过程。
示例与结果解读:
mysql> EXPLAIN SELECT `birday` FROM `user` WHERE `birthday` < "1990/2/2";执行输出包含以下关键字段:
id: 查询序列号。select_type: 查询类型。如 SIMPLE 表示简单查询,PRIMARY 表示最外层查询,UNION 表示联合查询中的后续部分,SUBQUERY 表示子查询。table: 显示当前行涉及的数据表。type: 连接类型(重要),反映访问效率。从高到低依次为:system > const > eq_ref > ref > range > index > ALL。目标是至少达到range级别,最好达到ref或更好。
[图注:多表关联时的索引效率对比,左侧展示全表扫描(ALL)的情况,右侧展示使用索引区间(range)的情况]
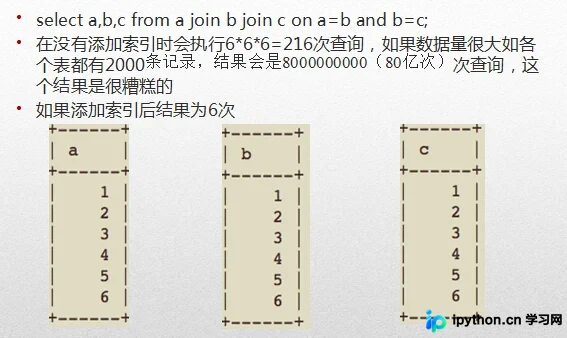
possible_keys: 可能使用的索引。若为空,说明没有相关索引,需检查 WHERE 子句是否引用了适合索引的字段。key: 实际使用的索引。若为 NULL,表示未使用索引。值为 PRIMARY 表示使用了主键。key_len: 使用索引的长度。越短越好,前提是保证查询准确性。ref: 显示哪个字段或常数与 key 一起被使用。rows: 预计需要扫描的行数。在 InnoDB 引擎中此为估算值,不一定准确。Extra: 额外信息。
-Using index: 覆盖索引,仅通过索引树即可获取数据,无需回表,效率最高。
-Using where: 使用 WHERE 条件过滤。
-Using temporary: 创建临时表存储结果,通常发生在 ORDER BY 或 GROUP BY 上,需要优化。
-Using filesort: 进行额外的排序操作,表明查询性能可进一步提升。
第2步:理解连接类型 (Type)
连接类型决定了 MySQL 从表中查找行的方式:
system: 表只有一行(系统表),特殊情况。const: 表至多有一行匹配。例如通过主键或唯一索引查找常量值,MySQL 将该匹配视为常数。eq_ref: 对于前面的表的每一行,从此表中读取一行。常用于主键或唯一索引的连接查询。ref: 对于前面的表的每一行组合,从此表中读取所有匹配的行。适用于非唯一或非主键索引。range: 使用索引范围扫描,如使用>、<、BETWEEN或IN查找。index: 全索引扫描,比全表扫描快,因为只需遍历索引树。ALL: 全表扫描,效率最低,应尽量避免。
索引类型与数据类型选择
MySQL 支持多种索引类型,选择合适的索引和数据类型对性能至关重要。
第3步:选择适当的索引类型
入口:在建表时或使用 ALTER TABLE 语句。
操作:根据业务需求选择以下类型之一:
- PRIMARY KEY (主键): 唯一且非空,一个表只能有一个。
- UNIQUE (唯一索引): 允许 NULL 值,但数据不能重复。
- INDEX (普通索引): 允许重复值和 NULL,用于加速查找。
- FULLTEXT (全文索引): 用于文本搜索。仅 MyISAM 引擎和特定版本 MySQL 完全支持中文,且效率较低。生产环境复杂文本搜索建议使用 Elasticsearch 等第三方工具。
第4步:优化列的数据类型
在选择用于索引或存储的列类型时,遵循以下原则:
- 越小越好: 更小的数据类型占用更少的磁盘、内存和 CPU 缓存空间,处理更快。
- 简单越好: 整型处理开销小于字符串。尽量使用内置日期时间类型而非字符串,使用整型存储 IP 地址而非 VARCHAR。
- 避免 NULL: 含 NULL 值的列会使索引统计和比较更复杂。若允许空值,建议使用 0、空串或特殊标记代替 NULL,或明确指定 NOT NULL。
索引的创建与管理
第5步:创建与删除索引
目的:为现有表添加索引或移除不再需要的索引。
操作:
-- 创建后添加普通索引
ALTER TABLE table_name ADD INDEX index_name (column_list);

-- 创建后添加唯一索引
ALTER TABLE table_name ADD UNIQUE (column_list);

-- 使用 CREATE INDEX (仅限普通和唯一索引)
CREATE INDEX index_name ON table_name (column_list);
CREATE UNIQUE INDEX index_name ON table_name (column_list);

-- 删除索引
DROP INDEX index_name ON table_name;
-- 或删除主键(只能用此方法)
ALTER TABLE table_name DROP PRIMARY KEY;

-- 查看索引结构
SHOW INDEX FROM tablename \G;风险提醒:删除或重建索引期间,表可能被锁定,高并发环境下请在业务低峰期操作。批量导入数据前,建议暂时删除索引,导入完成后再重新创建,以提升入库速度。
高级索引技巧与避坑指南
第6步:应用最左前缀原则构建组合索引
背景:当对多列进行索引时,MySQL 仅能对索引的最左边前缀进行有效查找。
操作:假设创建了组合索引 name_city_age (vc_Name, vc_City, i_Age)。
- 生效查询:
WHERE vc_Name='erquan' AND vc_City='郑州'或WHERE vc_Name='erquan'。这等价于分别建立了这三个维度的前缀索引。 - 失效查询:
WHERE vc_City='郑州'或WHERE i_Age=20 AND vc_City='郑州'。因为缺少最左边的引导列vc_Name,MySQL 无法利用该组合索引。
第7步:使用前缀索引节省空间
目的:对较长的字符串列(如VARCHAR),使用前缀索引可减少索引文件大小,提高内存装载量。
操作:计算区分度,通常控制在 0.31 以上的区分度即可创建前缀索引。
-- 检查区分度:COUNT(DISTINCT(LEFT(col, N))) / COUNT(*)
SELECT COUNT(DISTINCT(LEFT(`title`,10)))/COUNT(*) FROM `Arctic`;

-- 如果结果大于 0.31,可创建前缀索引
ALTER TABLE `user` ADD INDEX `uname`(title(10));
第8步:规避导致索引失效的常见写法
目的:确保查询能命中索引,避免隐式转换或全表扫描。
场景与修正:
- 函数运算:
WHERE age + 10 = 30不走索引。应改为WHERE age = 20。 - 类型隐式转换: 字符串列与数字比较不走索引。如
WHERE a = 1(a为char)不走索引,应改为WHERE a = '1'。 - 模糊查询: 前缀匹配
LIKE '后盾%'走索引;包含前导通配符LIKE '%后盾%'不走索引。 - OR 条件: 如果 OR 两边字段不都有索引,整体将放弃索引进行全表扫描。尽量避免混用无索引字段的 OR 条件。
- 正则表达式:
REGEXP不使用索引。
以上就是 MySQL 索引原理与 EXPLAIN 优化的详细内容,更多关于 MySQL 索引设计与实战的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















