


MySQL实现分布式锁:原理、步骤与代码示例

在分布式系统中,如何实现跨进程的资源独占?本文将深入剖析基于MySQL InnoDB存储引擎的分布式锁方案,通过解析共享锁与排他锁的工作机制,结合Java代码实例,展示如何利用`SELECT ... FOR UPDATE`语句和唯一索引构建可靠的互斥锁,保障并发场景下的数据一致性。
MySQL锁机制基础
数据库中的锁是协调多个事务并发访问同一资源的机制。对于关系型数据库而言,除了操作系统层面的资源争用,数据本身作为共享资源,其并发一致性与有效性是核心挑战。锁冲突程度直接决定了数据库的并发性能,因此理解锁的底层逻辑是设计分布式锁的前提。
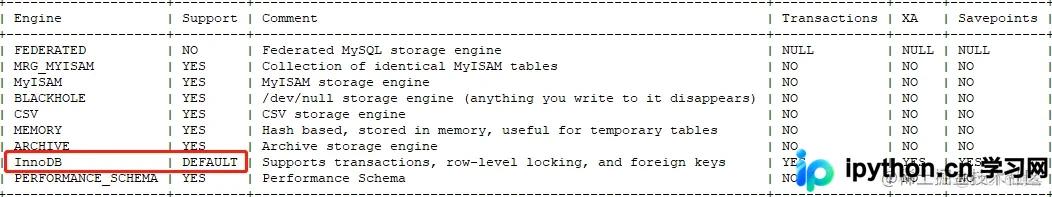
MySQL的性能很大程度上取决于InnoDB或MyISAM等存储引擎。其中,InnoDB支持多粒度锁定,默认采用行级锁,适合高并发的读写场景;而MyISAM仅支持表级锁。实现分布式锁通常依赖InnoDB的行锁特性。
行锁类型:共享锁与排他锁
InnoDB的行锁主要分为两种:
- 共享锁(S锁/读锁):允许其他事务读取锁定数据,但禁止修改。不同事务可在同一行上共存多个共享锁,只要不申请排他锁即可。
- 排他锁(X锁/写锁):独占资源,持有锁的事务可执行增删改查,其他事务对该行的读取会被阻塞,且不允许任何其他事务获取该行的共享锁。
共享锁通过LOCK IN SHARE MODE语法实现,排他锁通过FOR UPDATE语法实现。关键在于:FOR UPDATE会触发行级排他锁,如果指定列没有合适的索引,锁会升级(退化)为表级锁,从而丧失并发性。
基于InnoDB的唯一索引分布式锁实现
利用InnoDB的排他锁特性,结合业务唯一键,可以实现一种简易的分布式锁。当多个客户端尝试获取同一业务的锁时,只有第一个成功执行加锁查询的事务能继续,后续的请求因等待锁释放而产生阻塞,从而实现互斥。
第1步:创建锁控制表
首先需要准备一张专门用于管理锁状态的表。表中必须包含一个具有唯一约束(Unique Key)的业务字段,这是确保锁能精确到“行”级别的核心要素。
CREATE TABLE IF NOT EXISTS fud_distribute_lock (
    id BIGINT UNSIGNED PRIMARY KEY AUTO_INCREMENT,
    biz VARCHAR(50) COMMENT '业务Key',
    UNIQUE KEY uk_biz (biz)
) ENGINE=InnoDB;说明:biz字段代表具体的业务标识(如订单ID),UNIQUE KEY uk_biz确保该值在全局唯一。由于使用了唯一索引,后续的FOR UPDATE操作将精准定位到该行,避免全表扫描导致的表锁。
第2步:Java客户端获取锁逻辑
获取锁的流程分为两步:首先尝试使用SELECT ... FOR UPDATE查询记录。如果记录不存在,则执行插入操作以预留锁占位;一旦插入成功或查询命中,即视为获得锁。在此期间需关闭自动提交(Auto Commit),保证事务持续占用锁。
// 省略了构造方法,需要传入DataSource和biz
private static final String SELECT_SQL =
    "SELECT * FROM fud_distribute_lock WHERE `biz` = ? for update";
private static final String INSERT_SQL =
    "INSERT INTO fud_distribute_lock(`biz`) values(?)";

// 从构造方法中传入
private final DataSource source;
private Connection connection;

public void lock() {
    PreparedStatement psmt = null;
    ResultSet rs = null;
    try {
        // 循环直到获取成功
        for (; ; ) {
            connection = this.source.getConnection();
            // 关闭自动提交事务,维持事务上下文以持有锁
            connection.setAutoCommit(false);

            psmt = connection.prepareStatement(SELECT_SQL);
            psmt.setString(1, biz);
            rs = psmt.executeQuery();

            // 如果查询到了数据,说明当前已有该业务的其他客户端持有锁,或者自己已获取
            if (rs.next()) {
                return;
            }

            // 如果没有查到记录,需要先插入一行来“占据”这个位置
            // 因为for update只能锁定已经存在的行
            connection.commit(); // 先提交刚才的空事务
            close(connection, psmt, rs);

            Connection updConnection = this.source.getConnection();
            PreparedStatement insertStatement = null;
            try {
                insertStatement = updConnection.prepareStatement(INSERT_SQL);
                insertStatement.setString(1, biz);
                if (insertStatement.executeUpdate() == 1) {
                    LOGGER.info("创建锁记录成功");
                } else {
                    // 如果返回0,说明存在竞争,其他线程抢先插入了
                    continue;
                }
            } catch (Exception e) {
                // 如果发生死锁或其他异常导致插入失败,说明有竞争对手已持有该唯一键
                // 此时应当重试,重新进入循环去select...for update
                LOGGER.error("创建锁记录异常", e);
                continue;
            } finally {
                close(insertStatement, updConnection);
            }

            // 插入成功后,为了正式进入持有锁的状态,再次执行select for update
            psmt = connection.prepareStatement(SELECT_SQL);
            psmt.setString(1, biz);
            connection.setAutoCommit(false);
            rs = psmt.executeQuery();
            // 再次确认获取锁状态
            rs.next();
            return;
        }
    } catch (Exception e) {
        LOGGER.error("lock异常信息", e);
        throw new RuntimeException(e);
    } finally {
        // 资源清理需注意保留当前连接connection供后续unlock使用
        if(psmt != null) { try { psmt.close(); } catch (Exception ignore) {} }
        if(rs != null) { try { rs.close(); } catch (Exception ignore) {} }
    }
}

public void unlock() {
    try {
        // 事务提交之后自动解锁(释放行上的X锁)
        connection.commit();
        close(connection);
    } catch (Exception e) {
        LOGGER.error("unlock异常信息", e);
        throw new RuntimeException(e);
    }
}

public void close(AutoCloseable... closeables) {
    Arrays.stream(closeables).forEach(closeable -> {
        if (null != closeable) {
            try {
                closeable.close();
            } catch (Exception e) {
                LOGGER.error("close关闭异常", e);
            }
        }
    });
}
第3步:为什么不能直接使用SELECT FOR UPDATE?
很多初学者误以为直接执行SELECT ... FOR UPDATE就能加锁。实际上,FOR UPDATE只会锁定查询结果集中已经存在的行。如果数据库中还没有对应业务的记录,SELECT返回空集,自然也就没有任何行被锁定,无法起到互斥作用。
因此,标准的操作流程是:
1. 开启事务。
2. 尝试插入一行带有唯一业务Key的记录。若插入成功,即拿到锁;若插入失败(违反唯一键约束),则说明有人先拿到了锁。
3. 若插入成功,紧接着执行一次SELECT ... FOR UPDATE查询该行,将“插入产生的隐式锁”转化为明确的行级排他锁,随后保持事务不关闭,直至业务处理完成调用commit()释放锁。
总结
虽然在实际生产环境中,Rediss 或 Zookeeper 是实现分布式锁的主流选择,但掌握基于 MySQL 的实现原理依然具有重要价值。它展示了如何利用数据库自带的 ACID 特性和行锁机制来解决并发控制问题。在使用时请务必注意,由于数据库连接池的持有以及事务的时间成本,这种方式吞吐量相对较低,且建议业务侧做好超时防死锁处理。以上就是基于MySQL实现分布式锁的详细内容,更多关于MySQL分布式锁的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















