


如何修改numpy array的数据类型

本文详解如何修改Numpy数组的数据类型,包括使用astype()方法创建新数组以及直接修改dtype属性。深入解析Numpy中dtype的内存管理机制、字节序表示及自动转换规则,重点剖析object类型处理时的inner loop机制、np.nan溢出问题及常见转换异常,帮助开发者规避类型转换陷阱。
修改numpy array数据类型
1、numpy数据类型
| 数据名称 | 说明 |
|---|---|
| bool | 布尔类型,true,false |
| int_ | 默认的整数类型(类似于 C 语言中的 long,int32 或 int64) |
| intc | 与 C 的 int 类型一样,一般是 int32 或 int 64 |
| intp | 用于索引的整数类型(类似于 C 的 ssize_t,一般情况下仍然是 int32 或 int64) |
| int8 | 字节(-128 to 127) |
| int16 | 整数(-32768 to 32767) |
| int32 | 整数(-2147483648 to 2147483647) |
| int64 | 整数(-9223372036854775808 to 9223372036854775807) |
| uint8 | 无符号整数(0 to 255) |
| uint16 | 无符号整数(0 to 65535) |
| uint32 | 无符号整数(0 to 4294967295) |
| uint64 | 无符号整数(0 to 18446744073709551615) |
| float_ | float64 类型的简写 |
| float16 | 半精度浮点数,包括:1 个符号位,5 个指数位,10 个尾数位 |
| float32 | 单精度浮点数,包括:1 个符号位,8 个指数位,23 个尾数位 |
| float64 | 双精度浮点数,包括:1 个符号位,11 个指数位,52 个尾数位 |
| complex_ complex128 | 类型的简写,即 128 位复数 |
| complex64 | 复数,表示双 32 位浮点数(实数部分和虚数部分) |
| complex128 | 复数,表示双 64 位浮点数(实数部分和虚数部分) |
2、改变numpy array数据类型
使用astype()方法可以改变数据类型,具体操作方式如下所示(注意:此方法不会改变原数组的数据类型):
array_name.astype(int)
array_name.astype(np.int16)
array_name.astype('float64')
若需直接改变原数组的数据类型,可采用以下方法:
array_name.dtype = np.uint8numpy数据类型说明及自动转换陷阱
numpy的dtype是一个核心概念。由于Numpy为追求性能优化了内存管理,ndarray的值在内存中近乎连续排列,且每个元素的内存大小被设计为一致。因此,在生成ndarray时,所有元素的数据类型会被统一转换为相同类型。若原始数据类型不一致,便涉及数据类型转换(data type casting)的问题。
理解Numpy中的数据类型转换有助于有效避免和理解许多行为,因为Numpy中的许多错误往往由数据类型转换引起。因此,理解数据类型转换可以预防和排查诸多问题。首先,Numpy中包含多种数据类型,数量多于Python内置数据类型,具体类型可参考下图。图中columns和index为Numpy中数据类型的符号表示,具体释义可查阅相关文档。下文重点讲解Numpy中关于数据类型及转换时容易遇到的陷阱或注意事项。
1、数据类型的表示
在Numpy中,一个数据类型实际上是一个dtype对象,具有字节顺序、数据类型、字节数大小等重要属性。通常,Numpy中的数据类型表示为类似'<i4'的形式。在此表示法中,'<'表示字节顺序,'i'表示数据类型(此处指整数),'4'表示一个元素占据的字节数,即32位整数。
2、构造ndarray时的dtype
在构造ndarray时,可通过指定dtype参数来设置数组内元素的数据类型。该dtype既可用'i4'这样的字符串表示,也可用int表示,但后者无法指定字节数。需注意,指定dtype时,务必确认该dtype能兼容所有元素,以防溢出或不兼容。可通过result_type(*array_like)函数判断应设定的dtype,该函数返回能兼容所有元素的最小size的数据类型;或者不设定,由系统自动进行数据类型转换,也可通过ndarray.dtype属性查看数据类型。无论如何,需具备数据类型转换的意识,因为这会影响后续对ndarray的操作。
3、不同数据类型之间的转换兼容性
Numpy的数据类型之间能够实现转换,可通过np.can_cast(fromtype,totype)函数进行判断,更详细信息可参考下图。
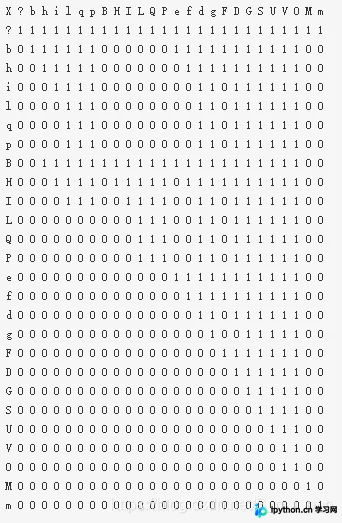
4、numpy对python对象数据类型'O'的处理
当Numpy中包含Python独有的原生数据类型(如Decimal)时,ndarray会被转为object数据类型,表示Python对象数据类型。当然,也可转为字符串,但字符串对于np.nan往往会占据更大的itemsize。
当Numpy函数处理dtype为object的ndarray时,会先将内部元素进一步转为其他Numpy数据类型,以便进行操作。因此,若函数无法或未指定类型参数,将默认以第一个inner loop遇到的数据类型作为所有元素的类型,并以此类型进行后续转换。此时,对于object类型的ndarray,往往容易出现数据无法转换成功的异常。因此,需注意处理时第一个inner loop遇到的元素类型是否能兼容后续所有要处理的元素,否则将抛出异常。见以下示例说明。
import numpy as np
from decimal import Decimal

arr=np.array([[1,2.0,3],['a',3,np.nan],[2,np.nan,Decimal('5')]])
arr1=np.apply_along_axis(lambda x:x[0],arr=arr,axis=1)
arr1
# output:
# ValueError: invalid literal for int() with base 10: 'a'

arr2=np.apply_along_axis(lambda x:x[1],arr=arr,axis=1)
arr2
# output:
# array([ 2.,  3., nan])

arr2=np.apply_along_axis(lambda x:x[2],arr=arr,axis=1)
arr2
# output:
# array([          3, -2147483648,           5])
从上述示例可见,在arr1中,由于第一个inner loop遇到的元素是整数1,因此会以整数类型对后续元素进行转换,但后续元素为字符'a',无法转为int,故报上述错误;在arr2中,第一个遇到的元素是2.0(float),因此后续元素均被转为float,输出为array([ 2., 3., nan]),其中均变为float。需注意,由于np.nan本身即为浮点数,因此此处可正确转换,转换后仍为np.nan;但观察arr2(注:原文此处逻辑有误,应为arr3或另一示例,但按原文描述),由于第一个遇到的元素类型为int32,后续np.nan为float64,会造成溢出,从而无法正确转换,此时会用int32最接近np.nan的值进行替换,即-2**31(-2147483648)。此处之所以是2**31而非2**32-1,是因为此处的int为signed int(有符号整数),其范围为-2**31至2**31-1;而Decimal('5')被转为int 5,因此出现上述结果。
因此,当要被转成ndarray的原始数据中包含np.nan时,需特别注意此点,最好指定float类型,并注意其他数据的兼容性;若同时为object数据类型,则还需注意第一个inner loop遇到的元素的数据类型,确保与后续数据类型保持兼容。
小结:Numpy的dtype存在诸多陷阱,需小心对待,谨慎核查,然后灵活运用。
以上为个人经验,希望能给大家一个参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















