


Python 从结构化字符串中精准提取数据并对象化

本文演示如何使用 Python 将固定格式的结构化文本逐段拆分,并将其中的时间戳、ID 及评分等字段自动转换为对应的数据类型。通过封装自定义类与 parse 方法,实现一键解析与对象化存储,为后续的数据分析与批量处理提供标准化输入。
处理目标与适用场景
在日志分析、自动化报表或批量抓取任务中,经常需要将已知模板的结构化字符串转换为程序可计算的对象。例如,解析包含时间戳、唯一标识、名称和数值的记录,并将其分别映射为日期时间、整数、字符串与高精度数值,以便直接入库或进行聚合统计。
第1步:安装依赖与定义原始数据
本方案使用第三方库 delorean 处理 ISO 格式时间戳。若环境未预装,请先执行 pip install delorean。随后准备待解析的原始字符串样本:
>>> import delorean
>>> from decimal import Decimal
>>> text = '[2022-08-01T11:58:41.504054] - MOVIE ID: 00015 - MOVIE NAME: Inception - SCORE: 8.5'
第2步:按固定分隔符拆分字段
使用双空格分隔符 " - " 将整行文本切分为独立的模块,避免关键字粘连。拆包后便于逐项清洗:
>>> divided_text = text.split(' - ')
>>> divided_text
['[2022-08-01T11:58:41.504054]', 'MOVIE ID: 00015', 'MOVIE NAME: Inception', 'SCORE: 8.5']
>>> timestamp_str, movie_id_str, movie_name_str, score_str = divided_text
第3步:逐项清洗并转换数据类型
不同字段需采用针对性的转换逻辑,确保最终获得严谨的数据结构:
- 时间戳解析:去除两端的方括号,交由
delorean.parse()转为标准时间对象。 - ID 转整数:以冒号截取键值对右侧内容,调用
int()自动过滤前导零。 - 评分转精度:截取冒号后内容,使用
Decimal()避免浮点数运算时的精度丢失。
>>> timestamp = delorean.parse(timestamp_str.strip('[]'))
>>> timestamp
Delorean(datetime=datetime.datetime(2022, 8, 1, 11, 58, 41, 504054), timezone='UTC')

>>> movie_id = int(movie_id_str.split(':')[-1])
>>> movie_id
15

>>> score = Decimal(score_str.split(':')[-1])
>>> score
Decimal('8.5')
第4步:封装类与方法实现一键解析
将上述流程收敛至 Movie 类内部。定义 __init__ 初始化属性,并通过 @classmethod 提供 parse 入口。实例化后可直接查看格式化输出:
class Movie(object):
    def __init__(self, timestamp, movie_id, movie_name, score):
        self.timestamp = timestamp
        self.movie_id = movie_id
        self.movie_name = movie_name
        self.score = score

    def __repr__(self):
        return '<Movie ({}, {}, {})>'.format(self.timestamp, self.movie_id, self.movie_name, self.score)

    @classmethod
    def parse(cls, text):
        '''将固定格式文本解析为 Movie 对象'''
        divided_text = text.split(' - ')
        ts_s, id_s, name_s, sc_s = divided_text
        ts = delorean.parse(ts_s.strip('[]'))
        id_v = int(id_s.split(':')[-1])
        name_v = name_s.split(':')[-1]
        sc = Decimal(sc_s.split(':')[-1])
        return cls(timestamp=ts, movie_id=id_v, movie_name=name_v, score=sc)
调用解析方法后,终端将返回结构化的对象实例:
>>> Movie.parse(text)
<Movie (Delorean(...), 15, Inception, Decimal('8.5'))>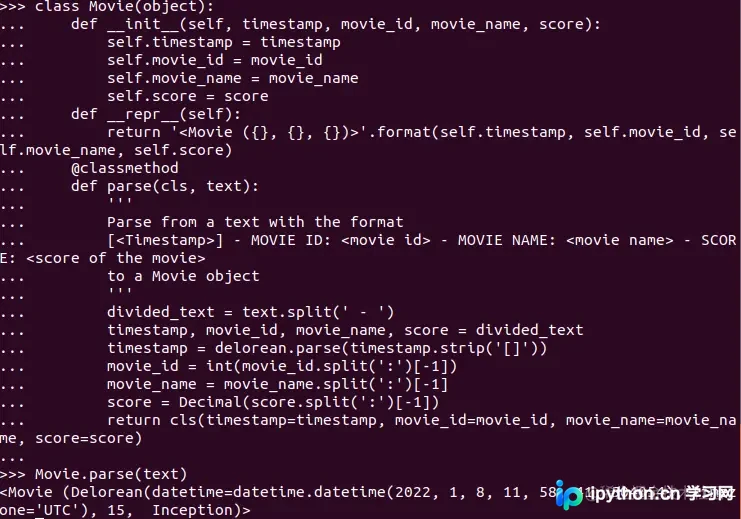
关键注意事项
该解析逻辑强依赖于原始文本的分隔符规范。若输入数据缺失方括号或分隔符位置偏移,strip() 或 split() 可能引发索引越界。建议在实际工程中配合 try...except 异常捕获,或在正则表达式层面做容错校验。处理大批量或不可逆的数据源前,建议先备份原始记录。
总结
通过明确的分隔策略与针对性类型转换,可以高效地将人类可读的固定格式字符串转化为机器可计算的 Python 对象。该方法适用于各类带固定模板的日志、配置或业务记录解析,大幅减少冗余的手动清洗代码。以上就是 Python 从结构化字符串中提取数据的详细内容,更多关于 Python 文本解析与数据清洗的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















