


MySQL跨库Join查询实现方法与架构建议

在MySQL实际开发中,跨库Join是常见痛点。本文首先给出同服务器多库的简易解决方案,随后详细拆解利用FEDERATED引擎连接不同服务器的操作步骤与关键参数。最后,从系统架构角度分析为何应尽量避免物理层面的跨库Join,并推荐数据冗余、API组合或 Canal 同步等更具扩展性的实施路径。
同服务器上的跨库Join
如果涉及的多个数据库位于同一个 MySQL 实例(同一台服务器)上,这属于最基础的操作。MySQL 原生支持跨库查询,无需额外配置,只需在 SQL 语句中使用 db_name.table_name 的标准语法格式即可。
select
	*
from
	userdb.user u
join orderdb.`order` o on
	u.id = o.user_id;
不同服务器间的跨库Join
当需要跨服务器进行 Join 操作时,MySQL 提供了 FEDERATED 存储引擎来实现“本地透明访问远程表”。该机制允许你在本地创建一个空的表结构,其数据则通过连接字符串实时指向远端数据库。
第1步:启用 FEDERATED 引擎
首先需要确认当前环境的引擎支持情况。执行以下命令查看:
SHOW engines;
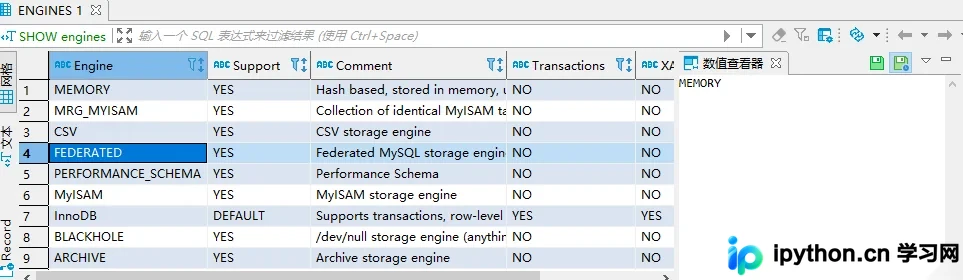
如果在 Support 列看到 NO,说明引擎未开启。默认情况下该引擎在许多发行版中是禁用的。需要在 MySQL 配置文件(Windows下为 my.ini,Linux/macOS下为 my.cnf)中添加一行:
federated
添加后重启 MySQL 服务以生效。
第2步:创建远程映射表
在本地数据库中,你需要手动创建一个与目标远程表结构一致(字段可以更少但不能更多)的空表。关键在于 ENGINE=FEDERATED 和 CONNECTION 属性。
CREATE TABLE `order` (
  `id` bigint NOT NULL AUTO_INCREMENT,
  `user_id` bigint NOT NULL,
  `product_name` varchar(50) CHARACTER SET utf8 COLLATE utf8_general_ci DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE =FEDERATED CONNECTION='mysql://root:123456@192.168.10.100:3306/orderdb/order';
CONNECTION 连接字符串通用格式:
scheme://user_name[:password]@host_name[:port_num]/db_name/tbl_name
注意事项:
- 安全性风险:密码在
CONNECTION中是以明文形式存在的。通过SHOW CREATE TABLE或show table status即可查看明文密码,请确保本地数据库访问权限受控。 - 结构约束:本地定义的列必须能在远程表中找到匹配。增加列会导致语法错误。
- 事务支持:FEDERATED 引擎本身不支持事务。
- 读写特性:它是实时的读写映射。本地对这张映射表的增删改会直接影响远端物理表。
跨库 Join 的架构优化方案
虽然技术上可以实现跨库/跨机器的 Join,但在高并发和高可用架构中,**通常不建议直接使用物理层的跨库 Join**。这会增加网络延迟,引发分布式锁问题,且在 MySQL 集群或分库分表环境下难以维护。
以下是几种更推荐的实践方式:
- 应用层组装(微服务/API):由后端服务分别调用 User 服务和 Order 服务的接口获取数据,在内存中进行 Join 组装。
- 数据冗余设计:在创建订单时,将用户姓名等必要信息冗余写入 Order 表,彻底消除关联需求。
- CDC 数据同步(如 Canal):利用 Canal 监听远端数据库 Binlog,将核心关联数据实时同步到本地的业务宽表中,在本地库完成高效 Join。
- 数据仓库/只读副本:使用 ETL 工具将分散在多台服务器上的数据定时汇总到一个只读中间库,在该库中进行复杂报表关联。
如果你的场景确实是单机多实例且无法拆分,可优先考虑前述的物理跨库方案;若涉及微服务治理,请优先评估上述架构调整方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















