


MySQL JOIN 原理、算法与性能优化实战指南

深入理解 MySQL JOIN 的工作原理是编写高效 SQL 的基础。本文详细梳理了 LEFT/RIGHT/INNER/FULL/CROSS/Straight JOIN 的应用场景,剖析了基于嵌套循环的三种执行算法(Simple、Index、Block Nested-Loop),并结合 EXPLAIN 工具给出驱动表选择、索引优化及 Join Buffer 参数调整等实战建议。
MySQL JOIN 的核心类型
在关系型数据库中,JOIN 用于将两个或多个表基于相关列组合在一起。MySQL 支持多种连接类型,理解其逻辑结果是排查数据缺失或冗余的前提。
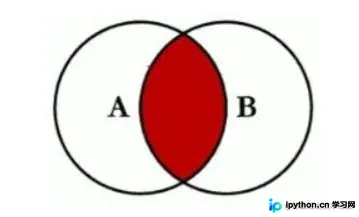
1. 内连接 (Inner Join)
仅返回两个表中连接字段匹配的行,即取交集。这是最常用的连接方式。
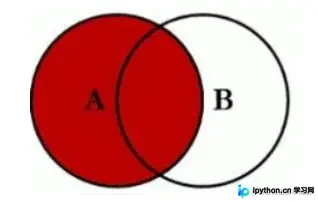
2. 左连接 (Left Join)
以左表为驱动表,结果集包含左表所有行。右表中匹配的行被追加到结果中;若右表无匹配,则对应字段为 NULL。
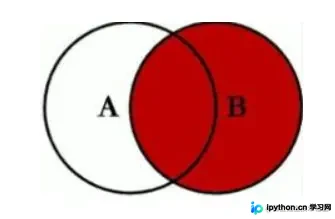
3. 右连接 (Right Join)
以右表为驱动表,逻辑与 Left Join 相反。保留右表所有行,左表未匹配的字段补 NULL。
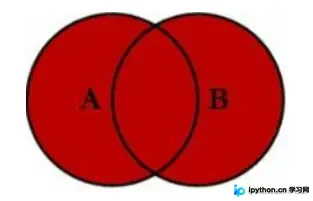
4. 全外连接 (Full Join) 的替代方案
注意:MySQL 原生并不直接支持 FULL OUTER JOIN。 在 MySQL 中,通常使用 UNION 或 UNION ALL 结合左连接和右连接来实现全外连接的效果。
UNION:合并两个结果集并去重。UNION ALL:合并两个结果集,保留所有重复行(性能略优,但可能产生重复数据)。
5. 交叉连接 (Cross Join)
产生两个表的笛卡尔积,结果集行数为两表行数之积。若加上 WHERE 条件,则等价于内连接,但在执行计划上略有不同。
6. 严格驱动连接 (Straight Join)
使用 Straight Join 强制指定左表为驱动表。通常在优化器选错驱动表导致性能低下时作为调试手段使用,生产环境需谨慎依赖此语法。
JOIN 的执行原理与算法
从底层实现来看,大多数 JOIN 操作本质上可以理解为嵌套循环 (Nested-Loop Join):
- 外层循环:遍历驱动表(Driver Table)的每一行。
- 内层循环:针对驱动表的每一行,在被驱动表(Driven Table)中查找匹配的记录。
根据查找被驱动表记录的方式不同,MySQL 主要涉及以下三种算法:
第一种:Simple Nested-Loop Join (SNLJ)
这是最基础的实现方式。
- 流程:取出驱动表的一行,逐行扫描被驱动表的所有数据进行比较。
- 缺点:完全没有利用索引,I/O 开销极大,效率最低。除非数据量极小,否则应避免。
第二种:Index Nested-Loop Join (NLJ)
当被驱动表的连接字段上有合适索引时,MySQL 会优先采用此算法。
- 流程:
- 从驱动表读入一行数据 R。
- 取出 R 中的连接字段值,对被驱动表进行树搜索 (Tree Search)(如 B+ 树查找)。
- 获取被驱动表满足条件的行,与 R 组成结果集的一部分。
- 重复上述步骤,直到驱动表遍历完毕。
第三种:Block Nested-Loop Join (BNLJ)
当被驱动表的连接字段没有索引或索引失效时,MySQL 才会退而求其次使用 BNLJ。
- 机制:引入
join_buffer_size缓冲区(默认 256KB,可通过show variables like 'join_%'查看)。 - 流程:
- 将驱动表中符合条件的列一次性读取到
join_buffer中。 - 缓存满后,顺序扫描一次被驱动表的所有行,并与缓冲区中的所有值进行比较。
- 将比较结果加入最终结果集。
- 若缓冲区不满或仍有数据,重复上述过程。
ALL, index, range 或 index_merge 时才会使用。它通过“以空间换时间”减少被驱动表的扫描次数(从 N*M 次降至 M+N+K 次)。JOIN 性能优化实战
理解了原理后,我们可以针对性地进行优化。核心目标是将算法从 BNLJ 转化为 NLJ,并减少循环次数。
1. 确保连接字段有索引
这是最关键的一点。如果 EXPLAIN 显示被驱动表的访问类型不是 ref, eq_ref 或 const,说明未走索引。务必在关联字段上建立索引,从而让 MySQL 能够使用 Index Nested-Loop Join。
2. 小表驱动大表
虽然 MySQL 优化器通常会自动选择小表作为驱动表,但在复杂查询或使用了 Straight Join 时需手动确认。驱动表的数据量越小,嵌套循环的次数就越少,整体性能越高。
3. 适当增大 join_buffer_size
对于必须使用 Block Nested-Loop Join 的场景(如无法加索引的情况),调大 join_buffer_size 可以让缓冲区容纳更多驱动表的列,从而减少对外层表的扫描轮次。
- 风险提示:Buffer 是线程级的,并发量大时内存消耗显著,切勿设置过大,建议仅在特定优化场景中临时调整或通过会话变量设置。
4. 避免隐式类型转换与编码不一致
若连接字段类型不同(如一边是 VARCHARINT) 或字符集不同,MySQL 可能会在运行时进行隐式转换。这会导致索引失效,迫使查询回退到低效的全表扫描。务必保持两端字段类型一致。
5. 使用 EXPLAIN 验证执行计划
在修改 SQL 前,始终使用 EXPLAIN 关键字分析执行计划。重点关注:
type:是否为ALL(全表扫描)。理想情况应为ref或index。key:实际使用的索引。rows:预估扫描行数。
以上就是 MySQL JOIN 使用原理、执行算法及优化方案的详细内容,更多关于数据库高性能查询的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















