


MySQL字符集与排序规则详解:解决乱码及修改配置

深入解析MySQL字符集与排序规则的核心概念,掌握从查询现状到修改配置的全流程操作。重点对比utf8mb3与utf8mb4的区别,解释排序规则后缀含义,提供解决中文乱码问题的具体步骤与SQL命令。
MySQL字符集基础与版本差异
在数据库开发中,字符集的选择直接决定了数据的存储效率与显示效果。了解不同版本的默认策略是解决乱码的前提:
- MySQL 8.0 之前:默认字符集通常为
latin1。若未手动调整,插入中文字符极易出现乱码。此时开发者常将字符集修改为utf8(实为utf8mb3)以兼容中文。 - MySQL 8.0 及之后:默认字符集升级为
utf8mb4。它支持完整的 Unicode 标准,能存储包括 Emoji 表情在内的 1~4 字节字符,从根本上解决了乱码及部分特殊符号无法存储的问题。
查看与排查当前字符集状态
在进行任何修改前,首先需要确认服务器、客户端及连接的当前字符集设置。以下是通用的查询语句:
show variables like 'character%';
-- 或者模糊匹配
show variables like '%char%';
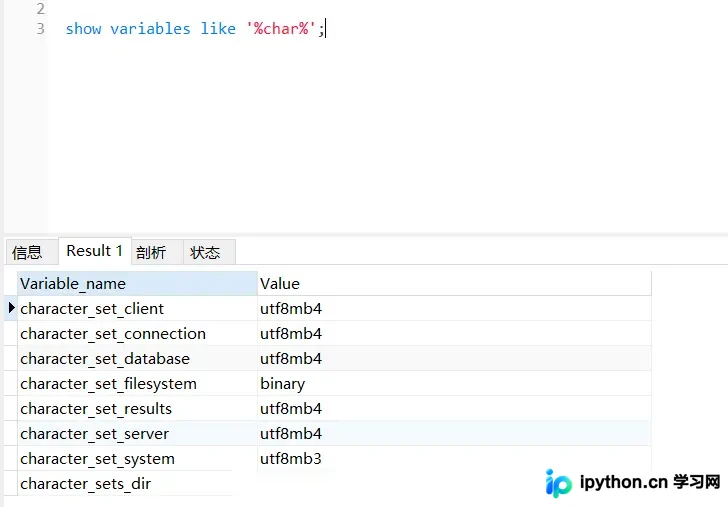
图1:MySQL 8.0版本查询默认字符集变量
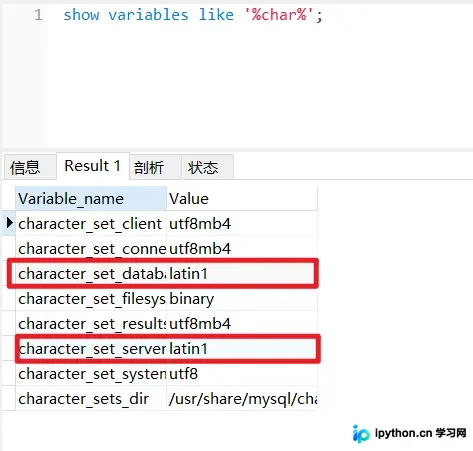
图2:MySQL 5.7版本查询默认字符集变量
执行上述命令后,重点关注以下三个关键变量,它们共同决定了数据传输的编码过程:
character_set_client:客户端发送请求时使用的字符集(解码端点)。character_set_connection:服务器接收请求后,将其从客户端字符集转换到的临时字符集。character_set_results:服务器返回结果给客户端时使用的字符集(编码端点)。
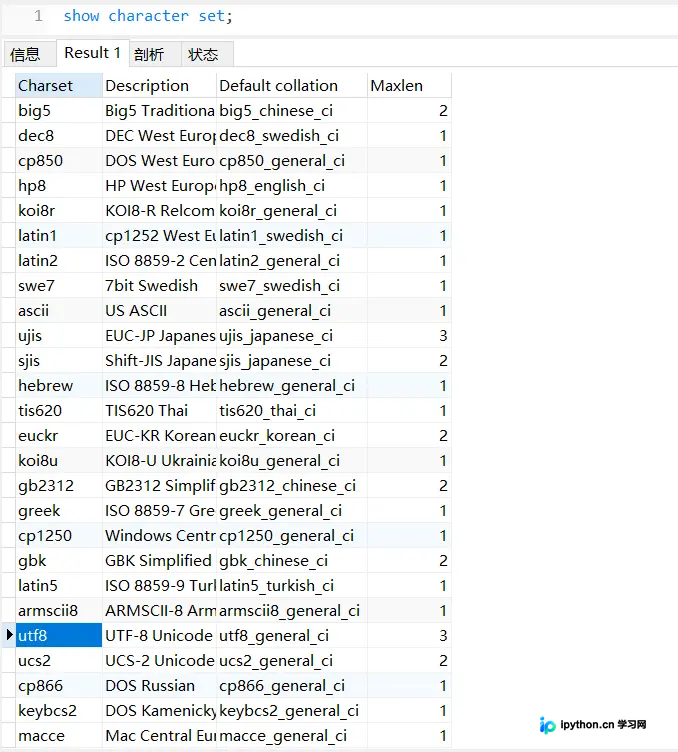
此外,使用 SHOW CHARSET; 或 SHOW CHARACTER SET; 可以查看服务器支持的完整字符集列表及其最大字节长度。结果通常包含四列:Name(字符集名称)、Default Collation(默认排序规则)、Max Len(最大字节数)等。
修改字符集配置的方法
若发现默认字符集不符合要求(如 MySQL 5.7 使用 utf8mb3),可通过工具或修改配置文件进行永久更改。
第1步:修改配置文件(推荐)
修改配置文件是确保服务重启后配置生效的最稳定方式。需要编辑 my.cnf(Linux/Unix)或 my.ini(Windows)文件。
操作步骤如下:
- 找到配置文件路径。在 Linux 系统中,通常为
/etc/my.cnf。 - 在
[mysqld]段落下添加或修改以下参数:
[mysqld]
character_set_server=utf8mb4
init_connect='SET NAMES utf8mb4'
建议设置为 utf8mb4 以获得最佳兼容性
- 保存文件并重启 MySQL 服务使配置生效:
systemctl restart mysqld.service第2步:通过 SQL 语句修改现有库表
如果不想重启服务,或者只希望针对特定数据库/表进行修改,可使用以下 SQL 命令。请注意,修改后新建的对象会应用新规则,但已存在的表不会自动变更,需单独处理。
-- 查看特定数据库的创建语句(含字符集信息)
SHOW CREATE DATABASE 数据库名;

-- 修改数据库默认字符集和排序规则
ALTER DATABASE 数据库名 DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;

-- 修改表的字符集(可选,通常配合 CONVERT TO 使用)
ALTER TABLE 表名 CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
理解字符集的比较规则(Collation)
字符集决定了如何存储数据,而排序规则(Collation)决定了数据如何比较和排序。每个字符集都有多种排序规则,后缀标识了其特性:
| 后缀 | 英文释义 | 含义描述 |
|---|---|---|
_ai |
Accent Insensitive | 不区分重音(例如 á 和 a 视为相同) |
_as |
Accent Sensitive | 区分重音 |
_ci |
Case Insensitive | 不区分大小写(A 和 a 相同) |
_cs |
Case Sensitive | 区分大小写 |
_bin |
Binary | 二进制比较,逐字节对比,速度最快但严格区分大小写和字符形态 |
常见规则选择建议:
utf8_general_ci:较老的标准,校对速度快,准确度略低。对于大多数纯英文或简单中文应用,使用此规则足够。utf8_unicode_ci:更符合 Unicode 标准,准确度更高,但计算稍慢。如果应用涉及德语、法语、俄语等多语言混合环境,强烈建议使用此规则以确保字符比较的正确性。
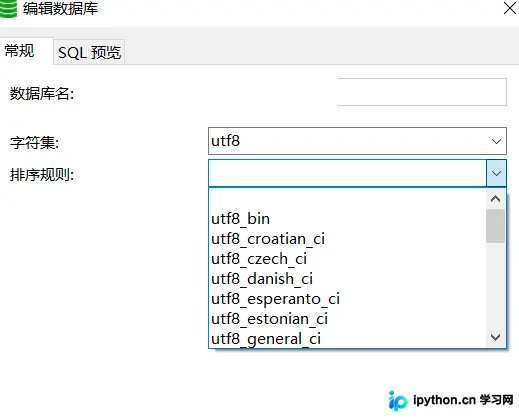
在使用 Navicat 等图形化工具时,可以在新建数据库或表时直观地看到当前的字符集和排序规则下拉选项,便于快速配置。
总结
正确配置 MySQL 字符集是避免乱码的关键。现代开发应优先采用 utf8mb4 作为默认字符集,并根据业务需求选择合适的排序规则(一般推荐 utf8mb4_unicode_ci)。通过修改 my.cnf 文件或执行 ALTER 语句均可完成配置更新,但在生产环境中修改已有数据的字符集需谨慎备份。
以上就是MySQL基础学习之字符集的应用的详细内容,更多关于MySQL字符集的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















