


MySQL中 REPLACE INTO 与 INSERT ... ON DUPLICATE KEY UPDATE 的深度对比

在处理 MySQL 数据插入且涉及唯一键冲突时,开发者常纠结于 REPLACE INTO 与 INSERT ... ON DUPLICATE KEY UPDATE 的选择。本文将通过实际 SQL 操作演示这两者的运行机制,重点剖析它们对自增主键(Auto Increment)以及非参与更新字段的影响差异,帮助您在编写高并发或批量数据脚本时做出更合理、安全的决策。
测试环境准备
为了直观感受两者的差异,我们需要一个具备自增主键和多列数据的表结构。首先初始化测试数据:
mysql> CREATE TABLE t1 SELECT 1 AS a, 'c3' AS b, 'c2' AS c;
ALTER TABLE t1 CHANGE a a INT PRIMARY KEY AUTO_INCREMENT ;
-- 结果: Query OK, 1 row affected (0.03 sec)
此时表结构与初始数据如下:
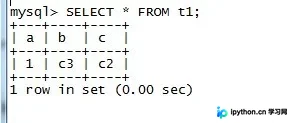
接着插入两条额外数据,丰富测试样本:
mysql> INSERT INTO t1 SELECT 2,'2', '3';
Query OK, 1 row affected (0.01 sec)
Records: 1  Duplicates: 0  Warnings: 0

mysql> insert into t1(b,c) select 'r2','r3';
Query OK, 1 row affected (0.08 sec)
Records: 1  Duplicates: 0  Warnings: 0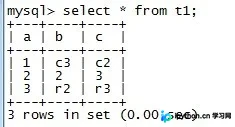
第一部分:REPLACE INTO 的执行逻辑
REPLACE INTO 的底层实现非常直接,它本质上是一个组合操作:先 DELETE,再 INSERT。
第1步:执行冲突替换操作
我们尝试使用主键 a=2 进行覆盖,只更新字段 b,不指定 c:
mysql> REPLACE INTO t1(a,b) VALUES(2,'a') ;
Query OK, 2 rows affected (0.06 sec)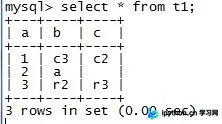
注意观察返回结果:虽然修改了1行数据,但系统提示 2 rows affected,这印证了其内部包含了“删除原记录”和“插入新记录”两步动作。
第2步:验证字段残留与 Auto Increment 变化
执行后查看 a=2 的记录:字段 b 更新为 'a',但原本存在值的 c 字段变成了 NULL(或空串,取决于版本和定义)。这是因为作为新插入的记录,未指定的字段填充了默认值。
随后插入一条无主键限制的记录,观察自增值的变化:
mysql> insert into t1(b,c) select 'r4','r5';
Query OK, 1 row affected (0.05 sec)

mysql> select * from t1;
+---+----+----+
| a | b | c |
+---+----+----+
| 1 | c3 | c2 |
| 2 | a | NULL |
| 3 | r2 | r3 |
| 5 | r4 | r5 |
+---+----+----+
可以发现,新的自增值跳到了 5(上一轮最大为3,中间4被replace消耗掉),说明 REPLACE 操作同样会触发自增序列的推进。
第二部分:INSERT ... ON DUPLICATE KEY UPDATE 的执行逻辑
INSERT ... ON DUPLICATE KEY UPDATE 是一种原子性的更新/插入操作,仅在发生键冲突时执行后续的 UPDATE 语句。
第3步:执行合并更新操作
再次针对 a=3 执行操作:
mysql> insert into t1(a,b) select '3','r5' on duplicate key update b='r5';
Query OK, 2 rows affected, 1 warning (0.19 sec)
查询结果显示:
+---+----+----+
| a | b  | c  |
+---+----+----+
| 3 | r5 | r3 |
+---+----+----+
与 REPLACE 截然不同,ON DUPLICATE KEY UPDATE 操作仅改变了 UPDATE 声明中涉及的字段(即 b),而未被提及的 c 字段完好无损地保留了旧值 'r3'。
第4步:验证其自增行为
再次插入一条普通记录,观察主键:
mysql> insert into t1(b,c) select 'r6','r7';
Query OK, 1 row affected (0.19 sec)

select * from t1;
+---+----+----+
| a | b  | c  |
+---+----+----+
...
| 7 | r6 | r7 |  <-- 下一个ID是7,说明前一步操作导致计数器增加
+---+----+----+
即便没有插入全量新记录,单纯的 “更新” 分支也导致了 Auto Increment 的累加。这意味着该语句在底层并非简单的单行 UPDATE,而是走了一套类似 “占位并递增” 的逻辑以处理原子性冲突。
总结与安全建议
经过对比测试,我们可以得出以下核心结论:
- 完全一致点:当唯一键不存在时,两者都等价于普通
INSERT;当发生冲突时,两者都会使自增主键(Auto Increment)数值 +1。 - 本质区别:
-REPLACE INTO是先删后插:旧记录的整行数据被丢弃,新记录仅包含REPLACE语句中显式声明的字段,其余字段按表定义填入默认值。
-INSERT ... ON DUPLICATE KEY UPDATE是定向更新:它保留了旧记录中未声明更新字段的全部历史数据,只应用UPDATE子句中的变更。
风险提示:由于 REPLACE 会擦除非指定字段的原始内容,在实际业务开发中,若表中含有时间戳、统计计数或外部关联等敏感字段,贸然使用 REPLACE 极易造成隐性数据丢失。
综上所述,除非你有意清除冗余数据并需要极高的执行效率(REPLACE 在某些场景下略快),否则 INSERT ... ON DUPLICATE KEY UPDATE 提供了更细粒度的控制能力和更高的数据安全系数。建议在处理重要业务数据时优先使用后者的写法。
以上就是 MySQL Replace into 与 Insert on duplicate key update 深度对比的详细内容,更多关于 MySQL 高级操作及性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















