


深入理解 MySQL 聚集索引:原理、选择规则与性能影响

在 MySQL 中,了解聚集索引对于数据库性能优化至关重要。它不仅是 InnoDB 引擎数据存储的基础,更直接决定了主键访问效率、范围查询速度以及数据更新时的碎片化程度。本文将解析聚集索引的核心机制及选型规则。
聚集索引与非聚集索引的本质区别
在 MySQL 生态中,不同存储引擎对数据的组织方式截然不同。InnoDB 采用索引组织表(Index Organized Table, IOT),即“聚集”索引组织表;而 MyISAM 则采用堆组织表(Heap Organized Table, HOT)。
简而言之:
- 聚集索引(Clustered Index):索引的键值逻辑顺序直接决定了表中数据行的物理存储顺序。这意味着数据行和索引节点紧密绑定,通常将整张表视为一个大的聚集索引结构。
- 非聚集索引(Secondary Index):即普通索引。它仅在独立的数据结构中保存列值和对应的主键引用,不改变数据行的物理存储位置,查找时往往需要“回表”。
IOT 与 HOT 的主要性能差异体现在以下方面:
IOT(索引组织表)的优势
- 范围查询高效:由于数据按主键顺序连续存储,范围查询(如 BETWEEN、>、<)只需读取相邻的物理块,效率极高。
- 减少磁盘碎片:在主键自增或单调递增的场景下,新数据追加在末尾,不易产生页分裂和碎片。
- 热点数据访问快:适合少量记录频繁读写的场景,因为相关记录物理上可能邻近。
- 主键直达:通过主键查询数据时,直接命中叶子节点即可获取完整行数据,无需额外步骤。
IOT 的潜在不足
如果业务场景主要基于离散的非主键字段进行插入或更新,会导致频繁的页分裂和数据移动,此时 IOT 的性能可能不如 HOT。
HOT(堆组织表)的局限
MyISAM 等堆表没有聚集索引概念,数据按写入时间随机分布。这导致:1. 索引回表开销大,每次非索引列查询都需额外的磁盘 IO 获取完整行;2. 随机读取多,无法保证顺序读取,缓存命中率相对较低。
InnoDB 聚集索引的选择规则
每张 InnoDB 表只能有一个聚集索引。当表结构设计完成后,InnoDB 引擎会按照严格的优先级确定哪个索引作为聚集索引:
- 首选显式主键:如果表中定义了
PRI(PRIMARY KEY),无论该主键是单列还是组合列,它都将自动成为聚集索引。 - 次选唯一非空索引:若未定义主键,InnoDB 会选择第一个定义为
UNIQUE且所有列均不允许为NULL的索引作为聚集索引。 - 兜底隐含 ROWID:如果上述两种情况都不存在,InnoDB 会在内部自动生成一个隐藏的
ROWID(通常是 6 字节的单调递增整数),并以此作为默认的聚集索引。
重要结论:主键必然是聚集索引(在 InnoDB 中),但聚集索引不一定是主键(例如隐式 ROWID 场景)。理解这一规则有助于我们规范建表语句。
InnoDB 主键索引的底层结构
结合 InnoDB 的 B+ 树实现,聚集索引的叶子节点存储着完整的数据行信息。以下是其典型结构的示意:
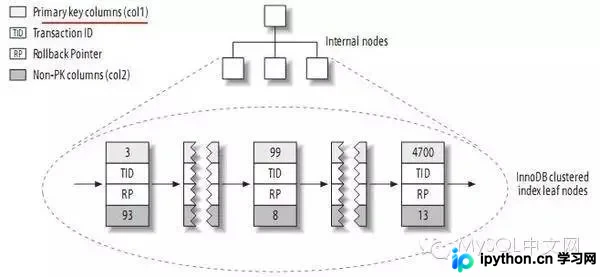
从图中可以清晰看到,InnoDB 索引树的叶子节点中:
- Key(键值):存储的是主键的值。
- Value(数据项):存储了除主键外的其余所有列数据。
- 额外信息:还包括事务 ID(trx id)、rollback pointer(回滚指针)等用于 MVCC 和事务控制的元数据。
这种设计使得 InnoDB 的主键查询非常迅速,因为查找到索引叶子节点的同时,也就获取了所需的全部数据,省去了二次查询的步骤。
总结
合理使用聚集索引是 MySQL 优化的基础。在设计表结构时,应尽量利用自增主键或有序业务键来构建聚集索引,以发挥范围查询的高效优势并减少碎片。同时,明确 InnoDB 的索引选择规则,避免因缺乏主键而导致系统使用隐藏 ROWID 带来的不可控性。
以上就是 MySQL 聚集索引原理、选型规则及性能影响的详细内容,更多关于 MySQL 索引优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















