



在 C++ 里,数字输出看似只是 `cout << value`,但一旦进入报表、科学计算、日志或可视化场景,默认格式往往并不够用。本文从基础概念讲到高级封装,结合代码示例说明精度、小数位数、记数法、对齐和填充的控制方法,也会补上流状态恢复、性能注意点和常见错误处理,方便你根据业务场景选出合适的格式化策略。
什么是精度操纵器
精度操纵器本质上是 C++ I/O 流上的一组修饰符,用来控制数值在输出时的显示方式。它最常见的用途是处理浮点数,但并不只限于“小数保留几位”,还包括记数法切换、宽度控制、对齐方式和填充字符设置。
在实际开发中,这类控制通常出现在以下场景:
- 科学计算结果输出,需要明确保留位数或使用科学记数法;
- 财务报表和统计结果展示,需要稳定、统一的数字格式;
- 工程计算和监控日志,需要兼顾可读性与精度;
- 数据可视化前的数据整理,需要让输出结果更容易比对。
它能控制哪些内容
- 精准控制小数位数;
- 灵活选择浮点表示形式;
- 在默认、定点、科学记数法之间切换;
- 设置字段宽度、填充字符和左右对齐。
常见操纵器一览
| 操纵器 | 功能 | 示例 |
|---|---|---|
setprecision() | 用于控制小数位数 | cout << setprecision(2) |
fixed | 启用定点记数法 | cout << fixed |
scientific | 采用科学记数法 | cout << scientific |
基础用法:先看 `setprecision()`、`fixed` 和 `scientific`
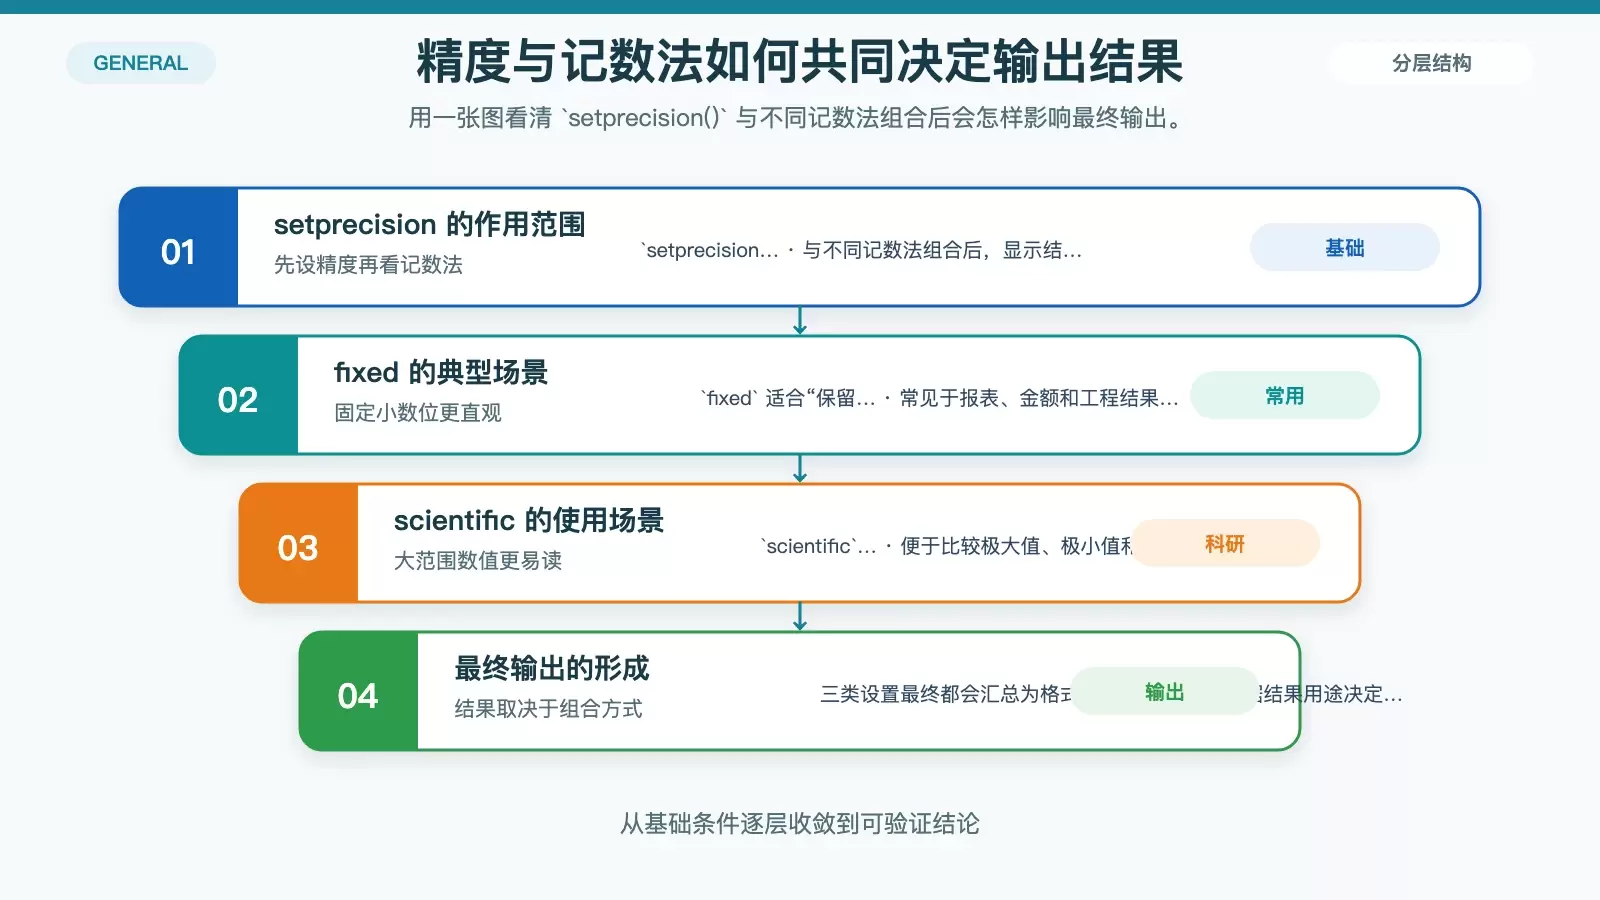
如果你刚开始接触精度控制,最值得先掌握的是这三个操纵器。它们决定了一个浮点数究竟以什么形式显示,以及显示到什么程度。
#include <iostream>
#include <iomanip>

int main() {
    double value = 123.456789;

    // 默认输出
    std::cout << "默认:" << value << std::endl;

    // 使用setprecision
    std::cout << "精度2: "
              << std::setprecision(2) << value << std::endl;

    // 定点记数法
    std::cout << "定点记数法:"
              << std::fixed << value << std::endl;

    // 科学记数法
    std::cout << "科学记数法:"
              << std::scientific << value << std::endl;

    return 0;
}
这里有一个容易混淆的点:setprecision() 的效果会受到当前记数法影响。单独使用时,它控制的是有效数字位数;与 fixed 一起使用时,通常更符合“保留几位小数”的直觉;与 scientific 一起使用时,则作用在科学记数法的尾数显示上。
基础格式化的处理流程
graph TD
    A[输入值] --> B{精度设置}
    B --> |setprecision| C[小数位数控制]
    B --> |fixed| D[定点记数法]
    B --> |scientific| E[科学记数法]
    C --> F[输出格式化]
    D --> F
    E --> F
除了精度,还能控制哪些格式
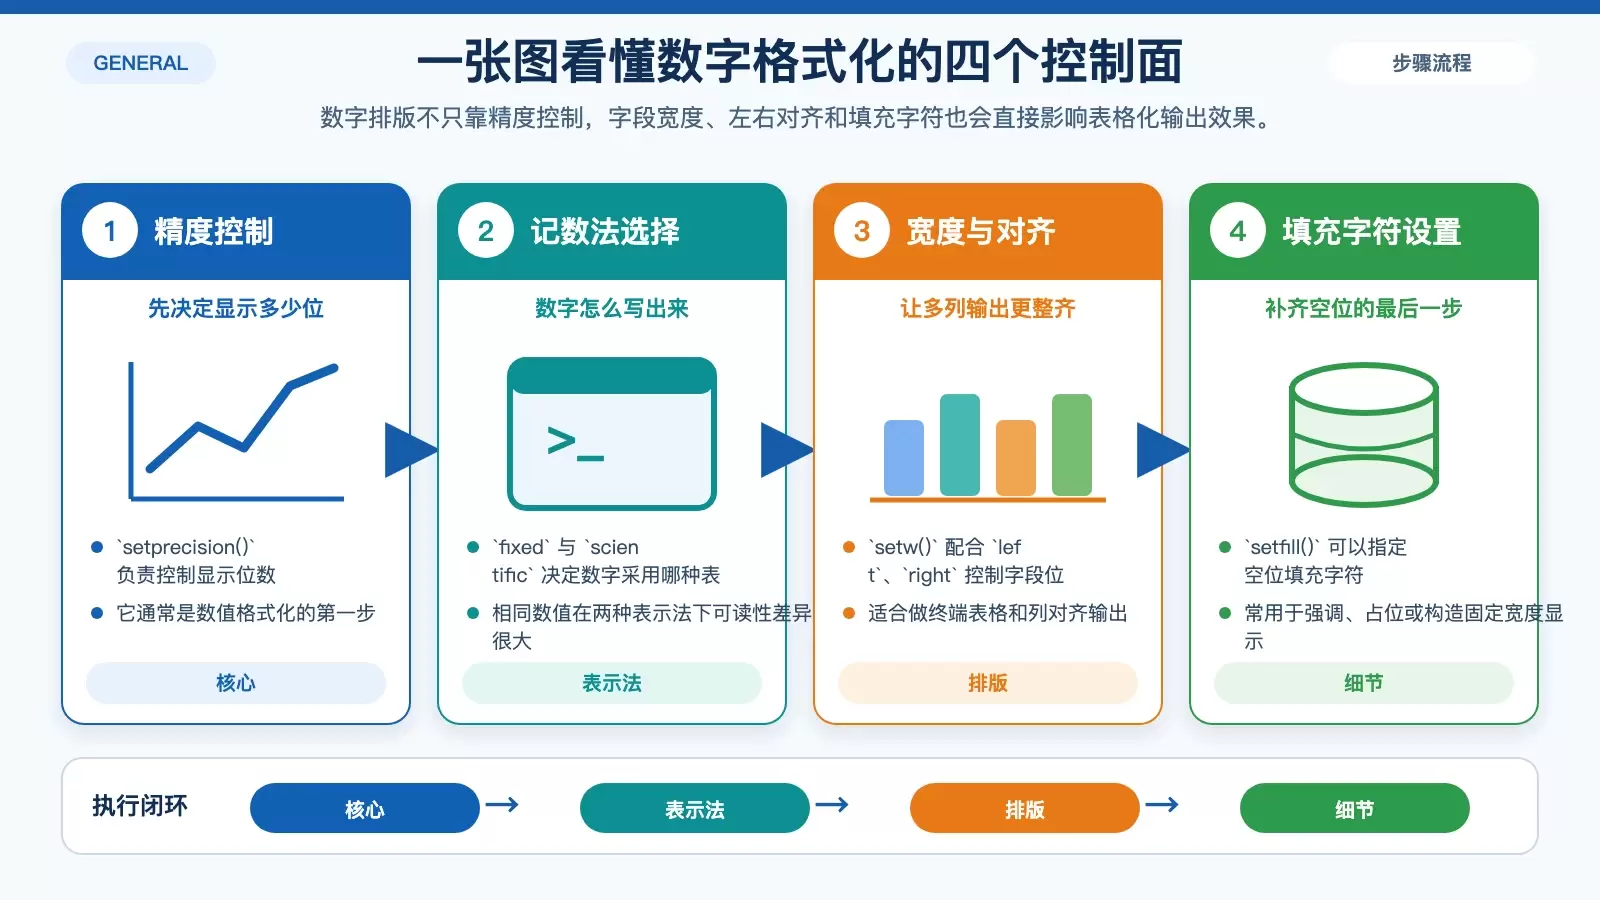
当需求从“保留两位小数”升级为“做出能直接放进终端报表的整齐输出”时,就需要把宽度、对齐和填充一起用起来。
常见格式化类别
| 类别 | 用途 | 关键操纵器 |
|---|---|---|
| 精度控制 | 控制小数位数 | setprecision() |
| 记数法风格 | 选择数字表示形式 | fixed, scientific |
| 对齐方式 | 确定输出位置 | setw(), left, right |
| 填充 | 设置填充字符 | setfill() |
综合代码示例
#include <iostream>
#include <iomanip>

int main() {
    double pi = 3.14159265358979323846;

    // 精度和记数法控制
    std::cout << std::fixed << std::setprecision(4)
              << "固定精度:" << pi << std::endl;

    std::cout << std::scientific << std::setprecision(2)
              << "科学记数法:" << pi << std::endl;

    // 宽度和对齐演示
    std::cout << std::setw(20) << std::right
              << "右对齐:" << pi << std::endl;

    std::cout << std::setw(20) << std::left
              << "左对齐:" << pi << std::endl;

    // 填充示例
    std::cout << std::setfill('*') << std::setw(20)
              << std::right << pi << std::endl;

    return 0;
}
需要注意的是,setw() 通常只对紧随其后的那一次输出生效,而 fixed、scientific、setfill() 这类设置往往会持续影响后续输出,直到你再次修改它们。
格式化决策是怎么组合起来的
graph TD
    A[输入值] --> B{格式化决策}
    B --> |精度| C[小数位数]
    B --> |记数法| D[固定/科学]
    B --> |对齐方式| E[左/右]
    B --> |填充| F[填充字符]
    C --> G[输出格式化]
    D --> G
    E --> G
    F --> G
进阶控制:流状态、封装与区域设置
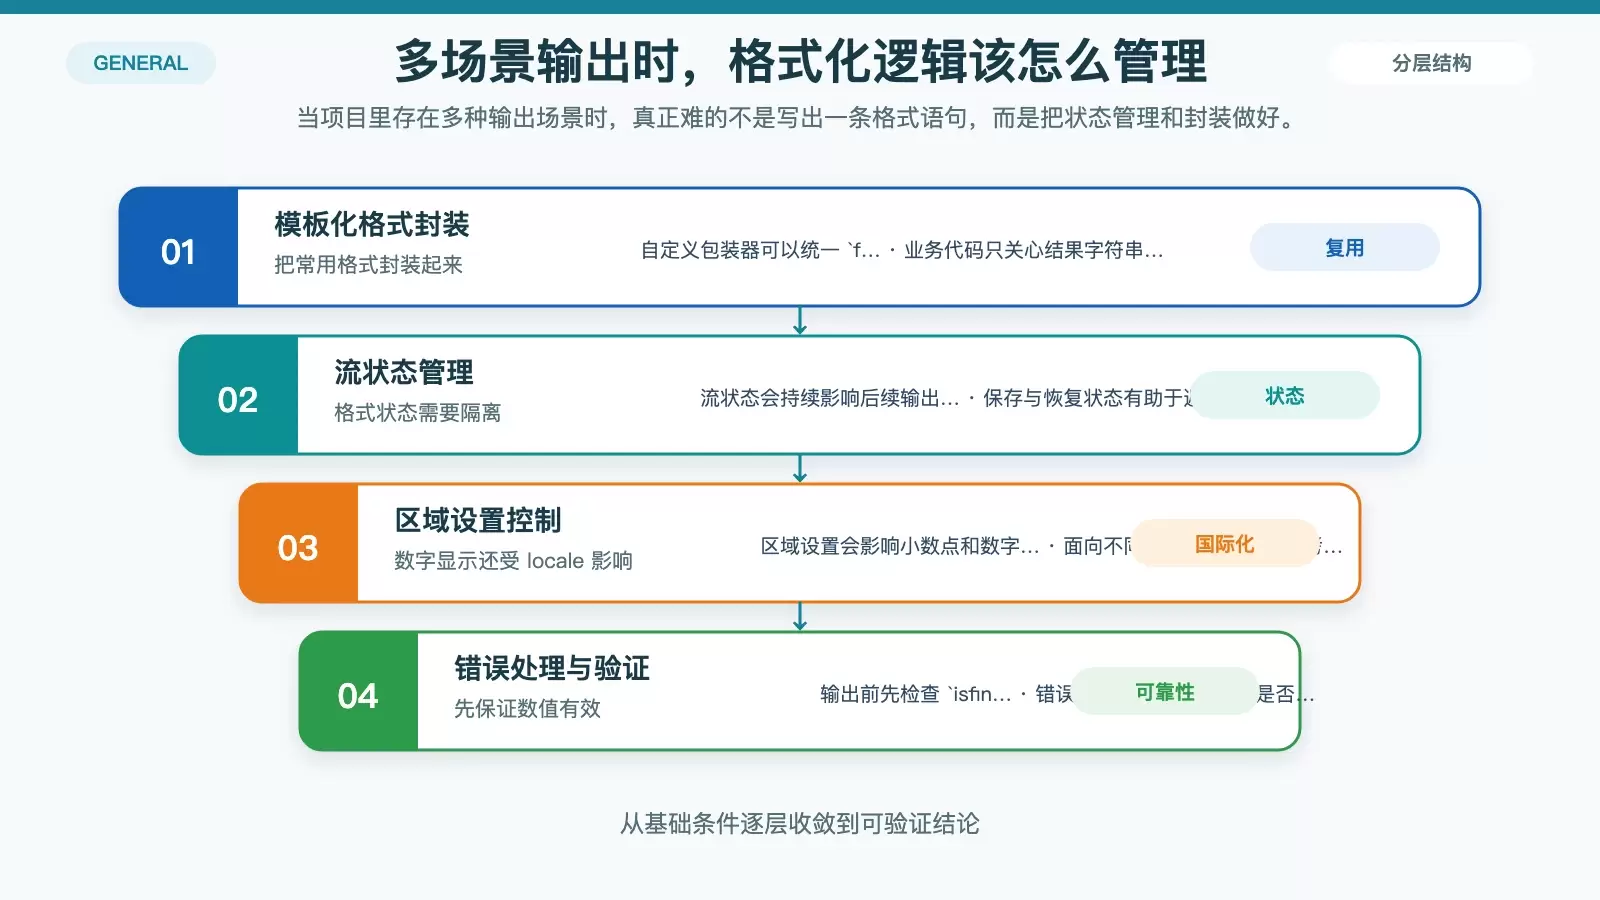
当一个程序里有多种输出场景时,单纯在各处直接拼操纵器很容易让格式状态互相污染。更稳妥的做法,是把常用格式封装起来,并在必要时保存和恢复流状态。
为什么要管理流状态
- 保存和恢复流状态,便于在多个格式场景之间切换;
- 进行临时格式化修改,而不影响其他输出;
- 及时重置为默认配置,保证输出结果一致。
自定义格式化包装器示例
template <typename T>
std::string formatNumber(T value, int precision, bool scientific = false) {
    std::ostringstream stream;

    if (scientific) {
        stream << std::scientific << std::setprecision(precision);
    } else {
        stream << std::fixed << std::setprecision(precision);
    }

    stream << value;
    return stream.str();
}
这种写法适合把“输出策略”从业务逻辑中抽离出来。调用方只需要关心结果字符串,不必在每个地方重复拼接 std::fixed、std::scientific 和 std::setprecision()。
涉及国际化时的区域设置控制
#include <iostream>
#include <iomanip>
#include <sstream>
#include <locale>

class PrecisionManager {
private:
    std::locale original_locale;

public:
    void configureLocale() {
        std::locale::global(std::locale("en_US.UTF-8"));
    }

    void resetLocale() {
        std::locale::global(original_locale);
    }
};
如果你的程序面向不同地区用户,数字中的小数点、千位分隔符等显示方式就可能受到区域设置影响。这类需求已经超出单纯的“保留几位小数”,需要把格式化和 locale 一起考虑。
高级格式化流程
graph TD
    A[输入值] --> B{高级格式化}
    B --> C[模板格式化]
    B --> D[区域设置配置]
    B --> E[流状态管理]
    C --> F[输出处理]
    D --> F
    E --> F
性能与错误处理要注意什么
精度操纵器本身不复杂,但在高频输出、日志系统或大批量数据处理里,格式化成本和异常值处理都值得单独考虑。
性能考量
- 尽量减少不必要的格式化操作,避免频繁改动流状态;
- 根据实际需求选择合适的精度级别,避免过度精确;
- 评估格式化带来的计算开销,尤其是在循环和批处理场景中。
编译时精度计算示例
template <int Precision>
class CompileTimePrecision {
public:
    template <typename T>
    static std::string format(T value) {
        std::ostringstream stream;
        stream << std::fixed << std::setprecision(Precision) << value;
        return stream.str();
    }
};

// 用法示例
auto result = CompileTimePrecision<3>::format(3.14159);
这类方式并不会让所有格式化都变成“零成本”,但在精度固定、调用频繁的场景里,确实有助于减少运行时决策。
错误处理示例
#include <iostream>
#include <iomanip>
#include <limits>

void safeNumericOutput(double value) {
    if (std::isfinite(value)) {
        std::cout << std::fixed << std::setprecision(2)
                  << "安全输出:" << value << std::endl;
    } else {
        std::cerr << "无效数值" << std::endl;
    }
}
输入验证示例
template <typename T>
bool validateNumericFormat(const T& value, int max_precision) {
    return std::isfinite(value) &&
           std::to_string(value).length() <= max_precision;
}
至少要先处理 NaN、无穷大以及异常范围值,否则即使格式写得再完整,输出结果也可能没有业务意义。
实际场景里怎么选更合适
把这些操纵器放回真实业务环境里,选择通常可以按场景判断:
- 财务报告:优先考虑
fixed加固定小数位,保证展示稳定; - 科学计算:大范围数值更适合
scientific,便于比较数量级; - 工程输出:根据上下文在可读性和精度之间做平衡;
- 统计分析或表格终端输出:配合
setw()、left、right和setfill()统一排版。
无论具体用哪一种,以下几点基本都适用:
- 始终确保包含
<iomanip>头文件; - 在使用完操纵器后,及时重置状态,避免影响后续输出;
- 在整个项目中保持一致的格式风格;
- 对不同格式化场景做完整测试,确认输出结果稳定可靠。
总结
C++ 精度操纵器的核心价值,不只是“让数字少显示几位”,而是让输出结果在准确性、可读性和一致性之间达到合适平衡。入门时先掌握 setprecision()、fixed 和 scientific,进阶后再引入 setw()、setfill()、流状态管理和封装策略,基本就能覆盖大多数数值展示需求。
如果你的代码已经开始同时处理报表、日志、国际化显示和高频格式化输出,那么把格式化逻辑集中管理,往往比在每一行 cout 上临时拼接操纵器更可靠。















