


Python使用for循环遍历字符串逐个获取字符的指南

在Python数据处理中,逐个提取字符串中的字符是清洗文本、校验密码或进行字符级加密的基础操作。Python内置的for循环能够自动触发对象的迭代协议,以最高效且安全的方式完成这一任务。本文将系统梳理遍历字符串的核心机制,通过统计字母、位移变换等真实案例展示代码写法,并提供利用enumerate获取索引、使用list.join()替代累加以提升性能的进阶方案,彻底解决遍历过程中的边界与安全陷阱。
Python字符串遍历的核心机制
Python中的str是一种不可变序列类型。尽管字符串在内存中以连续字节存储,但在逻辑层面它是一个有序的Unicode字符集合。Python的设计哲学强调“简单优于复杂”,因此无需像C语言那样手动管理索引计数器,直接使用for循环即可遍历。
当执行for char in string:时,Python内部会自动调用该字符串的 __iter__() 方法创建一个迭代器。每次循环迭代,迭代器返回下一个字符的值并赋值给变量,直到抛出StopIteration异常时循环自动终止。这意味着开发者只需关注字符本身的业务逻辑,而无需处理起始偏移量或长度边界。
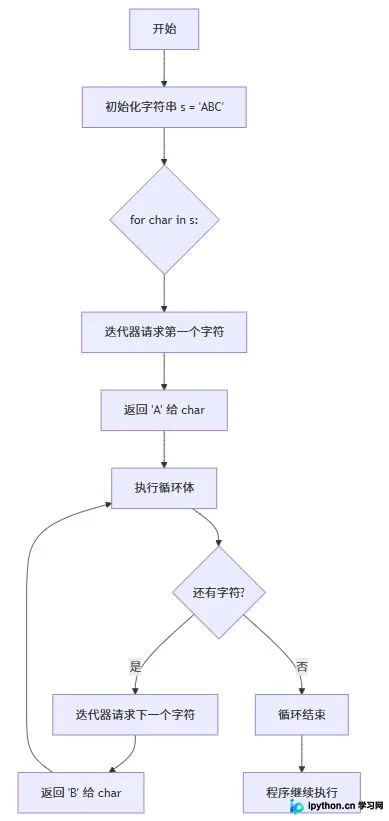
基础操作:使用for循环逐个提取字符
掌握直接迭代的语法是编写高质量Python代码的第一步。变量名建议使用具象名称(如char或c),以增强语义可读性。
第1步:声明标准遍历结构并输出
通过以下基础示例,可以快速观察到循环如何自动捕获并传递每一个字符:
text = "Python"
for char in text:
    print(f"当前字符: {char}")

# 预期输出:
# 当前字符: P
# 当前字符: y
# ...依次类推至 'n'
典型应用场景与代码实现
在实际开发中,单纯的打印往往无法满足需求。通常需要结合条件判断、累加器或外部数据结构来完成字符处理任务。
第2步:执行字符过滤与频次统计
例如,在密码强度检测或数据清洗阶段,经常需要统计特定字符(如元音字母)的出现次数,或者计算各字符的频率。此时可直接在循环体中进行计数:
def count_vowels(text):
    """统计字符串中元音字母的数量"""
    vowels = "aeiouAEIOU"
    count = 0
    for char in text:
        if char in vowels:
            count += 1
    return count

sample = "Hello World! 你好,Python!"
print(f"元音数量: {count_vowels(sample)}")
# 输出: 元音数量: 5
在处理字符频率统计时,推荐使用字典来累积数据。对于大量文本,建议在循环外部定义好初始容器,以避免频繁的空指针判定:
def char_frequency(text):
    freq = {}
    for char in text:
        # 直接更新数值,简化逻辑
        freq[char] = freq.get(char, 0) + 1
    return freq

result = char_frequency("banana")
for char, count in result.items():
    print(f"'{char}': {count}次")
第3步:构建字符级变换逻辑
针对诸如凯撒密码(Caesar Cipher)等需要改变字符ASCII码值的场景,遍历同样能发挥核心作用。利用ord()获取字符编码并配合模运算% 26实现字母表内的循环位移:
def caesar_cipher(text, shift):
    result = ""
    for char in text:
        if char.isalpha():
            base = ord('A') if char.isupper() else ord('a')
            new_char = chr((ord(char) - base + shift) % 26 + base)
            result += new_char
        else:
            result += char
    return result

plaintext = "Hello Python!"
encrypted = caesar_cipher(plaintext, 3)
print(f"加密: {encrypted}")  # 输出: Khoor Sbwkrq!
进阶优化:提升代码效率与可读性
在处理长文本或复杂项目时,基础的线性遍历可能不够灵活。Python提供了多种工具函数来丰富遍历行为。
第4步:获取索引位置与多串同步处理
当业务逻辑强依赖字符所在位置时,引入enumerate()是最Pythonic的做法。它能在一行内同时吐出当前索引和字符值,避免了冗长的数学推导:
text = "Python"
for index, char in enumerate(text):
    print(f"位置 {index}: 字符 '{char}'")
如果需要将两个字符串的字符一一对应(例如对比两段相同长度的文本),可以使用zip():
s1 = "abc"
s2 = "123"
for char1, char2 in zip(s1, s2):
    print(f"{char1} -> {char2}")
第5步:规避频繁拼接带来的内存开销
由于Python中的字符串是不可变的,如果在循环中反复使用+=拼接新字符,Python会在每次迭代时申请新的内存空间,这会导致时间复杂度呈平方级增长O(n²)。正确的实践是使用列表收集字符,最后合并:
def reverse_string_optimized(s):
    new_chars = []
    for char in s:
        new_chars.append(char)
    # 一次性分配内存并完成拼接,速度快上百倍
    return ''.join(reversed(new_chars))
常见问题排查与避坑指南
即使是非常简单的语法,新手也容易陷入由索引管理不当或对象状态引发的陷阱。
警惕IndexError与非法边界检查
手动使用while循环或range(len())时,极易出现小于等于<= len(s)的错误边界条件,导致取值越界引发崩溃。坚持使用for char in s可以直接杜绝此类越界问题。
理解字符串的不可变性限制
字符串一旦创建便无法在原地被修改。如果在循环中试图调用类似s.replace(),原变量并不会发生改变,只会产生新的临时对象。如果需要改造字符串内容,必须按照上面的示例,通过新建变量或列表的方式重新构建完整的字符串序列。
不要在遍历中就地增删元素
虽然字符串本身安全,但如果你的遍历对象切换成了列表(List),绝对禁止在for item in my_list:的过程中执行.remove()或.pop()操作,这会造成跳过元素或索引错乱。务必提前创建副本,或使用列表推导式过滤。
结语
遍历字符串不仅仅是获取单个字符的手段,更是数据清洗、算法实现和安全校验的基石。掌握直接迭代的基础能力,配合enumerate定位、zip对齐以及基于列表的高效拼接,即可应对绝大多数工程场景中的文本挑战。
以上就是Python使用for循环遍历字符串逐个获取字符的详细内容,更多关于Python for循环遍历字符串的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















