


Python读取CSV时怎么跳过指定行或只选特定列

在Python中处理CSV文件时,若直接将整个文件完整载入内存,常会遇到冗余数据过多、内存消耗过大或读取耗时过长的问题。最直接的解决方式是在读取阶段进行过滤:利用Pandas库的skiprows参数跳过文件开头说明行或指定行号,配合usecols参数只加载目标数据列;若在不依赖外部库的原生环境中,则可使用标准库csv模块,通过next()跳过前置行并用索引或字典键筛选目标字段。本文将分别介绍这两种方案的具体用法、匹配规则与注意事项。
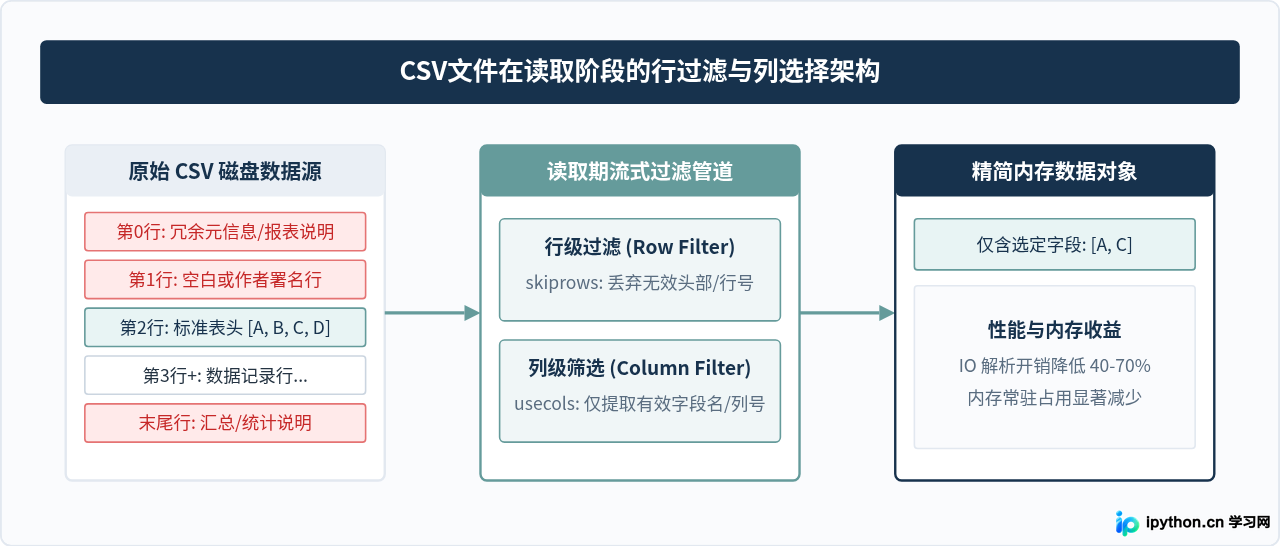
一、为什么必须在读取阶段过滤数据
许多由业务系统或自动化报表导出的CSV文件并非纯净的矩阵结构。它们往往包含前置说明文字、空行、尾部汇总说明,或者包含几十甚至上百个字段。如果在读取时不加甄别:
- 解析错误:非规范的说明行常包含不规则逗号,会导致解析器因列数不匹配而直接报错。
- 内存浪费:若只需分析其中的2个字段,完整读入全部无用列会使内存峰值成倍上涨,严重时会引发内存溢出。
- 二次处理繁琐:读取后再在代码里执行
drop()删行删列,会产生多次数据复制与无谓开销。
二、使用 Pandas 读取:灵活控制行与列
在数据分析场景中,pandas.read_csv() 提供了成熟且功能全面的行跳过(skiprows)与列筛选(usecols)参数。
1. skiprows 参数的三种常用方式
skiprows 支持传入整数、行号列表或可调用函数:
- 传入整数 N:表示跳过文件开头的前 N 行。例如前两行为报表说明,第三行才是真正的表头,则设置
skiprows=2。 - 传入列表:表示跳过指定的行索引(注意:以0为起始行号)。例如
skiprows=[0, 2, 4]将跳过物理文件的第1、第3与第5行。 - 传入函数(Callable):对每一行的行索引进行判断。函数返回
True的行将被跳过,返回False的行被保留。
import pandas as pd

# 示例 1: 跳过前 2 行说明信息,第 3 行作为表头
df_offset = pd.read_csv("sales_data.csv", skiprows=2)

# 示例 2: 跳过指定的物理行号(如第 0 行和第 5 行)
df_specific_rows = pd.read_csv("sales_data.csv", skiprows=[0, 5])

# 示例 3: 使用函数跳过偶数行(保留第 0 行表头及奇数行)
df_func = pd.read_csv("sales_data.csv", skiprows=lambda x: x > 0 and x % 2 == 0)
2. usecols 参数的常用用法
usecols 用于指定需要解析的列子集,不仅能减少内存开销,还能加快解析速度:
- 传入列名列表:指定需要读取的列名称,例如
usecols=['user_id', 'pay_amount']。 - 传入列索引列表:按列的位置序号选取,例如
usecols=[0, 3]只读取第 1 列和第 4 列。 - 传入函数:根据列名规则动态筛选,例如
usecols=lambda col: col.startswith("amt_")。
# 示例 4: 结合使用 skiprows 与 usecols
df_selected = pd.read_csv(
    "sales_data.csv",
    skiprows=2,                                # 跳过前两行干扰信息
    usecols=["user_id", "status", "revenue"]   # 只读取这三列
)
print("读取成功,数据集结构:", df_selected.shape)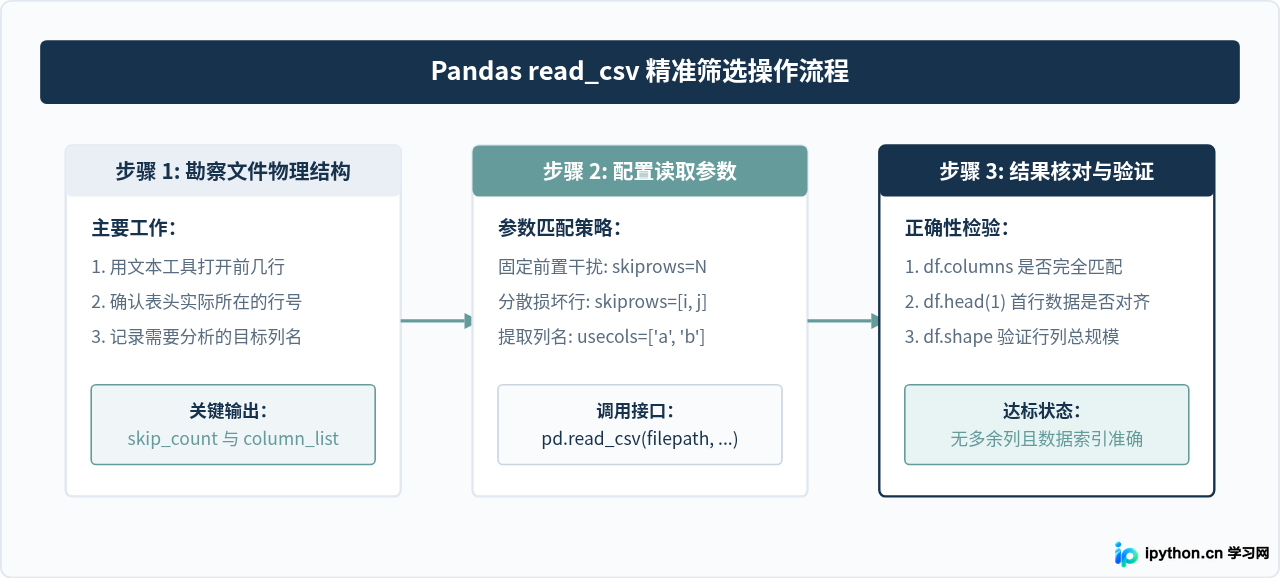
三、使用 Python 标准库 csv 实现原生流式筛选
当运行环境无法安装Pandas或需要维持极小依赖时,Python自带的 csv 模块是首选方案。由于标准库属于逐行读取的流式迭代器,筛选逻辑更加直观。
1. 跳过指定行的两种原生做法
处理流式读取器时,行指针是顺序向后推进的:
- 使用
next()函数:若只想跳过开头固定的前 N 行,直接调用 N 次next(reader)即可将指针推移。 - 使用
enumerate()配合行号判断:若需要跳过离散行或根据行号动态过滤,可在遍历循环中根据行索引跳过。
import csv

with open("sales_data.csv", "r", encoding="utf-8") as f:
    reader = csv.reader(f)

    # 做法 A: 明确跳过前两行(如标题说明与空行)
    next(reader)  # 跳过第 0 行
    next(reader)  # 跳过第 1 行

    # 此时下一次读取将获得标准表头
    headers = next(reader)
    print("解析出的表头:", headers)

    # 做法 B: 结合 enumerate 跳过特定行
    for row_idx, row in enumerate(reader):
        if row_idx in [3, 7]:  # 过滤特定脏数据行
            continue
        # 处理正常数据行...
2. 提取特定列的原生方式
标准库支持按列表索引提取,或使用 csv.DictReader 按字典键提取:
# 方式一:使用 csv.reader 按索引提取指定列
with open("sales_data.csv", "r", encoding="utf-8") as f:
    reader = csv.reader(f)
    # 假设目标列为第 0 列 (ID) 和第 2 列 (金额)
    target_indices = [0, 2]

    selected_rows = []
    for row in reader:
        if row:  # 忽略空行
            selected_rows.append([row[i] for i in target_indices])

# 方式二:使用 csv.DictReader 提取指定字段字典
with open("sales_data.csv", "r", encoding="utf-8") as f:
    # 若存在前置说明行,先用 f.readline() 移走,再传给 DictReader
    f.readline()
    f.readline()

    dict_reader = csv.DictReader(f)
    desired_fields = ["user_id", "revenue"]

    for row in dict_reader:
        filtered_item = {k: row[k] for k in desired_fields if k in row}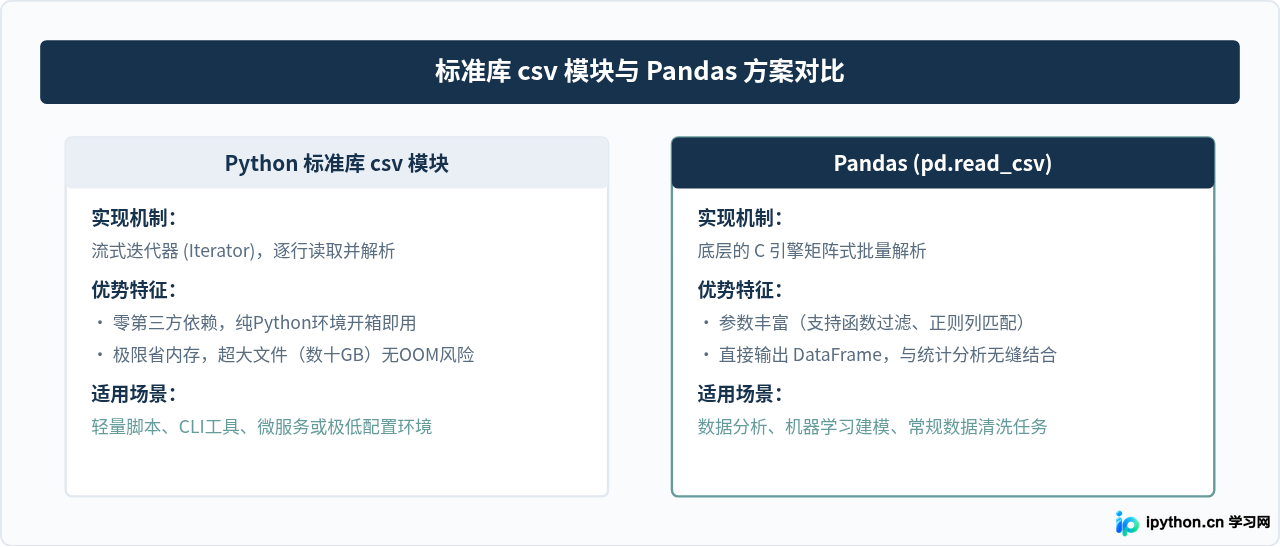
四、常见问题与避坑指南
skiprows 接收的行号是以 0 为基准(0-based)的物理文件行号,包含表头行。
1. 跳过行时表头位置变动
当使用 skiprows=N 跳过前 N 行后,Pandas 默认会将剩余内容中的第一行自动推断为列名(header)。如果你在跳过 N 行后,文件本身没有表头行,或者你希望自定义列名,必须显式声明 header=None, names=['col1', 'col2', ...],否则第一条真实数据记录会被当作表头消耗掉。
2. usecols 传入列名与缺失异常
如果向 usecols 传入了文件中不存在的列名,Pandas 会直接抛出 ValueError: Usecols do not match columns。在自动化批处理多个CSV时,若各文件列名可能略有差异,建议使用传入函数的方式做弹性容错:
# 容错提取:只读取存在于目标集合中的列
valid_columns = {"user_id", "status", "price"}
df = pd.read_csv("data.csv", usecols=lambda c: c in valid_columns)
3. 注释行与空行的特殊处理
如果CSV文件中散落着以 # 开头的注释行,不需要手动计算行号传给 skiprows,可以直接使用 comment='#' 参数;如果文件包含空白行,配合 skip_blank_lines=True(默认已开启)即可自动跳过。
五、总结
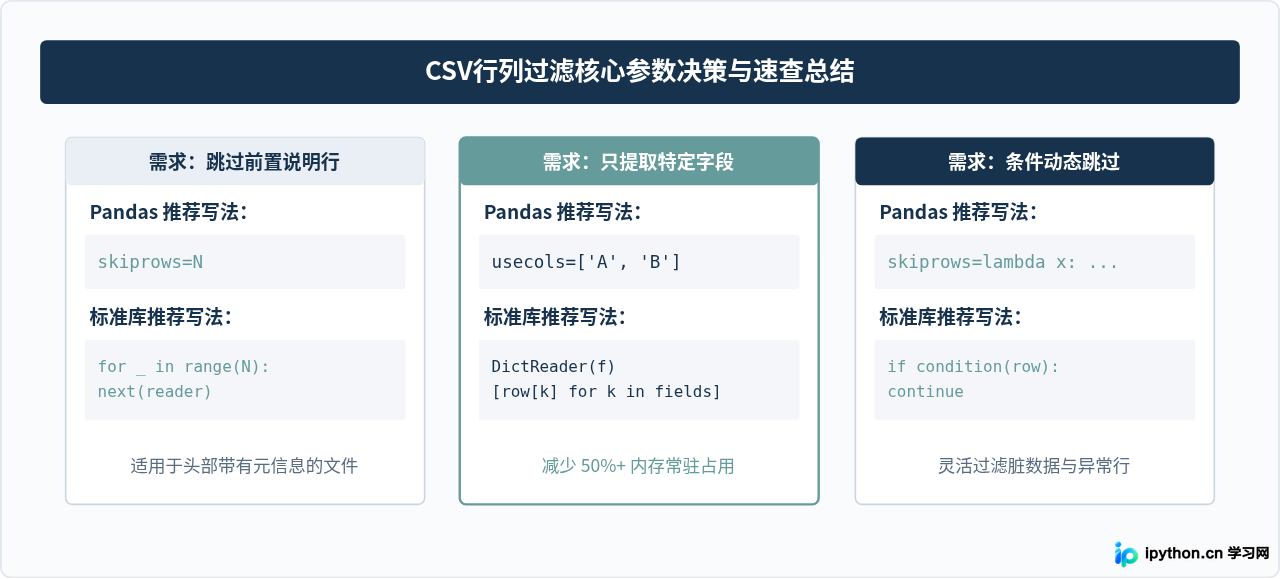
掌握读取阶段的过滤技巧,是编写健壮、高效数据处理代码的基本功。对于常规分析与探索任务,优先选择 pandas.read_csv() 并搭配 skiprows 与 usecols,语法简洁且执行高效;而在无额外依赖、追求极低内存占用的生产服务或批处理管道中,使用原生 csv.reader 或 csv.DictReader 配合流式迭代,可以实现同样精确的控制。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















