


适合自学入门的Python岗位有哪些?自动化测试与数据分析助理求职指南

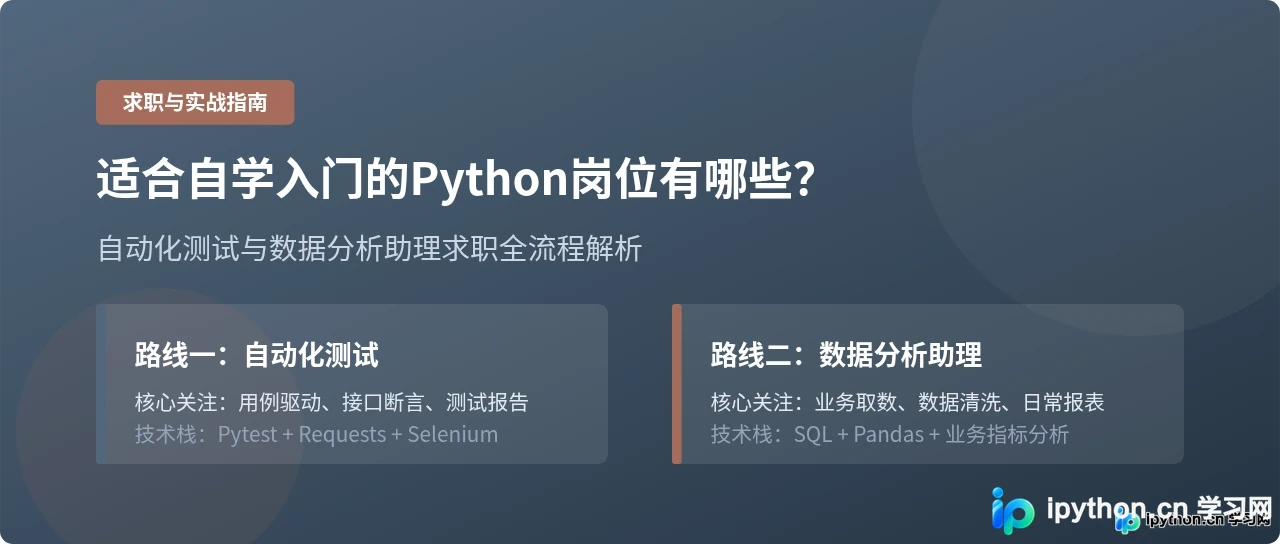
对于没有计算机专业背景、依靠自主学习 Python 的求职者而言,直接竞争全栈 Web 开发或算法工程师岗位往往会面临底层网络原理、数据结构与高并发系统经验的严苛筛选。在当前的用人市场中,“自动化测试(尤其是接口与功能回归)”与“数据分析助理(或业务数据支持)”是容错率更高、投入产出比更清晰的两条路径。本文将拆解这两个岗位的日常职责、核心技术栈、操作实践与作品集搭建策略。
一、为什么优先选择这两类岗位?
自学编程最常见的误区是试图复刻大学四年的培养体系,或者在没有工程实战环境的前提下死磕复杂的底层框架二开。企业招聘初级技术人员时,看重的核心能力是“能否立即接手重复性劳动并保证产出准确”。
自动化测试和数据分析助理之所以适合作为自学者的切入点,本质在于其工作输出通常有极其明确的验收指标:
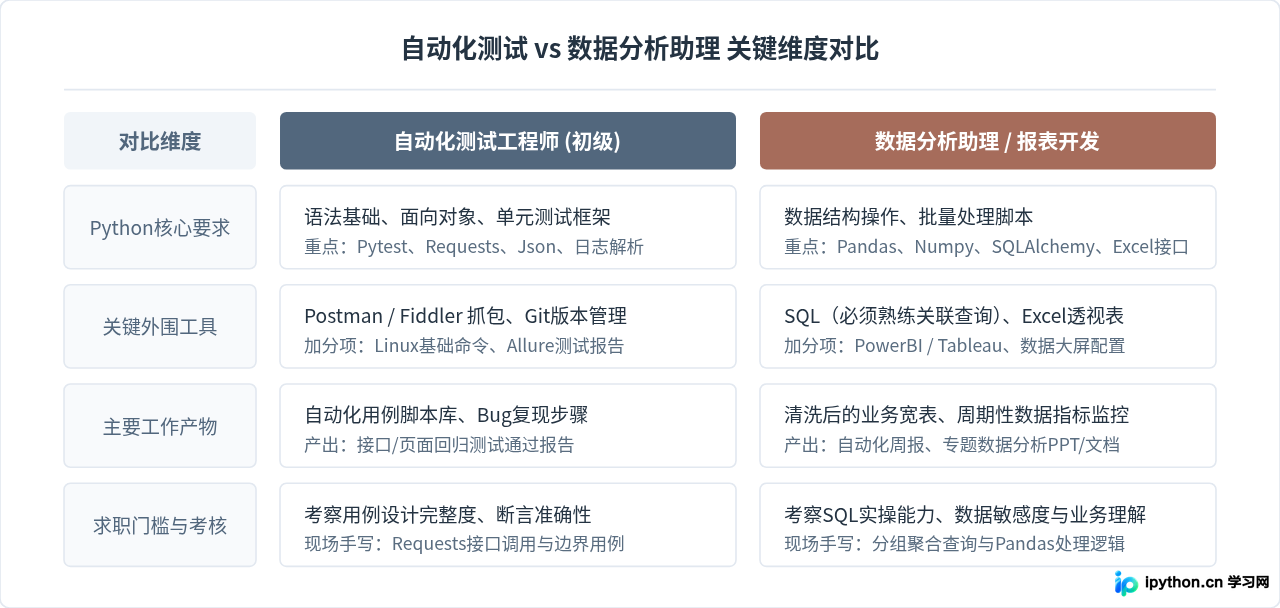
- 自动化测试:输入是业务功能或接口文档,输出是测试用例脚本与执行通过率报告。逻辑判断围绕“预期值与实际值是否一致”展开,重点在于细致、边界覆盖和工具运用。
- 数据分析助理:输入是分散的业务日志、数据库表格或 Excel 文件,输出是经过清洗整理的结构化宽表与周期性汇报图表。重点在于准确提取数据、排除异常值,并解释指标波动的业务含义。
二、路线一:自动化测试岗位的学习与求职落地
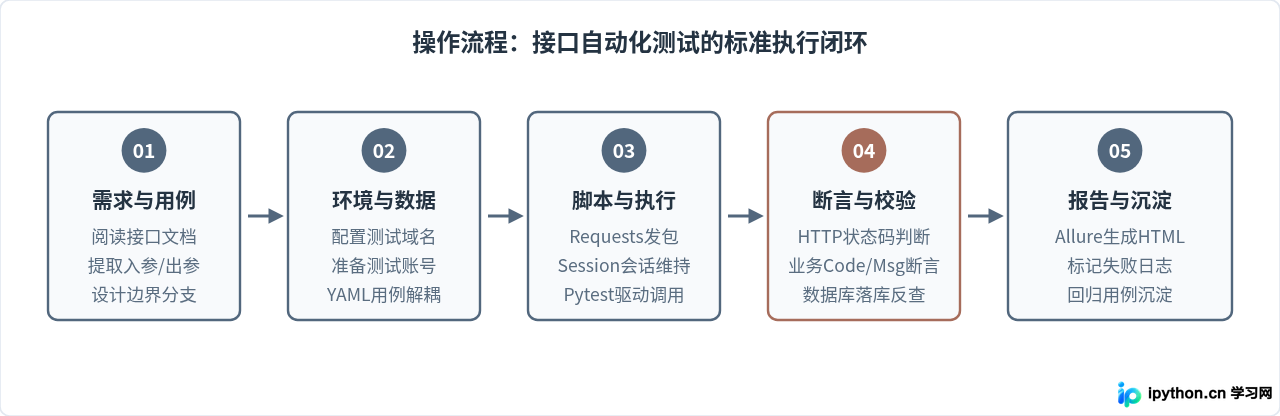
自动化测试工程师的职责并非从零开发庞大的测试平台,而是把手工测试人员需要反复点击、核对的日常工作脚本化。初级岗位主要负责两块工作:HTTP接口自动化测试与基于浏览器的UI回归测试。其中,接口测试由于执行稳定、见效快,是面试中最常考察的模块。
1. 核心技术栈拆解
- Python基础与规范:掌握函数封装、模块导入、异常处理(
try...except)以及json/os/pathlib等常用标准库。 - Pytest框架:理解测试用例命名规则、
fixture夹具进行前置准备与后置清理、参数化(@pytest.mark.parametrize)以实现数据驱动测试。 - 网络与接口请求:熟练使用
requests库发送 GET/POST 请求、处理 Session 鉴权、提取 Token 并传递给后续接口。 - 辅助技能:使用 Chrome DevTools 或 Charles 抓包分析请求参数与响应头,使用 Git 管理脚本版本。
2. 真实测试脚本范例
在实际编写测试代码时,必须关注数据解耦与多重断言。以下是一个标准的接口自动化测试示例,展示了如何组织测试类并对返回数据进行校验:
# test_user_api.py
import pytest
import requests

class TestUserLogin:
    base_url = "https://api.example.com"

    @pytest.mark.parametrize("payload, expected_status, expected_code", [
        ({"username": "valid_user", "password": "correct_pwd"}, 200, 0),
        ({"username": "valid_user", "password": "wrong_pwd"}, 200, 1001),
        ({"username": "", "password": "some_pwd"}, 400, 1002),
    ])
    def test_login_scenarios(self, payload, expected_status, expected_code):
        url = f"{self.base_url}/v1/auth/login"
        headers = {"Content-Type": "application/json"}

        response = requests.post(url, json=payload, headers=headers, timeout=5)

        # 1. 验证 HTTP 协议层状态码
        assert response.status_code == expected_status, f"HTTP状态码不符: {response.status_code}"

        # 2. 验证业务响应体
        res_data = response.json()
        assert res_data.get("code") == expected_code, f"业务返回码不符: {res_data}"

        if expected_code == 0:
assert "token" in res_data.get("data", {}), "成功登录但未返回有效 token"三、路线二:数据分析助理岗位的学习与求职落地
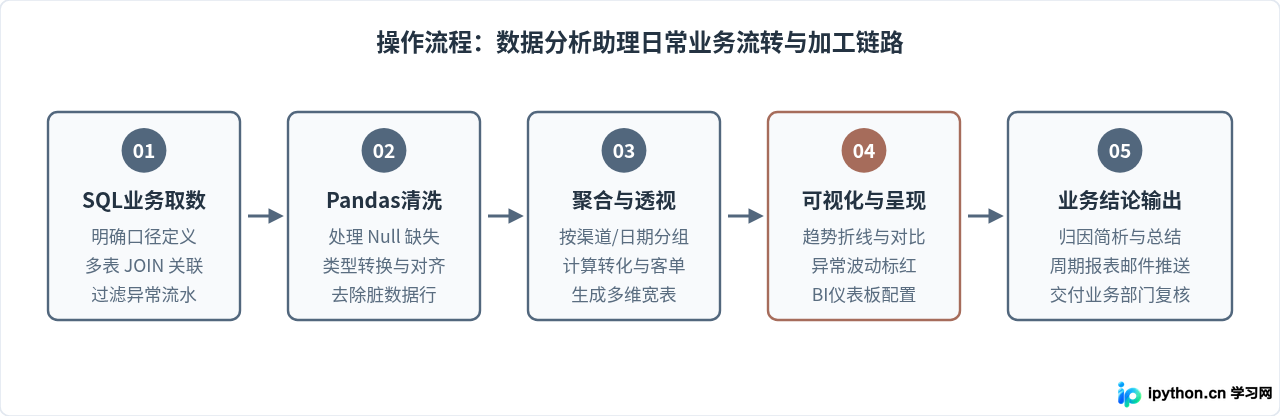
数据分析助理的核心价值在于分担业务分析师或数据专家的基础工作:定期从数据库拉取数据、进行清洗整理、填补或剔除脏数据,并按业务维度输出分析表。这个岗位不需要自学者掌握复杂的深度学习或大模型微调,但对数据的准确性有着极高要求。
1. 核心技术栈拆解
- SQL(生命线技能):在求职面试中,初级数据岗对 SQL 的考察频次往往超过 Python 本身。必须掌握单表过滤、
GROUP BY聚合、JOIN多表关联、以及常用的窗口函数(如ROW_NUMBER())。 - Pandas & Numpy:熟练使用 Pandas 读取 CSV / Excel / 数据库,处理缺失值与重复值,进行多级索引重塑、分组统计(
groupby().agg())和透视表(pivot_table)制作。 - 报表自动化:能够编写脚本批量合并几十个格式相同的销售/运营表格,自动生成排版工整的周报,减少人工反复复制粘贴的时间。
- 业务指标常识:理解留存率、转化率、客单价、GMV、漏斗流失等基础商业概念,不把分析工作做成纯数学计算。
2. 真实数据清洗与聚合脚本范例
在实际业务中,最频繁的任务是从原始订单数据中清洗脏数据并计算分渠道转化指标。以下是具有参考价值的 Pandas 实战代码片段:
# process_orders.py
import pandas as pd
import numpy as np

# 1. 加载脱敏后的原始订单记录
raw_df = pd.read_csv("orders_sample.csv")

# 2. 清洗阶段:日期标准化与异常值过滤
raw_df["pay_time"] = pd.to_datetime(raw_df["pay_time"], errors="coerce")
clean_df = raw_df.dropna(subset=["pay_time", "user_id"]).copy()

# 过滤支付金额异常数据(如测试产生的负数或极端异常值)
clean_df = clean_df[(clean_df["amount"] > 0) & (clean_df["amount"] < 50000)]

# 3. 特征构建:提取支付日期与时段
clean_df["pay_date"] = clean_df["pay_time"].dt.date
clean_df["channel"] = clean_df["channel"].fillna("未知渠道")

# 4. 业务指标聚合:按渠道与日期统计订单量、GMV及客单价
report_df = clean_df.groupby(["pay_date", "channel"]).agg(
    order_count=("order_id", "nunique"),
    total_gmv=("amount", "sum"),
    unique_buyers=("user_id", "nunique")
).reset_index()

# 计算综合客单价
report_df["arpu"] = (report_df["total_gmv"] / report_df["unique_buyers"]).round(2)

# 5. 输出格式化结果
report_df.to_excel("daily_channel_report.xlsx", index=False)
print("自动化日常渠道汇总报表生成完毕。")
四、求职作品集搭建与面试通关指南
自学求职者最大的劣势在于没有相关履历背书,因此一份能够让人一眼看清技术能力的代码作品集是获得面试机会的关键。作品集不追求庞大,但必须具备“真实感、完整性、规范性”。
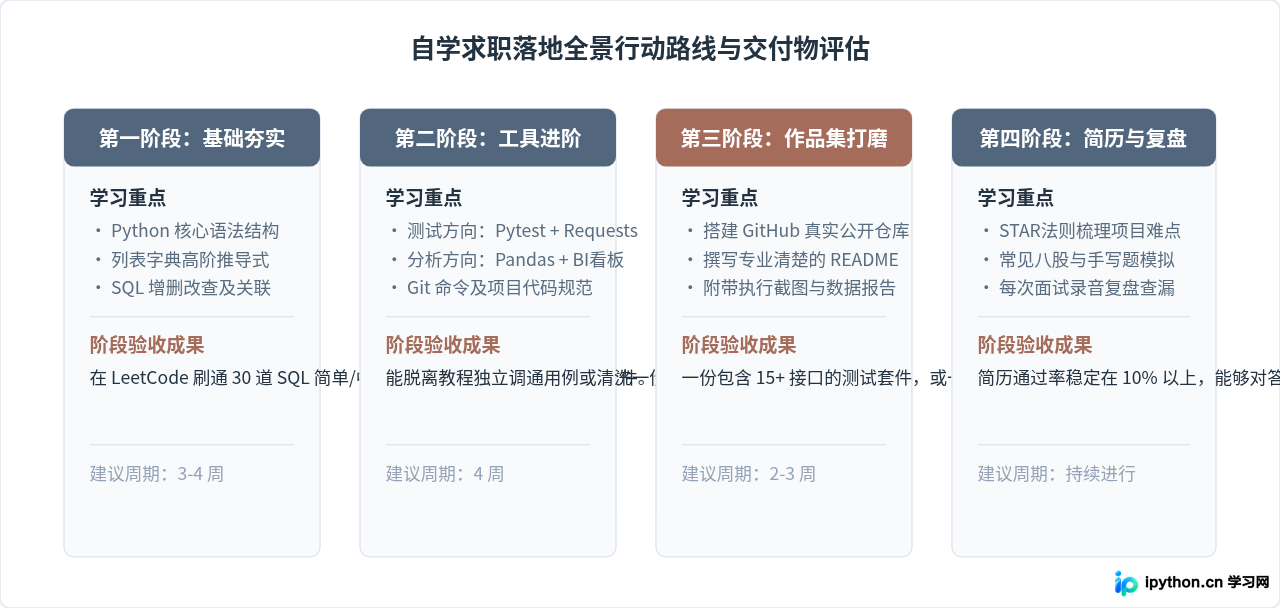
项目展示的核心要点
在 GitHub 或求职简历中展示自己的项目时,务必包含以下三项内容,切忌只放几段没有说明的代码文件:
- 清晰的 README 文档:用两三百字交代该项目解决什么业务场景(例如:“基于电商开源后台接口的 Pytest 自动化测试套件”或“某零售品牌 2023 年度全渠道经营数据分析与周报自动化”)。
- 一键复现方式:提供
requirements.txt,列出依赖库及版本,并附上一行运行命令(如pytest -v --html=report.html或python main.py)。 - 执行产物直观呈现:直接在仓库中放上生成的 HTML 测试报告截图,或者导出的 Excel / 数据图表截图,让不会克隆代码的 HR 也能秒懂项目的完整度。
五、常见问题排查与求职答疑
Q1:非相关专业且无工作经验,简历怎么写才不会被秒拒?
答:不要写空泛的“熟练掌握 Python”。把重心放在项目经历上,用动词+业务工具+量化结果组织语言。例如:“基于 Pytest + Requests 搭建接口测试用例库,编写 40+ 条核心场景用例,涵盖鉴权、订单与退款分支,并结合 Allure 生成自动化执行报告”;或者“使用 SQL 与 Pandas 完成 50 万条电商订单的清洗与聚合,输出日周维度的渠道转化报表,利用 Python 实现邮件自动化推送”。
Q2:学到什么程度才可以开始投递简历?
答:很多自学者陷入了“永远觉得没准备好”的焦虑中。只要你能够:① 独立写出完整的 Requests 请求并做断言,或者独立写出包含 GROUP BY 与 JOIN 的 SQL 语句;② 掌握常用数据类型操作,并在本地运行过完整的项目;就可以开始投递初级助理岗位。在面试的实际问答中发现自己的短板,针对性复盘,进步速度远快于闭门造车。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















