


Python运行速度慢是电脑配置不够吗?硬件资源与代码效率排查

许多开发者在遇到Python脚本运行耗时过长时,第一反应往往是怀疑当前电脑的CPU不够强劲或内存容量偏小。然而在绝大多数实际工程中,单凭升级硬件配置并不能显著改善运行速度。Python的动态特性、解释执行机制,以及代码中不合理的算法设计和资源访问模式,往往才是拖慢执行效率的根源。搞清楚程序到底是受制于物理硬件瓶颈,还是陷入了低效的代码逻辑,是系统化解决性能问题的第一步。
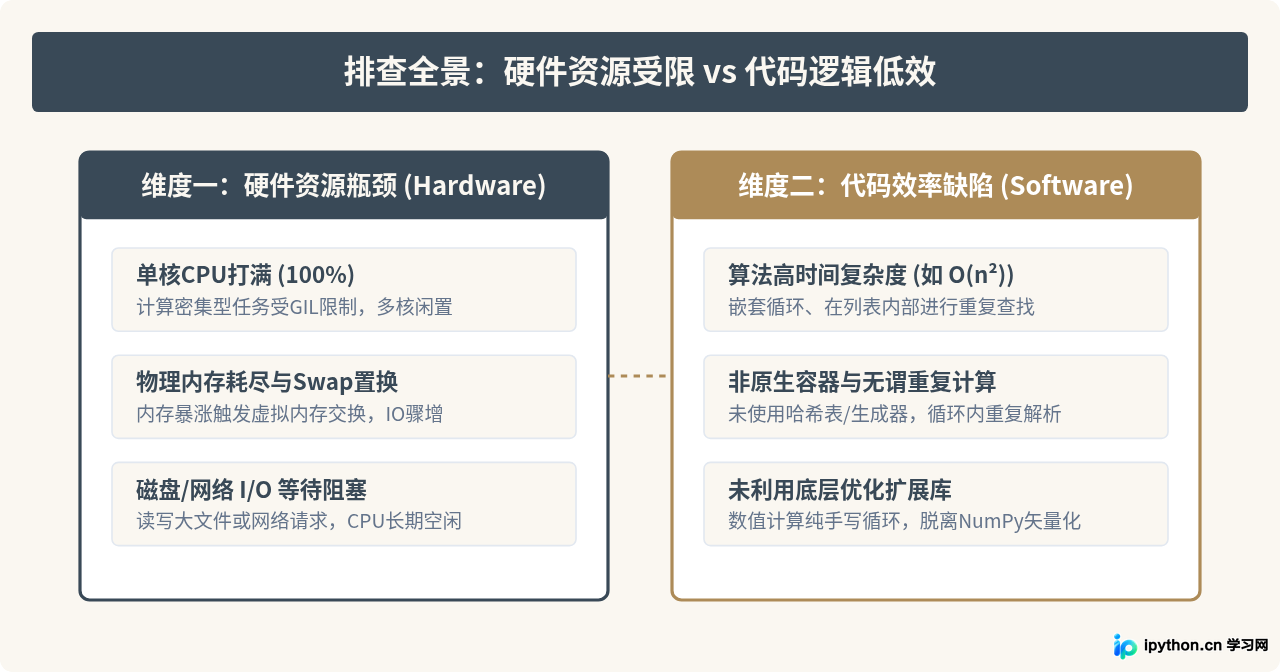
一、判断依据:电脑配置到底何时才是瓶颈?
区分“电脑配置不够”还是“代码效率太低”,必须依赖系统的量化指标而非直觉。当程序运行缓慢时,通过任务管理器或终端性能监控工具观察系统状态,可以快速得出明确结论:
- 真性硬件瓶颈:当进程的内存使用量触及物理上限,操作系统开始将数据写入磁盘置换空间(Swap),导致整体磁盘读写飙升、系统操作明显卡顿;或者当所有CPU核心均被100%打满,持续进行无法简化的重型科学计算。此时硬件上限确实构成了直接制约。
- 假性硬件瓶颈(单核满载):在多核CPU电脑上,整体CPU利用率显示仅为10%~25%,但某一个核心的使用率达到100%。这是标准的单线程计算瓶颈,即便更换为具有更多核心的服务器CPU,运行速度也几乎不会改变。
- 代码与I/O阻塞:CPU占用率极低(不到5%),内存也很充裕,但程序依然长时间无响应。这说明程序正在同步等待外部资源,例如磁盘频繁读取细碎文件、数据库查询无索引或网络HTTP请求延迟,此时更换更强悍的电脑完全无法提升速度。
注意:如果计算机硬件能够平稳运行现代操作系统及主流开发工具,那么处理百万级常规数据通常仅需数秒。当一个常规脚本耗费数十分钟甚至数小时时,95%以上的问题存在于代码算法设计或数据流组织中。
二、系统化排查步骤:定位性能短板的操作流程
要精确找到变慢的环节,应遵循“自顶向下”的排查顺序:先从操作系统层面确认资源争用,再借助代码性能分析器(Profiler)锁定耗时函数,最后分析算法复杂度与I/O调用。
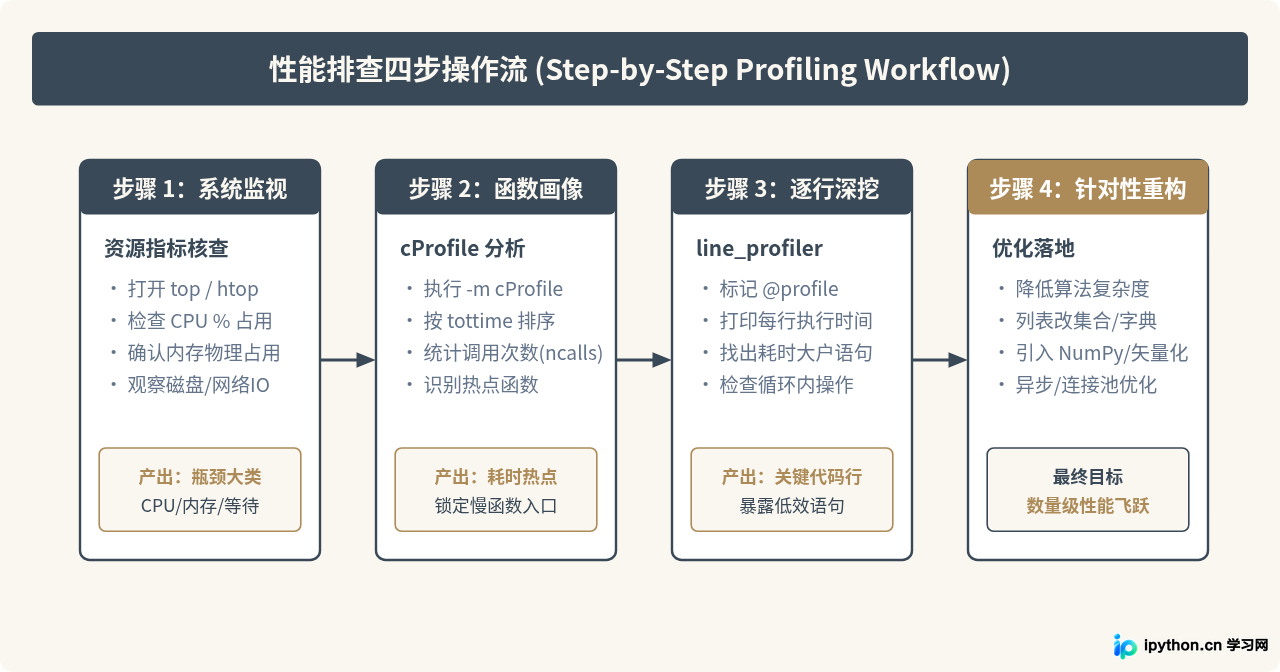
1. 使用系统内置工具监控资源
在程序运行期间,在终端执行以下命令观察实时资源:
# Linux / macOS 下查看进程与CPU核心分配
top

# 或使用更直观的交互工具(若已安装)
htop
重点查看 %CPU 和 %MEM。如果单个进程占用约为 100%(在按单核100%计算的系统中)或 1/核心数,说明程序正被限制在单核计算中。
2. 使用 cProfile 运行分析
Python 标准库自带性能分析模块 cProfile,无需额外安装即可直接诊断脚本中各个函数的耗时:
# 将 output.pstats 替换为您希望保存的文件名,script.py 替换为待测脚本
python3 -m cProfile -o profile_result.pstats script.py
通过内置的 pstats 模块快速查看耗时最长的函数:
import pstats

p = pstats.Stats('profile_result.pstats')
# 按照累计耗时排序,打印前10个最耗时操作
p.strip_dirs().sort_stats('tottime').print_stats(10)
三、核心诱因:典型低效代码模式与重构对比
通过性能分析,通常可以发现大部分运行缓慢的代码都落入了固定的几个低效陷阱。其中最为典型的是容器选用不当导致的时间复杂度失控。
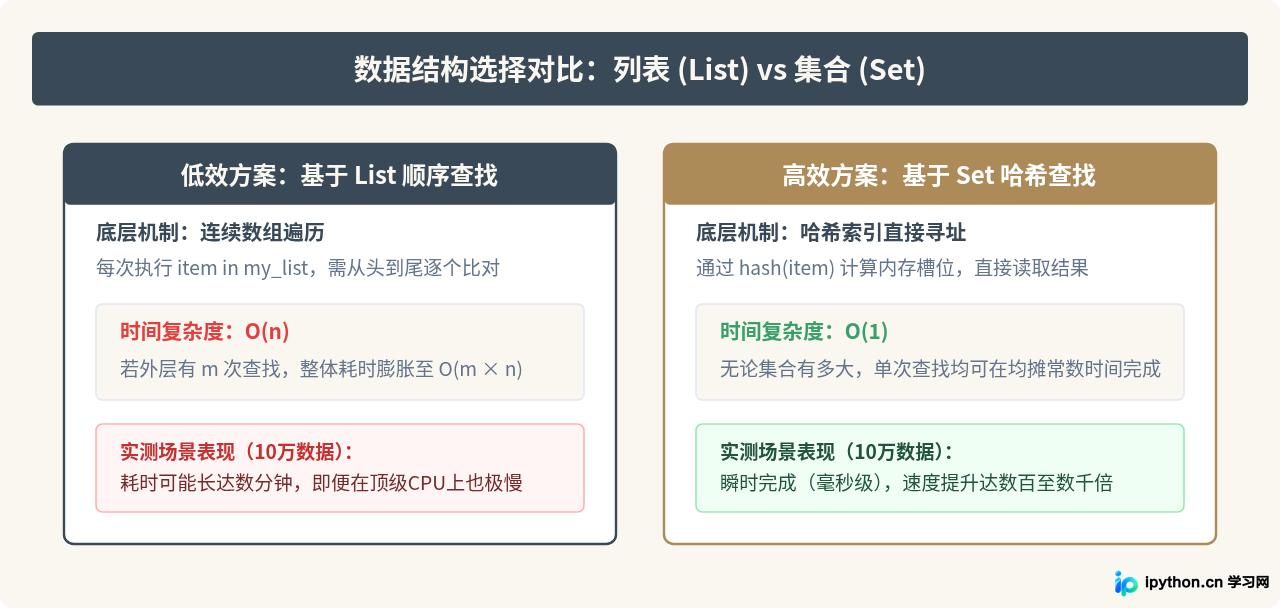
示例:成员检查从 O(n) 到 O(1) 的优化
以下为一个典型的问题重现代码。开发者需要核对一批查询项是否存在于已有的用户白名单中:
# 常见低效写法:使用列表进行包含判断
def check_users_slow(query_list, valid_users_list):
    matched = []
    for user in query_list:
        # 在列表内使用 'in' 操作是 O(N) 线性扫描
        if user in valid_users_list:
            matched.append(user)
    return matched

# 重构后高效写法:预先转换为集合
def check_users_fast(query_list, valid_users_list):
    # 转换为哈希集合,开销为单次 O(N)
    valid_users_set = set(valid_users_list)
    # 后续每次查询开销降为 O(1)
    matched = [user for user in query_list if user in valid_users_set]
    return matched
如果 valid_users_list 包含10万条数据,且 query_list 也有10万条数据,第一种写法需要进行 100,000 × 100,000 = 100亿次 比较;而在普通PC上,第二种写法通过一次哈希建表,整体执行时间直接从数十分钟缩短至0.05秒左右。这正是“电脑配置未变,运行速度暴增”的生动例证。
四、代码排查与性能调优总结指南
在确认程序变慢后,切忌盲目考虑更换高配硬件。请参考下述综合决策表,在不同场景下选择最具性价比的解决途径:
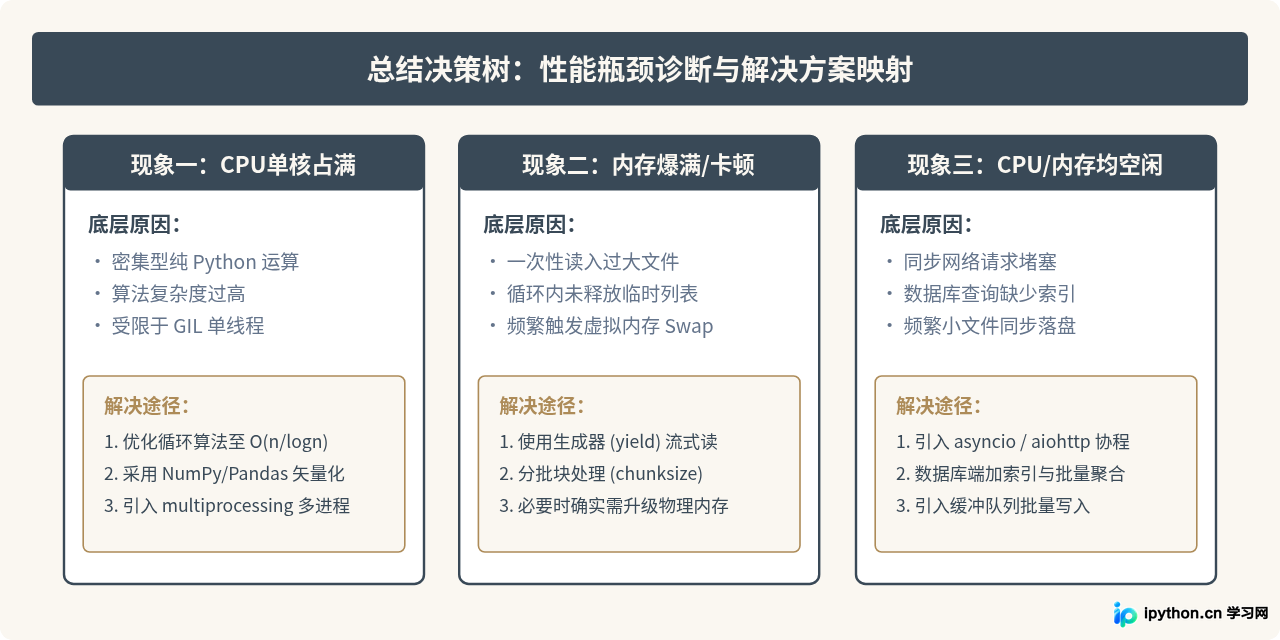
综上所述,遇到 Python 执行效率迟缓时,不要轻信“配置不足”的直觉推断。遵循“查看系统指标 → 定位热点函数 → 优化数据结构与调用方式”的排查链路,不仅能节省不必要的硬件升级成本,也是写出高质量健壮代码的必经之路。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















