


汉诺塔算法时间复杂度为什么是O(2^n)?Python实现分析

核心结论概括:汉诺塔算法的时间复杂度之所以是 O(2^n),根本原因在于其分治递归结构的“裂变效应”。为了将 n 个圆盘从源柱移动到目标柱,每一次操作都必须严格拆解为三个步骤:先将上方 n-1 个圆盘移开、将最大的底盘移到目标柱、再将 n-1 个圆盘移到目标柱上方。这导出了递推公式 T(n) = 2T(n-1) + 1。通过代数展开与等比数列求和可得出精确移动步数为 2^n - 1,在大O渐进分析中忽略低阶常数项,其时间复杂度精确界定为 O(2^n)。
一、汉诺塔问题规则与分治递归模型
汉诺塔(Tower of Hanoi)源自古印度传说,其经典数学游戏规则包含三根柱子(常记为 A 柱、B 柱、C 柱)以及 n 个大小各不相同的圆盘:
- 单次限制:每次只能移动一个位于柱子最顶端的圆盘;
- 位置限制:圆盘只能在三根柱子之间搬移,不能悬空或放置于桌面上;
- 大小约束:在任何时刻、任何柱子上,较大的圆盘都绝对不能压在较小的圆盘上方。
面对这套严格限制,如果我们尝试逐个步骤穷举,当盘数增加时极易陷入思维混乱。解决该问题的关键在于分治策略(Divide and Conquer)与递归规约。
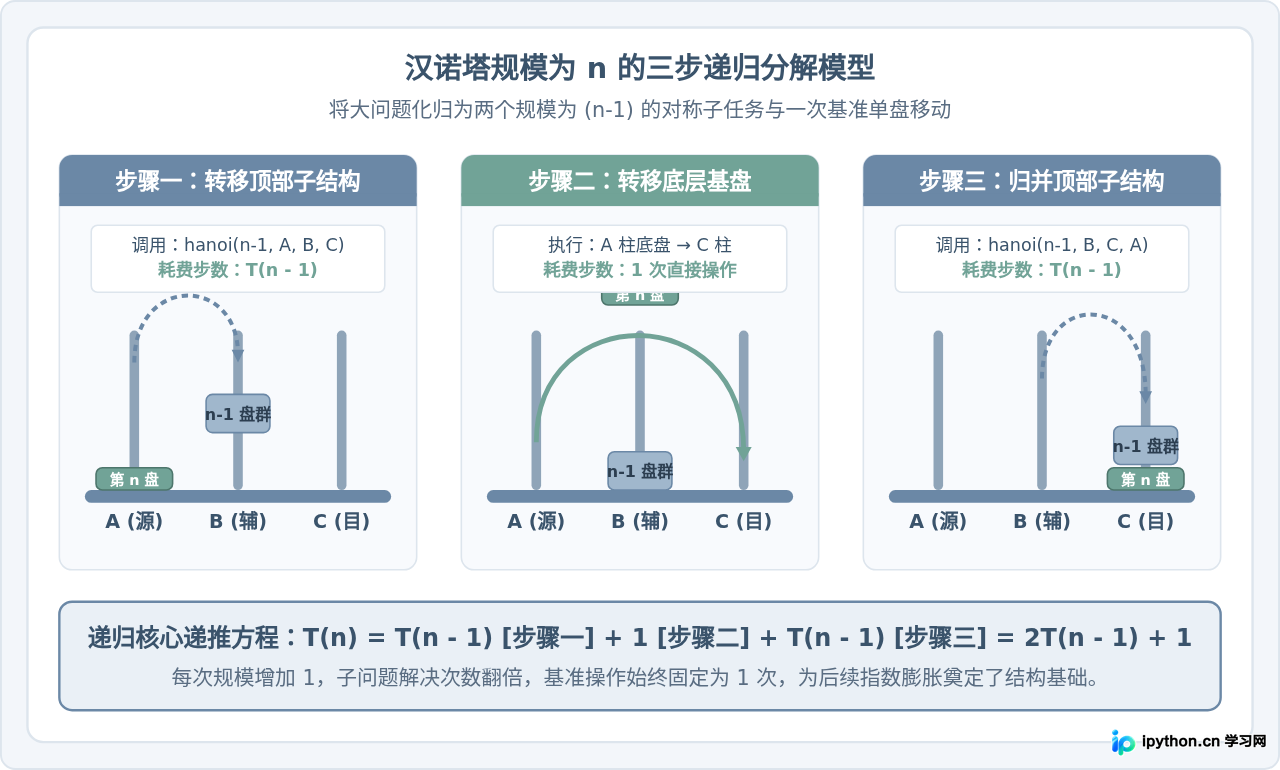
假设我们拥有移动任意数量圆盘的能力,要将 A 柱上的全部 n 个圆盘完整迁移至 C 柱,并且保持大小顺序不变,唯一可行的宏观分解步骤只有三步:
- 第一步(子问题):将 A 柱上方的
n-1个较小圆盘,借助目标柱 C,整体移动到辅助柱 B; - 第二步(基础动作):此时 A 柱只剩下第
n个(最大的)圆盘,且 C 柱为空或没有较小盘干扰,直接将该底盘从 A 柱移动到 C 柱; - 第三步(子问题):将暂存在 B 柱上的
n-1个圆盘,借助源柱 A,整体转移并叠放在 C 柱的最大底盘上方。
只要定义了最底层边界条件(当 n = 1 时,直接从源柱移到目标柱,无需辅助柱挪动子结构),上述三步就能在数学与程序层面形成完美的自闭环。
二、Python递归算法实现与执行追踪
将上述递归思想转化为 Python 代码极其精炼。在函数设计中,我们通常为递归函数传入四个核心参数:
n:当前需要移动的圆盘总数;source:源柱(当前圆盘所在的起始柱);target:目标柱(期望最终到达的柱子);auxiliary:辅助柱(临时用于摆放和过渡的柱子)。
1. 经典递归实现
以下为最标准的 Python 递归实现。代码完全依照上述三个分解步骤进行调用:
# -*- coding: utf-8 -*-
# 汉诺塔经典递归实现(Python 3)

def hanoi(n, source, target, auxiliary):
    """
    将 n 个圆盘从 source 柱借助 auxiliary 柱移动到 target 柱
    :param n: 当前需要移动的圆盘数量
    :param source: 源柱名称
    :param target: 目标柱名称
    :param auxiliary: 辅助柱名称
    """
    # 递归终止条件(基准情况 Base Case):只剩 1 个盘子时直接移动
    if n == 1:
        print(f"移动圆盘 1:从 {source} -> {target}")
        return

    # 步骤一:将前 n-1 个盘子从 source 借助 target 移到 auxiliary
    hanoi(n - 1, source, auxiliary, target)

    # 步骤二:将当前底部的第 n 个盘子直接从 source 移到 target
    print(f"移动圆盘 {n}:从 {source} -> {target}")

    # 步骤三:将 auxiliary 上的 n-1 个盘子借助 source 移到 target
    hanoi(n - 1, auxiliary, target, source)


# 测试运行:以 3 个圆盘为例,从 A 柱移动到 C 柱
if __name__ == "__main__":
    print("--- 汉诺塔 3 个圆盘移动轨迹 ---")
    hanoi(3, 'A', 'C', 'B')
执行该脚本后,终端输出的真实轨迹如下:
--- 汉诺塔 3 个圆盘移动轨迹 ---
移动圆盘 1:从 A -> C
移动圆盘 2:从 A -> B
移动圆盘 1:从 C -> B
移动圆盘 3:从 A -> C
移动圆盘 1:从 B -> A
移动圆盘 2:从 B -> C
移动圆盘 1:从 A -> C
仔细观察这 7 步输出可以发现:第 4 步移动了最大的第 3 号盘(从 A 到 C);在此之前执行了 3 步(将 1、2 号盘搬到 B);在此之后又执行了 3 步(将 1、2 号盘搬到 C)。总步数为 3 + 1 + 3 = 7 步。
2. 带计数器的步数度量实现
为了直观验证盘数与实际移动次数的关系,我们引入计数器对调用规模进行量化统计:
def hanoi_count(n, source, target, auxiliary, counter):
    if n == 1:
        counter[0] += 1
        return
    hanoi_count(n - 1, source, auxiliary, target, counter)
    counter[0] += 1
    hanoi_count(n - 1, auxiliary, target, source, counter)

for disk_num in range(1, 7):
    step_record = [0]
    hanoi_count(disk_num, 'A', 'C', 'B', step_record)
    theoretical = (2 ** disk_num) - 1
    print(f"圆盘数 n={disk_num}: 实际移动次数={step_record[0]}, 理论值(2^n - 1)={theoretical}")
运行结果完全与理论公式贴合:
圆盘数 n=1: 实际移动次数=1, 理论值(2^n - 1)=1
圆盘数 n=2: 实际移动次数=3, 理论值(2^n - 1)=3
圆盘数 n=3: 实际移动次数=7, 理论值(2^n - 1)=7
圆盘数 n=4: 实际移动次数=15, 理论值(2^n - 1)=15
圆盘数 n=5: 实际移动次数=31, 理论值(2^n - 1)=31
圆盘数 n=6: 实际移动次数=63, 理论值(2^n - 1)=63
三、为什么时间复杂度是 O(2^n)?严格数学推导
在算法分析中,时间复杂度度量的是算法运行时间随着输入规模 n 增长时的增长趋势。对于递归算法,最严谨的推导方式是建立递推关系式(Recurrence Relation)并求解其通项公式。
1. 建立递推方程
设移动 n 个圆盘所需的基本操作(移动单个盘子)次数为 T(n):
- 边界条件:当
n = 1时,只需要直接移动一次底盘,即T(1) = 1; - 递推分支:当
n > 1时,必须完成两次n-1规模的递归调用以及一次常数级别的基础移动,即T(n) = 2T(n-1) + 1。
2. 迭代展开法求解通项公式
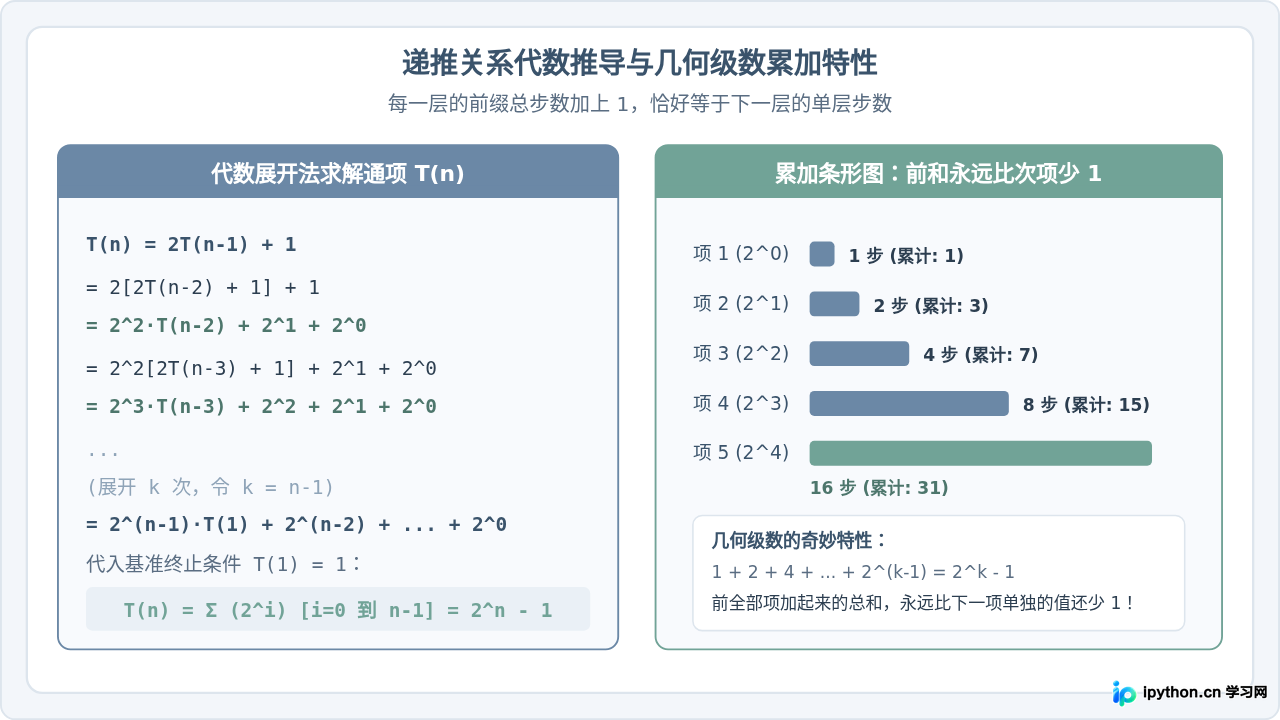
我们可以使用逐层代入展开(Iteration / Expansion Method)的方式展开方程:
将 T(n-1) = 2T(n-2) + 1 代入上式:
继续将 T(n-2) = 2T(n-3) + 1 代入:
依此类推,当下潜展开到第 k 步时,递推式具备如下通用形式:
当展开达到最底层的基准条件时,令 n - k = 1,即 k = n - 1。此时代入 T(1) = 1 = 2^0:
T(n) = 2^{n-1} + 2^{n-2} + ... + 2^1 + 2^0
3. 等比数列求和与大O渐进界定
上述展开式是一个标准的首项为 1(即 2^0)、公比为 2、总项数为 n 的等比数列。利用等比数列求和公式:
因此,汉诺塔算法精确的移动步数通项公式为:
在算法复杂度的大O渐进表示法(Big-O Notation)中,我们关注的是当输入规模 n 趋近于无穷大(n → ∞)时的最高阶主导项。由于:
- 常数项
-1相较于指数项2^n可以完全忽略; - 最高阶项的系数为 1;
- 根据定义,存在正实数
c = 1和常数n_0 = 1,使得对于所有n >= n_0,恒有|T(n)| <= c · 2^n。
因此,汉诺塔算法的渐进时间复杂度严格确立为 O(2^n)。
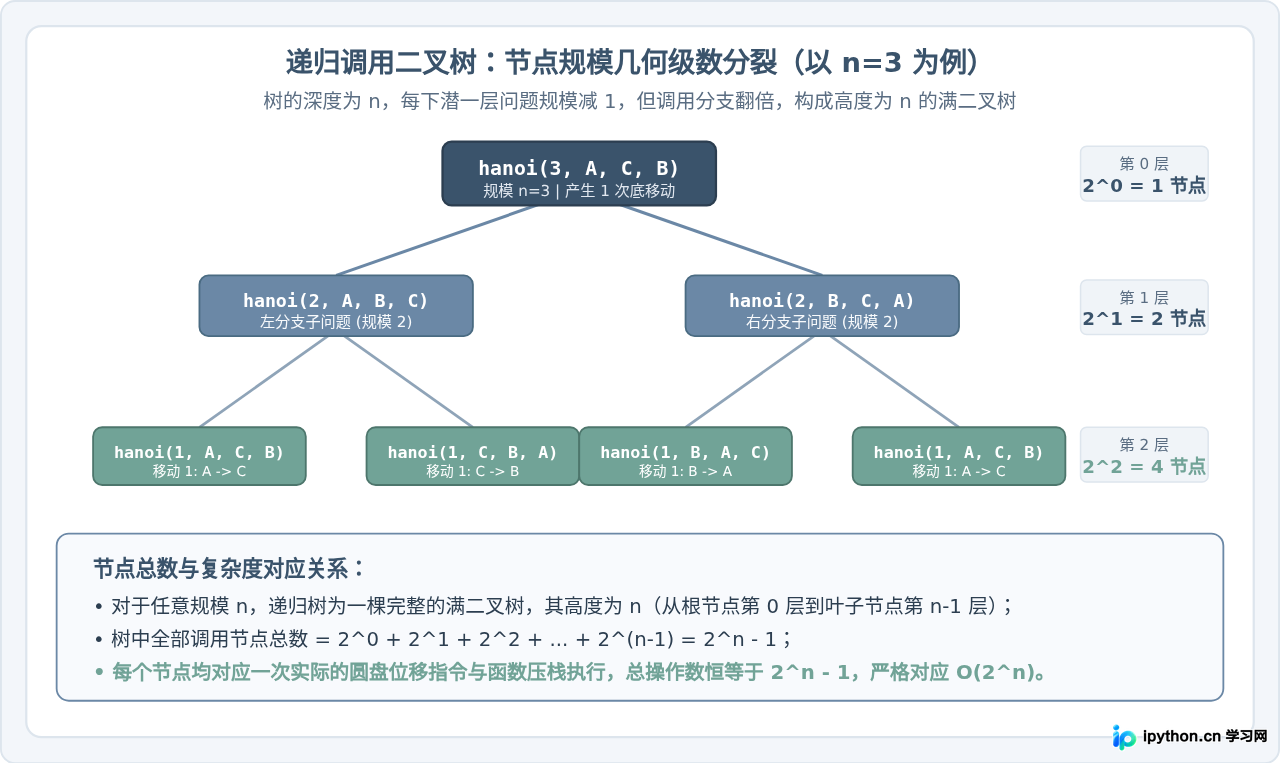
四、递推关系的代数几何直观:为什么它不是 O(n^2)?
初学算法的读者常常容易混淆多项式时间(如 O(n^2))与指数时间(O(2^n))。两者的本质区别可以通过代数几何结构清晰展现:
- 多项式时间 O(n^2):例如双重循环,当规模
n翻倍为2n时,计算量变为(2n)^2 = 4n^2,增长了 4 倍; - 指数时间 O(2^n):在汉诺塔中,当输入规模
n仅仅增加 1(n → n+1),总工作量就直接从2^n - 1跃升为2^(n+1) - 1 ≈ 2 · 2^n,工作量直接翻倍!
这种“规模每走一步,工作量直接翻一番”的几何级数累加,正是图 3 中所示的错位倍增结构。
五、空间复杂度为什么只有 O(n)?递归调用栈机制剖析
学习汉诺塔算法时,许多初学者会产生一个常见的直觉误区:“既然时间复杂度是指数级 O(2^n),产生了 2^n - 1 个调用节点,那么占用内存的空间复杂度是不是也是 O(2^n)?”
答案是否定的。汉诺塔算法的辅助空间复杂度仅为 O(n)!
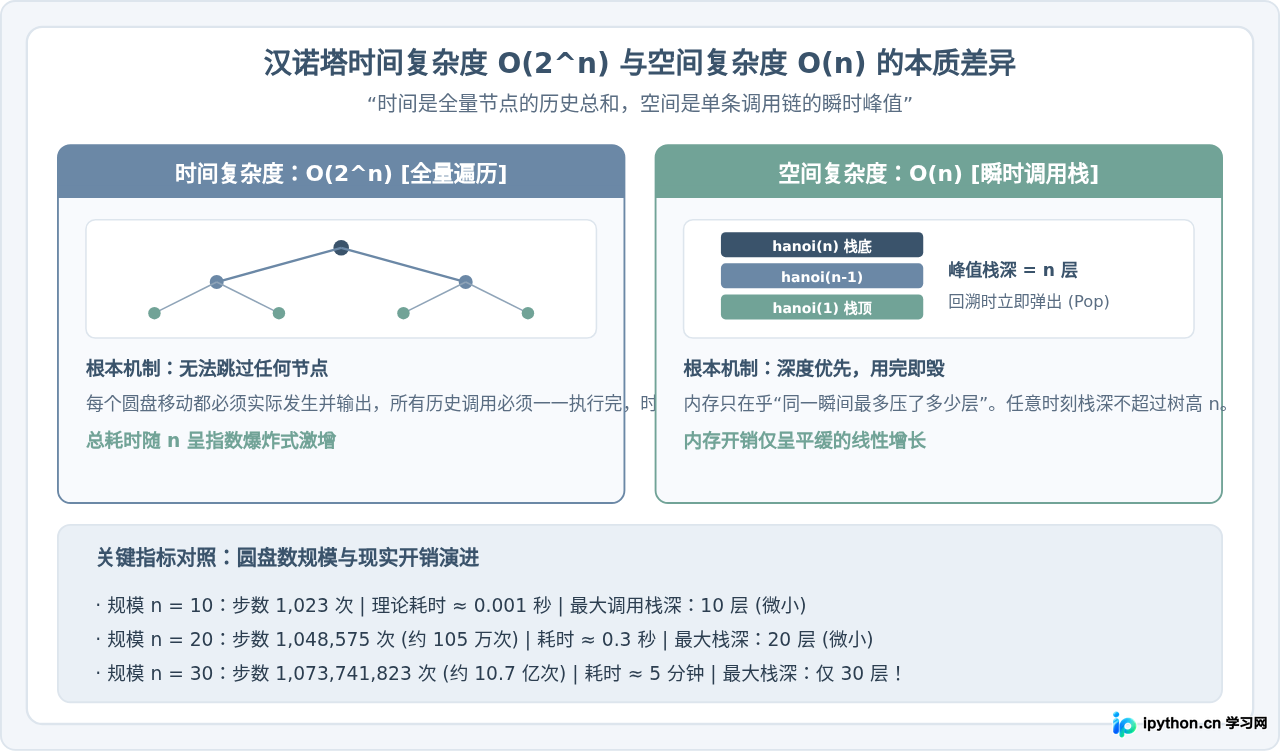
时间与空间存在本质维度的不同:
- 时间是“全量历史累积量”:CPU 必须按序真实访问并执行递归树上的每一个节点,已执行完的节点耗费的时间无法被“撤销”,因此时间开销等于整棵树的所有节点总和(
2^n - 1),为O(2^n); - 空间是“瞬时最大占用量”:递归调用的空间消耗由操作系统为程序维护的函数调用栈(Call Stack)的最大深度决定。Python 在执行递归时,采用的是深度优先搜索(DFS)策略。
当程序执行完某一个分支(例如左子树)的递归调用后,该函数帧就会从栈顶弹出(Pop)并立即销毁,释放其占用的内存;随后才能压栈进入右子树。换言之,在任意时刻,调用栈中同时存在的函数栈帧数量,绝不可能超过从根节点到叶子节点的最长路径长度。
因为对于规模为 n 的汉诺塔问题,树的最大深度正好是 n,因此调用栈的峰值深度就是 n。除了栈帧保存的局部变量(几个指针和整数参数)外,程序没有分配任何随着 n 额外膨胀的堆内存数据结构,所以其辅助空间复杂度仅为 O(n)。
六、指数爆炸在实际运行中的边界与不可优化性
指数级增长 O(2^n) 是计算机科学中“不可处理问题(Intractable Problems)”的典型代表。很多人初学时会问:“既然 O(2^n) 这么慢,我们能否通过动态规划、记忆化搜索或者剪枝,将其优化到多项式时间(比如 O(n^2))?”
答案是:在汉诺塔的规则要求下,绝对不可能优化到多项式时间!
1. 为什么汉诺塔不能被“算法优化”?
在算法优化理论中,我们之所以能用动态规划等技巧加速,前提通常是“存在大量重复的重叠子问题”,或者是“我们只需要求出一个最终结果(例如最优解、最短距离、方案总数)而不需要输出具体的全部路径”。
但汉诺塔问题的输出目标是:完整打印出移动每一个盘子的动作指令。既然解 n 个盘子的最短必须移动次数在数学上已经证明了下界就是 2^n - 1 次,那么无论你设计多么巧妙的算法,只要你的程序要输出完整的移动序列,其输出长度本身就是 2^n - 1。换言之,该问题的信息论下界就是 Ω(2^n),任何能够完成任务的算法,其时间复杂度必定不低于 O(2^n)。
2. 现实物理极限:64 个圆盘需要算多久?
汉诺塔传说中提到:印度梵天神庙中的祭司们正在搬动 64 个纯金圆盘,当所有圆盘从 A 柱全部移动到 C 柱之日,世界便会毁灭。如果我们在现代超级计算机上模拟这一过程,需要多长时间?
| 圆盘数 (n) | 精确移动次数 (2^n - 1) | 假设每秒移动 1 亿次所需时间 | 工程与物理可行性评估 |
|---|---|---|---|
| 10 | 1,023 | 约 0.00001 秒 | 极快,瞬间完成 |
| 20 | 1,048,575 | 约 0.01 秒 | 眨眼即达 |
| 30 | 1,073,741,823 | 约 10.74 秒 | 可轻松执行完毕 |
| 40 | 1,099,511,627,775 | 约 3.05 小时 | 需要后台持续计算 |
| 50 | 1,125,899,906,842,623 | 约 130.3 天 | 单机长时间计算 |
| 64 | 18,446,744,073,709,551,615 (约 1.84×10^19) | 约 5,849 亿年 | 远超宇宙当前年龄(约 138 亿年) |
从上表可以直观看到,即使拥有每秒能处理一亿次移动的超高频执行器,计算 64 个盘子的移动序列也需要 5,849 亿年。这向中文读者深刻阐释了为什么在现实系统设计中,一旦算法的时间复杂度达到 O(2^n),输入规模 n 稍大便会在物理时间维度上彻底失效。
七、全文核心要点总结
- 核心机制:汉诺塔的核心是分治分解:把
n盘迁移规约为两个n-1盘子任务加一次单底盘操作,推导出T(n) = 2T(n-1) + 1。 - 通项公式:通过逐层展开法代入等比数列求和,得到精确移动步数
T(n) = 2^n - 1。 - 时间复杂度 O(2^n):由于大O表示法舍去常数项
-1,递归执行时间严格收敛于O(2^n),每一次盘数加 1 意味着工作量翻倍。 - 空间复杂度 O(n):因为递归采用深度优先搜索,函数栈帧即用即毁,内存占用仅由树的最大高度
n决定,空间保持在平缓的O(n)线性增长。 - 不可跨越的理论下界:由于必须输出每一步位移,汉诺塔的解空间大小天然为
2^n - 1,无法通过常规动态规划将其压缩到多项式级别。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















