


为什么不建议用三引号做Python块注释?多行字符串的内存占用问题

许多 Python 开发者习惯使用成对的三引号(''' 或 """)将大段代码或多行文字包裹起来,当作类似 C 或 Java 中的块注释使用。这种写法看似能够快速临时屏蔽一段代码,但在 Python 的官方设计中,并没有多行块注释这一语法概念。三引号本质上是多行字符串字面量(String Literal)。在代码块内部使用未绑定的三引号多行字符串,不仅无法被解释器当成真正的注释丢弃,反而会被编译进底层代码对象(PyCodeObject)的常量池元组(co_consts)中持续驻留内存,同时还会引入意外的缩进错误风险与静态分析工具警告。本文将从编译解析管线、字节码常量池机制、实测验证方法以及工程规范四个方面,深入拆解为什么应当彻底放弃三引号块注释。
一、语法与词法真相:注释与字符串字面量的本质分界
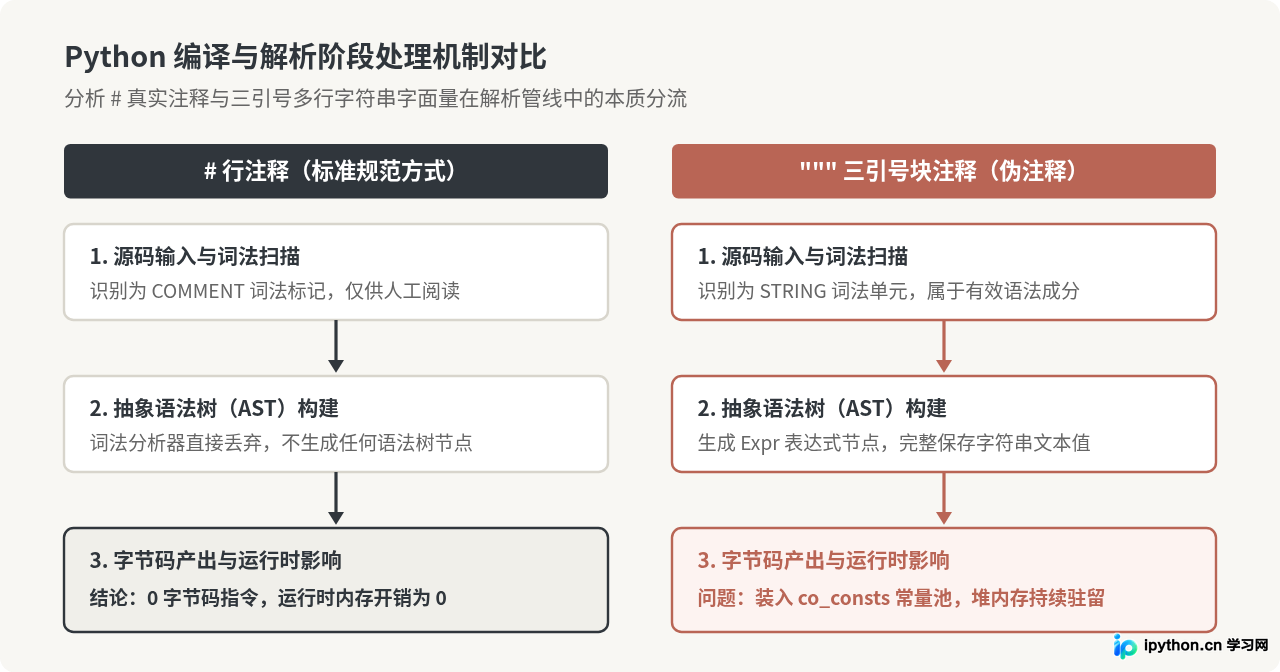
在 Python 语言规范中,真正的注释只有一种形式,那就是以井号 # 开头的单行注释。根据 Python 官方规范 PEP 8 的定义,任何在代码逻辑内部需要进行解释、说明或临时屏蔽的内容,都应当使用 # 进行标识。
当 Python 解释器读取源码并执行词法分析(Tokenization)时,词法分析器遇到 # 后,会将其识别为 COMMENT 标记。在构建抽象语法树(AST)的过程中,这些注释标记会被直接丢弃,根本不会生成任何语法树节点,更不会进入后续的字节码编译阶段。因此,真正的 # 注释在程序编译后完全消失,对运行时的内存和执行性能产生的影响精确为零。
而三引号定义的文本在语法层面上属于 STRING 标记。解释器必须将其作为完整的表达式语句(Expression Statement)进行处理。除非该字符串恰好位于模块、类或函数定义的第一行并被识别为文档字符串(Docstring),否则在函数内部或逻辑分支中的独立三引号字符串,就是一个合法但没有副作用的字面量表达式。
二、字节码与内存机制:三引号字符串如何常驻常量池
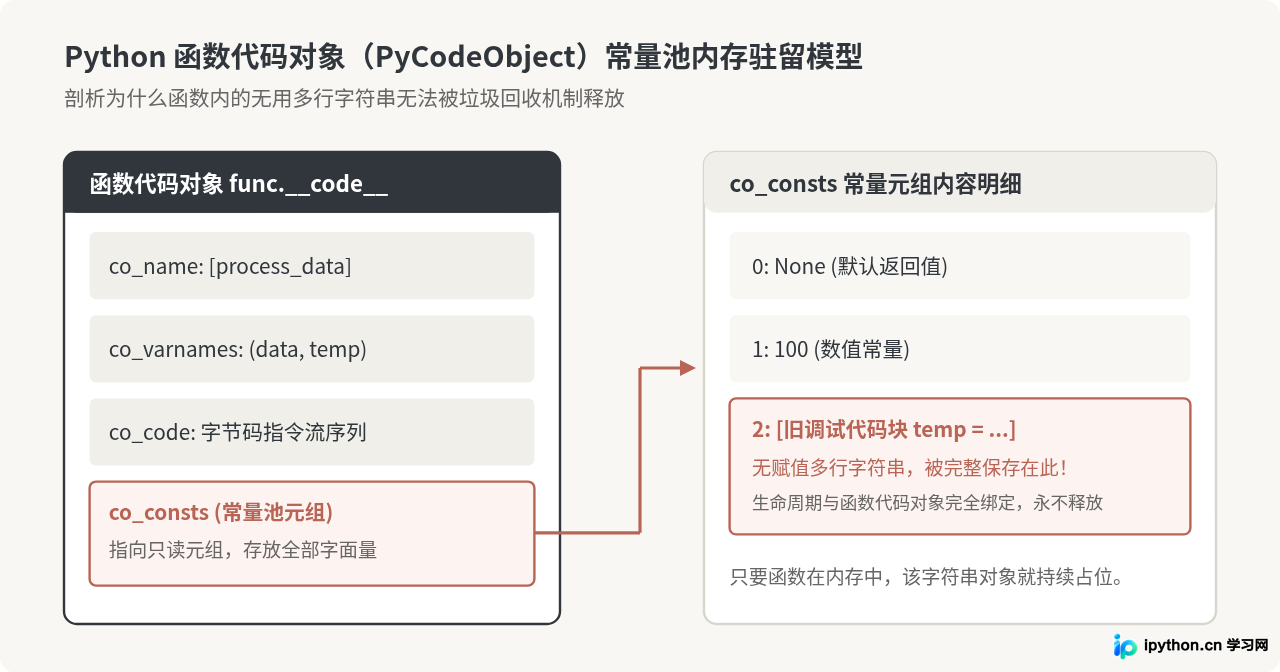
当 Python 源代码被编译为字节码时,每个模块、类或函数都会对应生成一个代码对象(Code Object,在 C 源码中对应 PyCodeObject)。代码对象中封装了该作用域执行所需的所有元数据,包括指令序列 co_code、局部变量名 co_varnames 以及常量元组 co_consts。
很多开发者认为:“既然我没有把三引号字符串赋值给任何变量,Python 的编译器难道不会直接把它优化掉吗?”
在 CPython 编译器的优化阶段(如 AST 优化器和窥孔优化),对于无副作用的独立字面量语句,编译器确实会省略生成运行时的加载指令(例如 LOAD_CONST 后跟 POP_TOP)。但是,这仅仅意味着在函数被调用执行时不会重复将其压栈和弹栈,并不意味着字符串对象被彻底销毁。所有在编译期解析出的字面量常量,都会被无条件分配一个不可变的 Python 字符串对象,并作为元素加入到该代码对象的 co_consts 元组中。
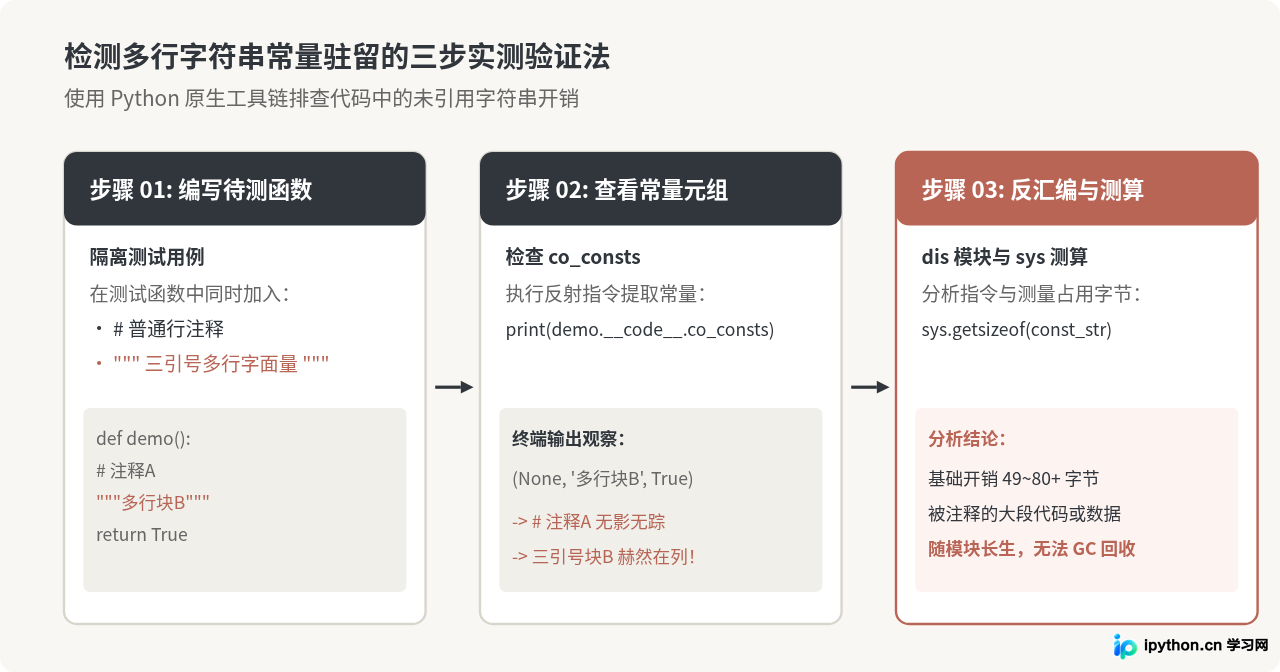
我们可以通过标准库内置模块直接验证这一现象。观察下方代码:
import dis

def calculate():
    # 这是普通单行注释,不会出现在字节码中
    """
    【废弃逻辑】
    old_value = 100
    temp_result = old_value * 2
    """
    base = 10
    return base * 2

print("常量池元组 co_consts:")
print(calculate.__code__.co_consts)
运行上述脚本后,终端输出的常量池元组内容如下:
常量池元组 co_consts:
(None, '\n    【废弃逻辑】\n    old_value = 100\n    temp_result = old_value * 2\n    ', 10, 2)
输出结果清晰表明:虽然该三引号字符串未参与任何计算,也没有绑定变量,但它作为独立的字符串对象被完整保留在 co_consts 的下标 1 处。由于函数对象在其所在的模块或全局作用域存活期间始终持有对其代码对象的引用,代码对象又持有对 co_consts 元组的强引用,这意味着该字符串对象的引用计数永远大于零,Python 的引用计数垃圾回收机制根本无法将其释放。
三、内存占用与累积效应实测
Python 中的字符串并不是简易的 C 语言字符数组,而是高度结构化的堆内存对象。在 CPython 中,根据字符编码的不同,字符串对象分别由 PyASCIIObject 或 PyCompactUnicodeObject 等底层 C 结构体支撑。
一个标准的 ASCII 字符串对象基础头部开销通常在 49 到 80 字节左右,若包含中文字符,每个字符还需要占用 2 到 4 字节的宽字符存储空间。通过 sys.getsizeof() 可以精确测量前文废弃代码块的真实内存占用:
import sys

unused_str = calculate.__code__.co_consts[1]
print(f"字符串长度: {len(unused_str)} 字符")
print(f"占用堆内存大小: {sys.getsizeof(unused_str)} 字节")
对于单次仅包含几十个字符的小段文字,百余字节的开销或许显得微不足道。然而在真实的工程项目中,许多人习惯用三引号一次性注释掉数百行包含配置数据、测试用例或历史实现的旧代码。在常驻后台的微服务、数据处理管道或大型 Web 应用中,成百上千个模块随进程启动常驻内存,这些被错误充当注释的多行字符串将伴随服务整个生命周期,造成不可逆的内存膨胀。
四、潜在副作用:缩进陷阱、转义错误与工具链干扰
除了隐性的常量池内存开销外,使用三引号做块注释在日常编码与工程协同中还会引发以下几个显著的技术陷阱:
1. 严格的缩进语法约束
Python 对缩进要求极为严苛。真正的 # 注释可以随意缩进或顶格书写,而三引号字符串作为语句的一部分,其起始三引号和闭合三引号必须严格匹配所在代码块的缩进层级。如果不小心将闭合三引号缩进错误,或者在内部混杂了不合理的制表符与空格,极易触发 IndentationError 或 TabError。
def check_status(score):
    if score >= 60:
        """
顶格书写或缩进不当的三引号字符串,会破坏代码视觉层次并增加排错成本
        """
        print("及格")
    else:
        print("不及格")
2. 转义字符与语法歧义
三引号虽然允许跨行,但它仍然是字符串。如果被注释的代码中包含未配对的反斜杠 \、转义序列或同类型的三引号边界,解释器在词法解析时便会发生断裂,导致令人费解的 SyntaxError 或在 Python 3.12+ 中抛出弃用告警(SyntaxWarning: invalid escape sequence)。而使用 # 注释则不受任何字符转义规则限制。
3. 静态分析工具告警与代码异味
主流的代码质量检查工具(如 Pylint、Flake8、Ruff)对这种写法有明确的规则限制。例如 Pylint 会直接报出:
W0105: String statement has no effect (pointless-string-statement)
这意味着在持续集成(CI/CD)流程中,此类代码很可能直接导致静态检查门禁失败,被团队规范视为不良代码异味(Code Smell)。
4. 意外污染 __doc__ 文档元数据
若将三引号块注释放置在模块顶部、类声明正下方或函数首行,它将直接被 Python 解释器识别并赋值给 __doc__ 属性。这会导致原本的接口文档被无用注释直接覆盖,进而使 Sphinx、pydoc 等自动化文档生成工具抓取到错误的内容。
五、正确的工程实践与注释规范
为了在保障代码可维护性的同时避免内存常驻与语法隐患,Python 工程开发中应当遵循以下三项规范准则:
- 所有代码注释统一使用
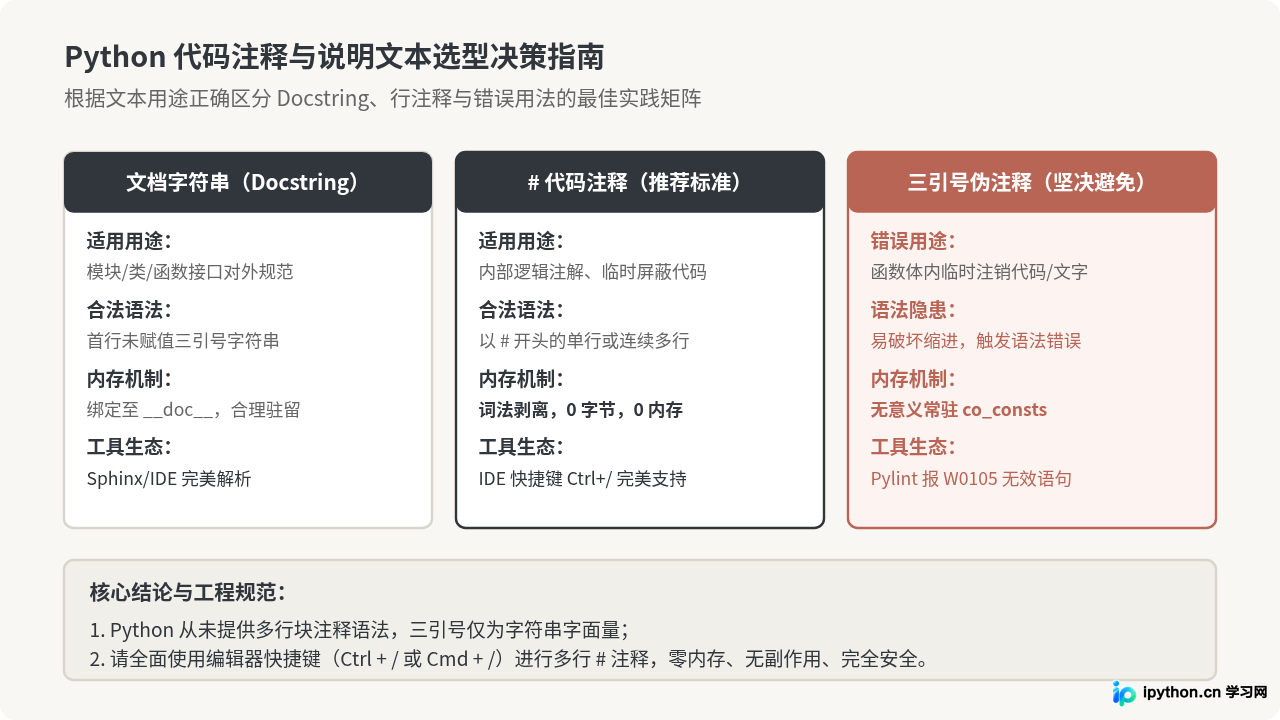
#: 无论是单行说明、算法步骤分解,还是需要临时屏蔽的多行代码段,一律使用#。每一行单独添加一个#和一个空格。 - 善用现代化编辑器的批量注释快捷键: 所有主流编辑器与集成开发环境(如 VS Code、PyCharm、Cursor、Sublime Text)都内置了极其便捷的块注释快捷键。在 Windows/Linux 下使用
Ctrl + /,在 macOS 下使用Cmd + /,选中多行即可瞬间完成注释与反注释,无需手动书写三引号。 - 明确划分 Docstring 与普通注释的界限: 三引号字符串只应出现在模块、类、方法的头部,作为正式对外的文档规范(符合 PEP 257 规范)。其余任何内部逻辑解释,均交由
#完成。
| 对比维度 | 三引号块注释(不建议) | # 井号注释(PEP 8 推荐标准) |
|---|---|---|
| 语言语法地位 | 未绑定的字符串表达式字面量 | 正规注释(Comment Token) |
| 词法分析行为 | 生成 AST 节点,参与语法验证 | 直接丢弃,不生成语法节点 |
| 常量池驻留 | 装入 co_consts,持续占用内存 |
完全不进入常量池,0 字节占用 |
| 缩进与转义 | 受缩进与字符转义约束,易报错 | 完全自由,无转义限制 |
| Linter 静态检查 | 触发 W0105 无效语句警告 | 完全合规,无任何警告 |
六、总结
在 Python 中,语法特性的简单并不等同于可以随意混用。三引号多行字符串绝非多行块注释的“官方替代品”。理解其背后的底层原理——词法解析保留为字符串 Token、AST 生成无副作用表达式、底层常量池 co_consts 持续引用常驻内存,有助于我们更深入地掌握 Python 虚拟机的运行模型。
在团队协作与日常开发中,彻底抛弃三引号做块注释的习惯,严格采用 # 进行单行与多行注释,不仅能消除不必要的运行时内存占用,还能彻底避免缩进异常与静态代码检查告警,保持代码库的清爽与严谨。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















