


Python中01矩阵的逻辑运算与布尔索引技巧

在图像二值化分割、网络拓扑邻接分析、物理网格模拟以及特征工程筛选中,由数值 0 与 1 构成的二维矩阵是极为常见的基础数据形式。许多初学者在处理 01 矩阵时,往往习惯直接使用 Python 原生逻辑关键字(如 and、or、not)或编写多重嵌套循环,结果不仅运行极其缓慢,甚至会直接遭遇运行时异常 ValueError: The truth value of an array with more than one element is ambiguous(多元素数组的真值含糊不清)。
解决这一问题的核心在于理清 01 整数矩阵与布尔掩码(Boolean Mask)在内存模型上的区别,掌握向量化按位逻辑运算符的优先级与求值规则,并熟练运用多维布尔索引进行高效的数据抽取与原位修改。本文将从底层机制出发,逐层拆解 01 矩阵的运算与索引技巧。
一、01数值矩阵与布尔矩阵的底层差异及转换
在 Python 的科学计算生态(以 NumPy 为核心)中,包含数值 0 和 1 的矩阵通常存在两种完全不同的存储形式:整数矩阵(通常为 64 位整数 int64 或 8 位无符号整数 uint8)与布尔矩阵(类型为 bool_)。
整数矩阵中的 0 与 1 是纯粹的代数数值,每个元素默认占用 8 个字节(int64)或 1 个字节(uint8),它们主要参与加、减、乘、矩阵乘法等算术运算。而布尔矩阵中的每个单元仅存储逻辑真值(True)或假值(False),在底层每个元素固定占用 1 字节(0 表示 False,非零值在存储或转换时均对应 True)。布尔矩阵是充当“空间过滤器(Mask,掩码)”的前提。
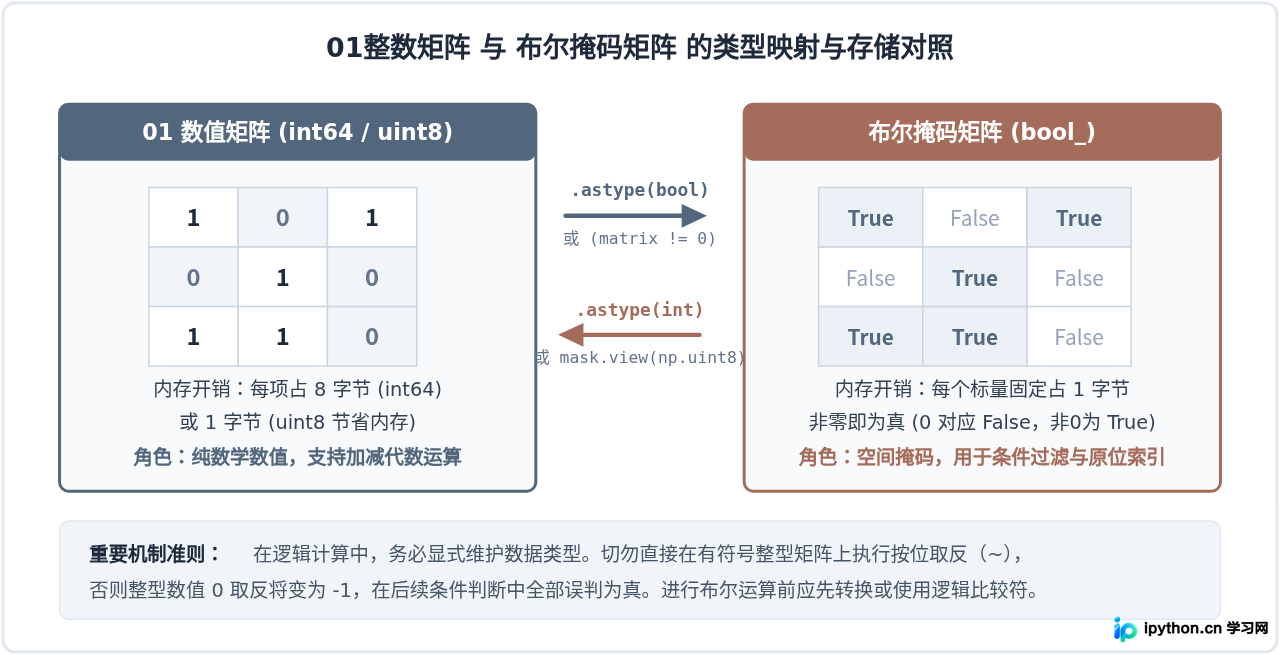
在实际代码中,两种数据类型的显式相互转换非常直接:
import numpy as np

# 创建一个 3x3 的 01 整数矩阵
int_mat = np.array([
    [1, 0, 1],
    [0, 1, 0],
    [1, 1, 0]
], dtype=int)

# 1. 01 整数矩阵转布尔矩阵(两种常见方式)
bool_mask_1 = int_mat.astype(bool)      # 显式类型转换方法(推荐)
bool_mask_2 = (int_mat != 0)            # 逻辑比较产生布尔数组(语意清晰)

# 2. 布尔矩阵转回 01 整数矩阵
recovered_int = bool_mask_1.astype(int) # 转为标准整型(0与1)
recovered_u8  = bool_mask_1.astype(np.uint8) # 转为紧凑的单字节无符号整型
二、向量化逻辑运算与运算符优先级陷阱
在 Python 处理标量布尔值时,我们常用 and、or、not。但在处理多维数组与矩阵时,这些原生关键字完全无法对矩阵元素逐一求值。因为 Python 原生逻辑词要求对整个对象评估一个单一的真值,而包含多个元素的矩阵既非绝对空、也非单一标量,因而必然触发真值歧义异常。
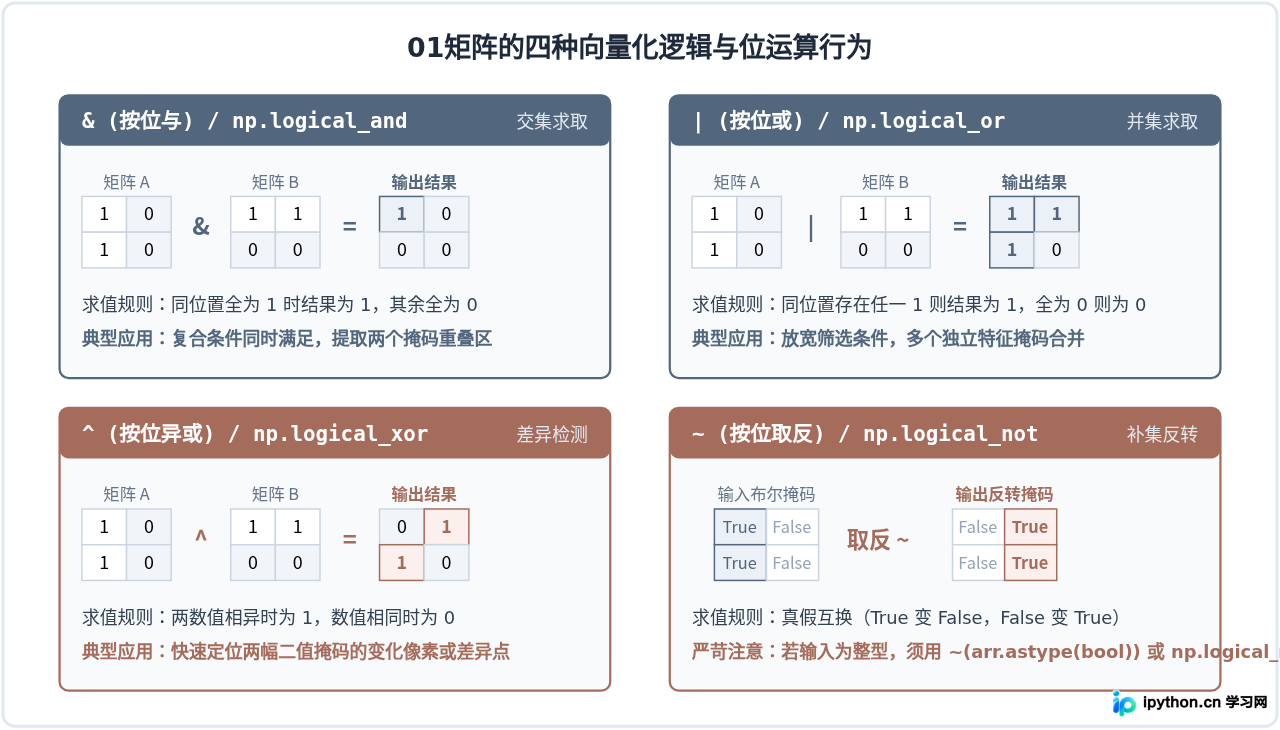
对 01 矩阵或布尔矩阵进行逐元素(Element-wise)逻辑运算,必须使用重载后的位逻辑运算符或 NumPy 逻辑函数:
- 逻辑与(AND):使用
&或np.logical_and(a, b) - 逻辑或(OR):使用
|或np.logical_or(a, b) - 逻辑异或(XOR):使用
^或np.logical_xor(a, b) - 逻辑非(NOT):使用
~(仅限布尔类型)或np.logical_not(a)
在 Python 语法解析规则中,位运算符(
&、|、^)的优先级高于比较运算符(==、!=、>、<)。例如,表达式
A == 1 & B == 0 会被 Python 解释器优先解析为:A == (1 & B) == 0(发生链式比较,完全违背原意并产生不可预期的逻辑漏洞)!规范写法:在组合比较条件时,每一个子条件必须用圆括号包裹:
(A == 1) & (B == 0)。
import numpy as np

A = np.array([[1, 0], [1, 0]], dtype=bool)
B = np.array([[1, 1], [0, 0]], dtype=bool)

# 1. 逻辑与:提取两者同时为 True 的区域
res_and = A & B
# 输出结果:[[True, False], [False, False]]

# 2. 逻辑或:提取任一为 True 的区域
res_or = A | B
# 输出结果:[[True, True], [True, False]]

# 3. 逻辑异或:提取状态不一致的区域(变化检测)
res_xor = A ^ B
# 输出结果:[[False, True], [True, False]]

# 4. 复合条件比较必须加括号
data = np.array([[10, 20], [30, 40]])
# 筛选值大于 15 且 小于 35 的布尔掩码
mask = (data > 15) & (data < 35)
# 输出结果:[[False, True], [True, False]]
三、布尔索引的提取机制与维度折叠现象
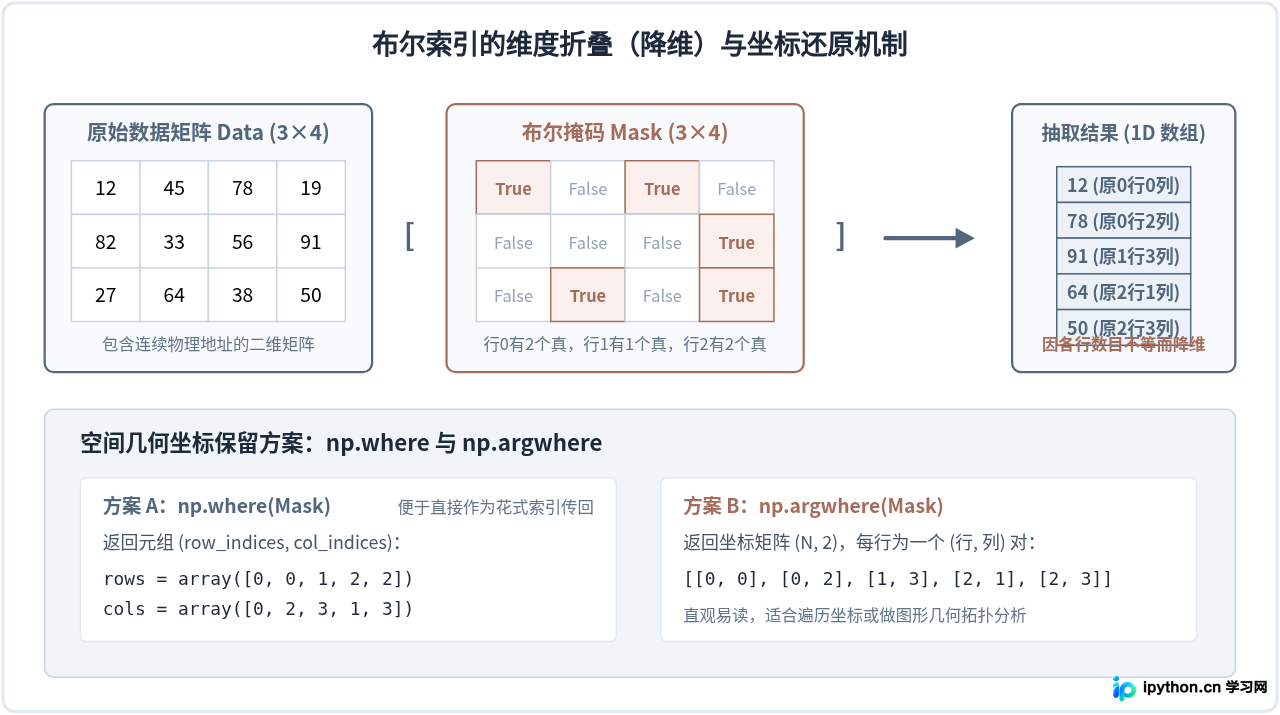
当生成一个与原数据形状一致的布尔掩码后,通过 data[mask] 语法可以瞬间完成对目标元素的提取。然而,很多初次使用该功能的开发者会产生疑惑:为什么对一个二维矩阵(甚至三维矩阵)应用布尔索引后,得到的结果却是一个一维数组(1D Array)?
这是因为在大多数实际场景中,矩阵每一行或每一列满足条件的元素数量是不均等的。如果保留原有二维矩阵的行结构,各行提取出的元素个数不同,就无法在内存中拼成一个形状规整的矩形张量。为了保证数据在连续内存缓冲中的严谨性与向量化性能,NumPy 会将所有满足条件的元素按行优先(C 语言风格)顺序展平成一个一维数组。
保留网格几何位置的实践方案
如果业务场景需要保留二维网格中各元素的空间拓扑结构(如连通域标注、图像边缘定位),绝不能直接单纯提取 1D 数组,推荐以下两种模式:
import numpy as np

data = np.array([
    [12, 45, 78, 19],
    [82, 33, 56, 91],
    [27, 64, 38, 50]
])

mask = (data > 40)

# 方式一:提取匹配元素的具体坐标
row_idx, col_idx = np.where(mask)
# row_idx: array([0, 0, 1, 1, 2, 2])
# col_idx: array([1, 2, 0, 3, 1, 3])

# 方式二:生成紧凑的二维坐标点对
coords = np.argwhere(mask)
# 每一个元素对应 [行号, 列号]
# 示例输出:[[0, 1], [0, 2], [1, 0], [1, 3], [2, 1], [2, 3]]
四、原位赋值与条件替换避坑技巧
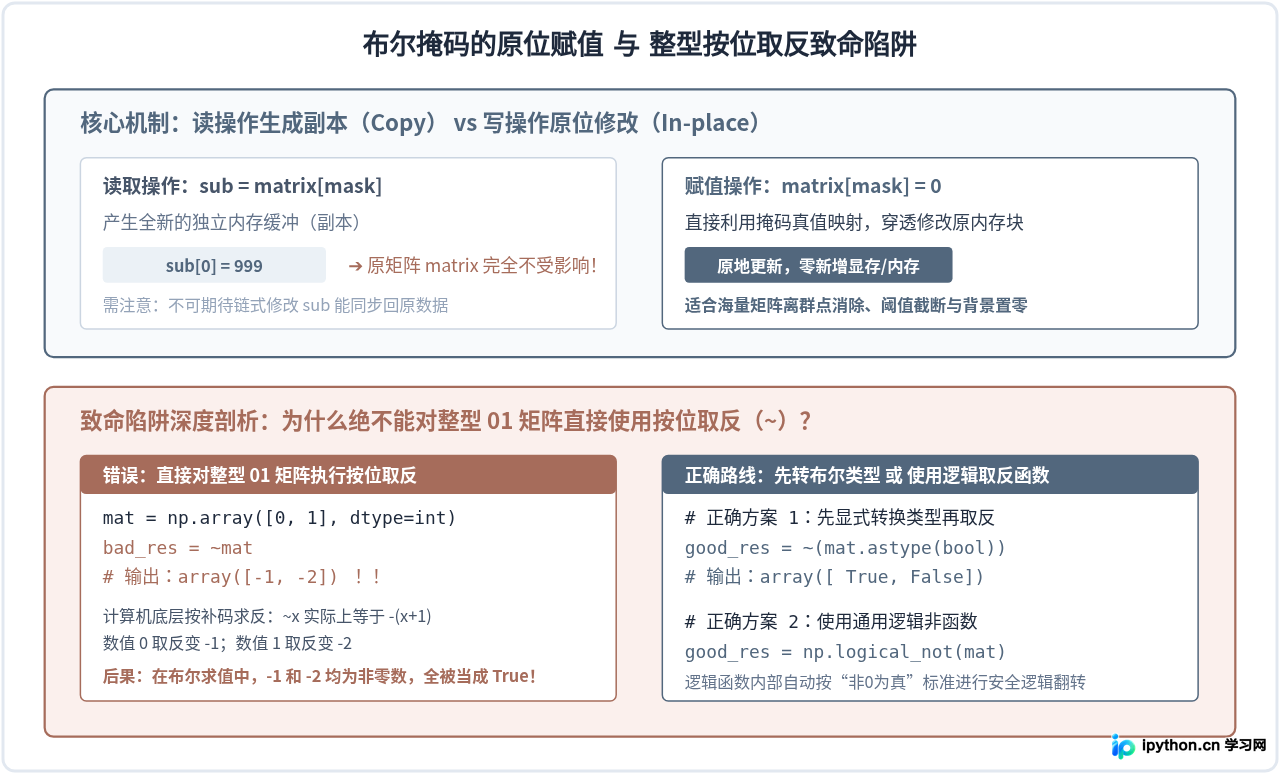
布尔索引不仅能用于“读出”数据,更是极其高效的“写入与清洗”利器。但在内存机制上,读与写有着根本性的分野:布尔取值会返回原数组的一份副本(Copy),而在等号左侧进行布尔切片赋值则是原位修改(In-place Assignment)。
这意味着执行 filtered = matrix[mask] 后修改 filtered 绝不会波及 matrix;但执行 matrix[mask] = 0 时,NumPy 会直接通过底层物理步长穿透并修改原始连续内存块,不会分配新的矩阵对象,内存利用率极高。
高效条件替换:三元替换与多分支分段赋值
当需要根据 01 矩阵或布尔条件同时对矩阵的正反两个状态做不同赋值时,np.where(condition, x, y) 提供了类似于 C 语言三元运算符的向量化能力:
import numpy as np

# 假设原矩阵包含连续测量数据
raw_data = np.array([
    [15, -2, 45],
    [-8, 60, -1],
    [30, 25, -9]
])

# 技巧 1:原位截断与离群值置零
# 将所有负数直接归零(无需新建数组)
raw_data[raw_data < 0] = 0

# 技巧 2:基于条件的三元批量替换
# 若大于 30 赋为 1,否则保留原值(或者赋为 0 生成标准 01 矩阵)
binary_flag = np.where(raw_data >= 30, 1, 0)
# 示例输出:
# array([[0, 0, 1],
#        [0, 1, 0],
#        [1, 0, 0]])

# 技巧 3:多条件分段映射(np.select)
cond_list = [raw_data == 0, (raw_data > 0) & (raw_data < 30), raw_data >= 30]
choice_list = [0, 1, 2] # 分别映射为静默、常规、饱和三个等级
classified = np.select(cond_list, choice_list)
五、综合实战案例:二值连通邻域与孤立噪点过滤
为了完整展现 01 矩阵逻辑运算、布尔索引与原位赋值的协作流程,下面通过一个经典的工程场景进行演示:在一张由 0 与 1 构成的二值网格中,快速剔除上下左右四邻域没有任何有效连接的“孤立噪点”。
import numpy as np

# 构造一个 5x5 的 01 观测网格(1 表示信号,0 表示背景)
grid = np.array([
    [0, 1, 0, 0, 0],
    [0, 0, 0, 1, 1],
    [0, 1, 0, 1, 1],
    [0, 0, 0, 0, 0],
    [1, 0, 0, 0, 0]
], dtype=int)

# 目标:找出所有等于 1 但周围没有相邻有效信号的孤立点并清除
# 利用切片对齐构造四个方向的 01 邻接平移矩阵
H, W = grid.shape
up    = np.zeros_like(grid)
down  = np.zeros_like(grid)
left  = np.zeros_like(grid)
right = np.zeros_like(grid)

# 利用切片进行邻域投影
up[:-1, :]  = grid[1:, :]   # 下方向上的邻接投影
down[1:, :] = grid[:-1, :]  # 上方向下的邻接投影
left[:, :-1]  = grid[:, 1:] # 右方向左的邻接投影
right[:, 1:] = grid[:, :-1] # 左方向右的邻接投影

# 1. 逻辑或运算:只要任意一个方向有信号,即视为“具有邻居”
has_neighbor = (up == 1) | (down == 1) | (left == 1) | (right == 1)

# 2. 复合逻辑运算:自身为 1 且 无邻居(使用 ~ 或 np.logical_not)
isolated_noise_mask = (grid == 1) & (~has_neighbor)

print("被识别出的孤立点坐标 (行, 列):")
print(np.argwhere(isolated_noise_mask))
# 示例输出显示:[0, 1]、[2, 1]、[4, 0] 这三个点没有任何邻居连接

# 3. 原位赋值:直接将孤立噪点清洗为 0
grid[isolated_noise_mask] = 0

print("降噪后的连通图矩阵:")
print(grid)
# 此时仅保留了右上方聚集的 2x2 连通区域信号
六、语法速查与常见禁忌对照
为便于日常开发与代码重构时核对,下表系统梳理了 01 矩阵与布尔运算的核心语法范式与常见错误操作:
| 需求类别 | 推荐规范写法 | 严禁错误 / 危险写法 | 机制说明与风险警示 |
|---|---|---|---|
| 条件组合(交集) | (A == 1) & (B == 1) |
A == 1 and B == 1或 A == 1 & B == 1 |
原生 and 触发真值模糊异常;缺少括号会导致 & 优先计算发生逻辑错位。 |
| 条件组合(并集) | (A == 1) | (B == 1) |
A == 1 or B == 1 |
原生 or 无法做逐元素广播求值,必须使用重载运算符 |。 |
| 掩码取反(补集) | ~(mask)(仅限布尔类型)或 np.logical_not(arr) |
~int_matrix |
整型按位取反会产生 -1、-2 等负数补码,后续布尔判断全被误判为 True。 |
| 多维元素提取 | data[mask] |
期望其保持二维形状 | 因各行匹配数量不均等,NumPy 必定折叠降维为一维数组;需保位置应配合 np.where。 |
| 条件原位修改 | matrix[mask] = 0 |
sub = matrix[mask]; sub[:] = 0 |
布尔切片读操作生成独立副本(Copy),修改中间变量 sub 无法反哺原矩阵。 |
| 双向状态替换 | np.where(cond, val_true, val_false) |
使用 Python 原生 if-else 循环逐个元素遍历 |
np.where 是底层 C 实现的向量化指令,执行速度比原生循环快数十倍至数百倍。 |
掌握 01 矩阵在 NumPy 中的数据表达与布尔索引特性,关键在于建立“内存形态(数值与真值)— 逐元素向量化指令 — 降维与原位修改”的完整知识链路。养成给复合位运算加圆括号、在取反前明确检查数据类型、合理利用 np.where 保持坐标信息的习惯,能够从根本上规避隐蔽的逻辑漏洞,让矩阵计算代码既高效又健壮。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















