


Python支持中文吗?Python 3原生Unicode与中文变量名使用规范

明确地回答:Python完全支持中文,而且在Python 3中是原生、全方位的深度支持。在Python 3中,源代码文件默认采用UTF-8编码,内存中的所有字符串类型(str)全都是Unicode字符序列;不仅字符串内容、文件读写和注释可以随意书写汉字,连变量名、函数名、类名等语法标识符也可以直接使用中文编写并正常运行。本文将通过底层机制、语法规范、代码示例和团队工程协作准则,为你完整梳理中文在Python 3中的运行逻辑与正确使用方式。
一、Python 2与Python 3的中文支持差异与底层演进
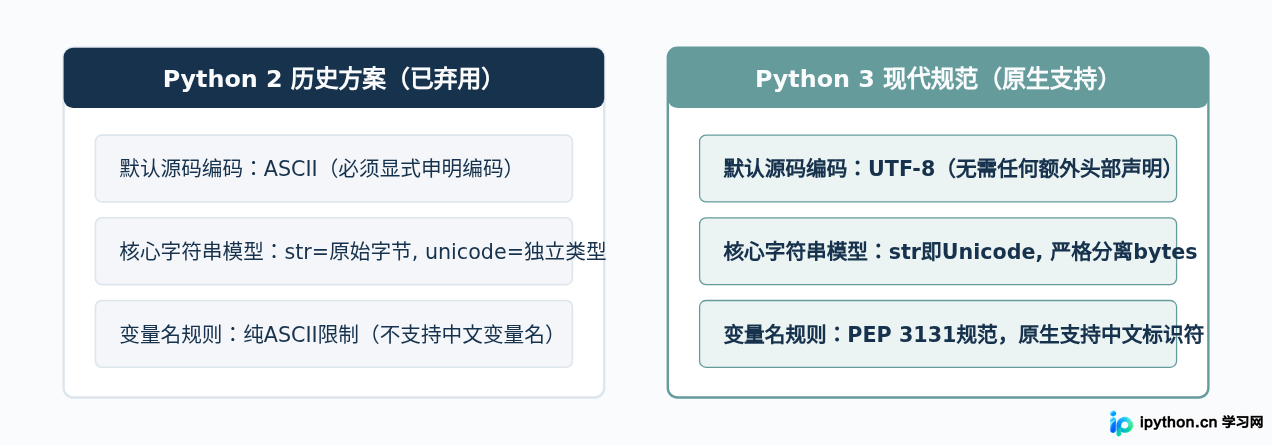
很多开发者之所以对“Python是否支持中文”心存疑虑,根源往往在于早期Python 2遗留下来的编码痛点。在Python 2时代,默认源码编码是ASCII,如果文件中出现汉字却未在首行显式声明# -*- coding: utf-8 -*-,解释器在词法解析阶段就会直接抛出SyntaxError。同时,Python 2的默认字符串是原始字节串(bytes),Unicode类型需要额外加u前缀(如u"你好"),两者的隐式转换极易引发臭名昭著的UnicodeDecodeError。
自Python 3.0起,解释器完成了一次根本性的底层架构革新:
- 源码默认UTF-8:不需要在脚本第一行手动指定编码,解释器默认且强制按照UTF-8规范读取
.py文件。 - 字符串全量Unicode:基础类型
str即代表Unicode文本序列,每个字符对应唯一的Unicode码点;原始二进制数据则完全剥离给专门的bytes类型,二者界限清晰,杜绝隐式混乱转换。 - 标识符开放Unicode范围(PEP 3131):Python 3正式引入了PEP 3131提案,允许在标识符(变量名、函数名、类名等)中使用非ASCII字符,包括绝大多数CJK(中日韩)汉字字符。
二、中文变量名的语法支持与运行原理
在语法层面,Python 3将汉字视同为有效的标识符字符。汉字在Unicode字符数据库中属于字符分类中的“字母”(Letter, 即Lo类别)。根据Python词法规范,只要字符属于Unicode中的字符类别,就可以作为变量名的开头或中间字符。
1. 中文变量名基础代码示例
以下代码展示了中文在变量名、函数定义、类属性及结构解构中的完整可用性:
# -*- 示例:Python 3 中文变量与逻辑编写 -*-

class 订单结算器:
    def __init__(self, 客户名称: str, 基础费率: float = 0.95):
        self.客户名称 = 客户名称
        self.基础费率 = 基础费率

    def 计算实际金额(self, 原始金额: float) -> float:
        实付金额 = 原始金额 * self.基础费率
        return round(实付金额, 2)

# 实例化对象并调用方法
当前客户 = 订单结算器("北京研发中心", 基础费率=0.88)
消费原价 = 1580.0
实际应付 = 当前客户.计算实际金额(消费原价)

print(f"客户:{当前客户.客户名称},原价:{消费原价}元,结算折扣后:{实际应付}元")
在安装了Python 3的任何标准终端中执行上述脚本,均可直接输出结果:
示例输出:
客户:北京研发中心,原价:1580.0元,结算折扣后:1390.4元
2. 语法合法性检验:str.isidentifier()
如果不确定某个包含中文的名称是否符合Python语法规则,可以使用字符串内置方法isidentifier()进行运行时判断。汉字均能通过检测,但全角标点符号则不能:
print("销售总额".isidentifier())     # 输出: True (合法标识符)
print("用户_ID".isidentifier())     # 输出: True (合法标识符)
print("金额(元)".isidentifier())   # 输出: False(括号为标点符号,非法)
print("2号仓库".isidentifier())     # 输出: False(数字不能作为标识符开头)
3. 解释器处理标识符的底层归一化流程(NFKC)
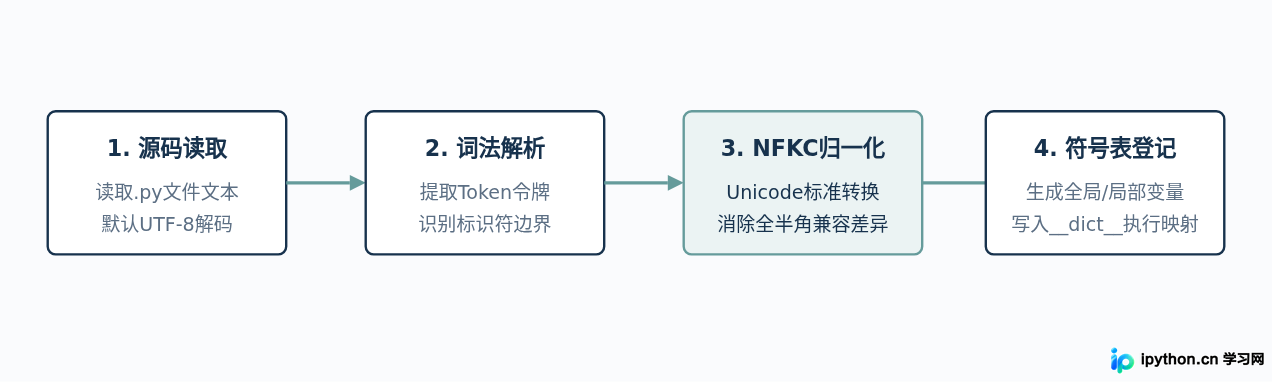
为了保证代码在不同输入法输入时的语义一致性,Python解释器在编译代码时,会通过Unicode标准规范的NFKC(兼容性等价分解与规范重组)格式对所有标识符做归一化处理。例如,全角英文字母(如ABC)会被自动转换为半角标准ASCII字母(ABC)。
三、中文变量名在工程实践中的潜在问题与边界陷阱
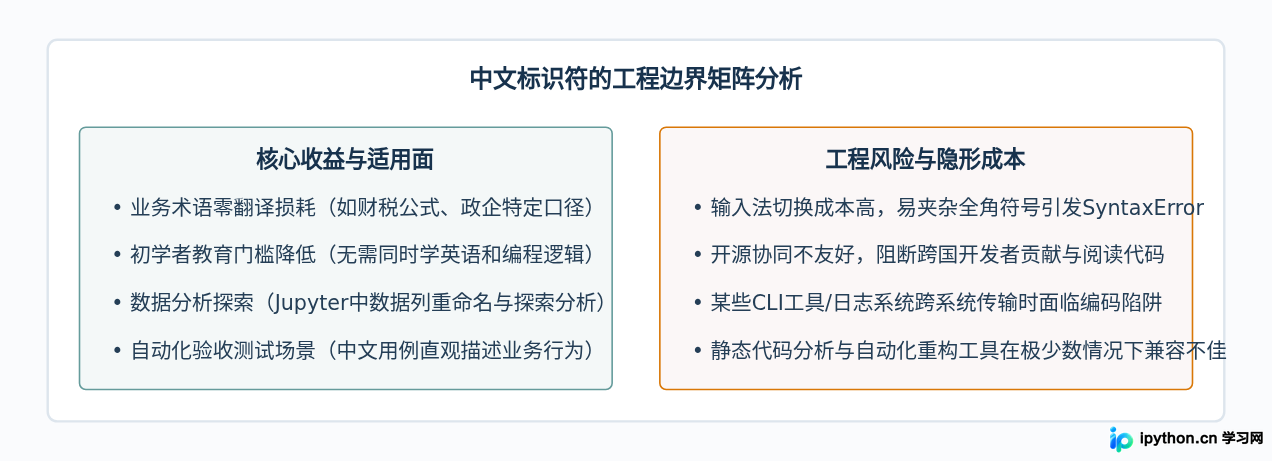
虽然语法上完全合法,但在严谨的企业级软件工程中,全面使用中文命名变量往往面临不可忽视的实操痛点:
1. 全角与半角符号误用导致的语法错误
中文输入法激活状态下,极易无意识打出全角标点。Python虽然对变量名字符宽容,但对语法分隔符(逗号、括号、冒号、引号)要求必须是严格的ASCII半角字符。混淆全半角标点会导致直接的解析错误:
# 错误示例:使用了全角冒号与全角逗号
def 汇总数据(数据列表):  # 此处括号和冒号为全角符号,SyntaxError!
    pass

# 正确写法:语法符号必须切回半角ASCII
def 汇总数据(数据列表):
    pass
2. 序列化与跨系统交互障碍
当对象需要转换为JSON、XML、数据库表字段,或通过网络协议与Java、C++、Go等其他语言后端交互时,中文字段名往往容易因为编码配置不统一导致乱码或反序列化失败。例如在某些默认GBK环境的旧版Windows系统命令提示符中,如果终端编码与程序编码不一致,控制台输出中文可能会报错或显示异常字符。
3. 编辑器兼容性与输入效率瓶颈
编写包含中文变量名的代码时,开发者需要频繁在中英文输入状态间反复切换(敲击代码语法符号需要英文,输入变量名需要中文),严重影响编码流畅度。同时,部分轻量级编辑器或Git差异比对工具对非ASCII单字的字体渲染支持有限,可能会出现光标对齐错位问题。
四、中文变量名使用规范与最佳实践指南
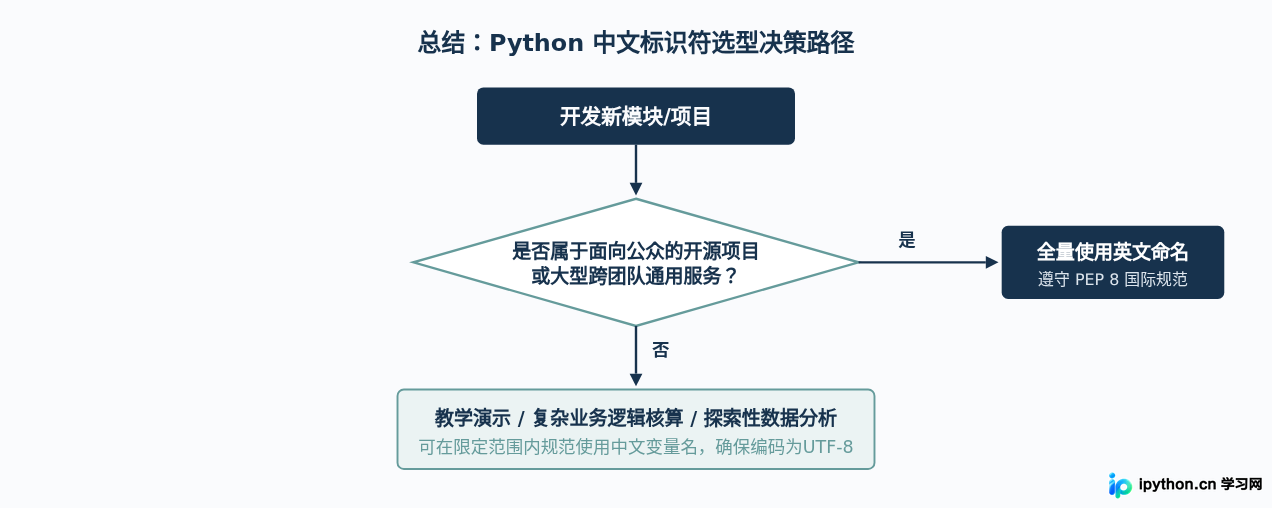
综上所述,技术上的“能用”并不等同于工程上的“滥用”。PEP 8官方代码风格指南建议:Python标准库和面向大众的开源项目代码必须使用纯ASCII英文字符作为变量名。基于国内实际研发场景,推荐遵守以下分级规范:
| 场景类别 | 推荐策略 | 具体规范与建议 |
|---|---|---|
| 公共库 / 开源项目 / 团队基础中间件 | 严格禁止 | 遵循PEP 8,全量采用标准英文命名,方便国际协同与自动化CI/CD流程。 |
| 复杂领域模型 / 政策核算引擎 | 谨慎使用 / 局部允许 | 当行业专属中文概念(如“五险一金抵扣基数”)极难找到精准无歧义的简短英文时,在核心计算函数内可用中文,但对外暴露的API参数仍推荐英文。 |
| 数据分析 / Jupyter Notebook原型 | 完全允许 | 在Pandas处理以中文为表头的原始业务数据、生成分析图表时,保持列名为中文直接索引能大幅提高研究效率。 |
| 少儿编程 / 非计算机专业教学 | 高度推荐 | 教学初期使用中文变量名,能帮助学生剥离语言障碍,聚焦于“条件判断、循环结构、数据流”等核心计算思维。 |
如果在项目允许的范围内采用中文标识符,务必牢记三点:
- 确保团队所有机器统一使用支持UTF-8的环境与现代代码编辑器(如VS Code、PyCharm)。
- 禁止将中文变量名与特殊标点(全角括号、全角空格等)连用。
- 当涉及文件IO保存、跨服务RPC通信时,务必使用显式的
utf-8编码编解码,严禁依赖操作系统的默认环境编码。
五、全文总结
归结起来,Python 3在底层设计上对中文有着极佳的原生支持,字符全面Unicode化从根本上解决了语言字符集的兼容问题。无论是字符串处理还是变量名定义,Python都具备完善的中文识别能力。在实际编写代码时,我们需要分清“语法允许”与“工程效率”的区别:对于开源协作与系统底层接口,坚持标准英文字符命名;而在教学研究、特殊领域精算、数据预处理等特定场景下,合理运用中文变量名同样可以起到降低认知负担、明确业务逻辑的积极效果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















