


Python类型注解会影响运行速度吗?原理与性能分析

假设你正在重构一个高频调用的数据处理模块,为了提升团队协作效率和代码可读性,你准备为所有核心函数加上详细的类型注解。此时你可能会产生顾虑:给每一处变量和参数打上标签,会不会让 Python 解释器在运行时承担额外的校验包袱,从而拉慢整体执行速度?
先说核心结论:在标准 CPython 解释器中,类型注解在函数执行阶段对运行速度几乎没有负面影响,但也绝不会自动提升执行速度。它的实际开销主要集中在模块初次导入与定义阶段;若在运行时结合第三方库进行强行校验,则会产生明显的计算损耗。
一、为什么函数执行时类型注解不影响速度?
要搞清楚类型注解在执行期为何“隐形”,需要观察 Python 源码被编译成字节码后的实际指令。Python 的类型注解(Type Hints)本质上是元数据,官方在语言设计之初就明确它不会改变运行时求值逻辑。
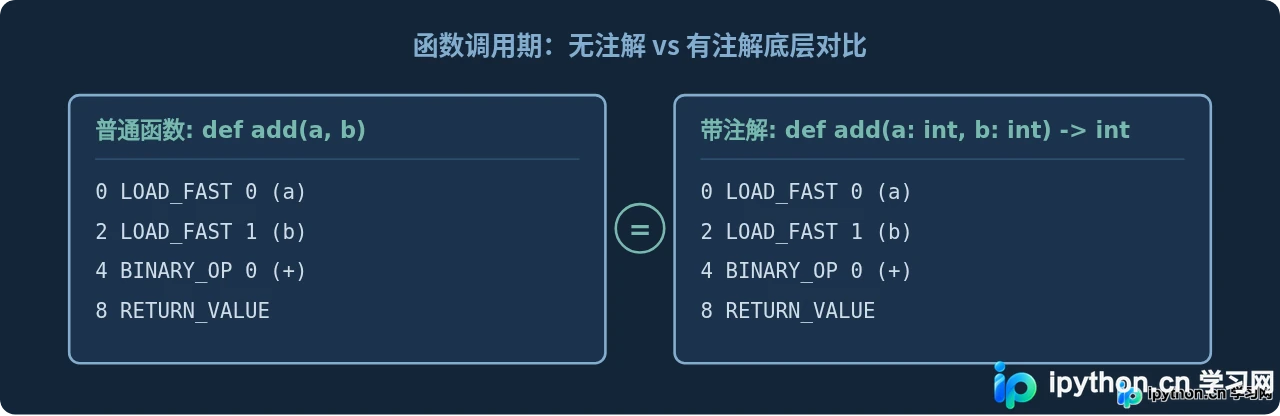
我们可以使用标准库的 dis 模块,对比带注解与不带注解的同一个函数:
import dis

def add_plain(a, b):
    return a + b

def add_annotated(a: int, b: int) -> int:
    return a + b

print("--- 无类型注解 ---")
dis.dis(add_plain)

print("\n--- 包含类型注解 ---")
dis.dis(add_annotated)
执行上述脚本后的示例输出如下:
--- 无类型注解 ---
  2           0 LOAD_FAST                0 (a)
              2 LOAD_FAST                1 (b)
              4 BINARY_OP                0 (+)
              8 RETURN_VALUE

--- 包含类型注解 ---
  5           0 LOAD_FAST                0 (a)
              2 LOAD_FAST                1 (b)
              4 BINARY_OP                0 (+)
              8 RETURN_VALUE
从字节码结果可以看到,两个函数的指令序列完全一致:都是加载局部变量、执行加法运算并返回结果。CPython 虚拟机在执行 add_annotated 时,根本没有生成任何检查 a 或 b 是否真的是 int 的操作码。既然根本没有类型判断的开销,函数每次被调用的耗时自然不会因为增加了注解而变长。
二、性能开销真实存在的地方:导入与定义期
虽然高频调用函数时不耗时,但这并不代表类型注解是零成本的。类型注解的开销前置到了模块加载(Import)与函数定义阶段。
当 Python 解释器首次执行到一个带有注解的函数时,必须对类型表达式进行求值,并将求值结果存入该函数的 __annotations__ 字典中。如果注解结构复杂,求值过程就需要耗费额外的 CPU 时间和内存。
def process_data(mapping: dict[str, list[int]]) -> None:
    pass

# 注解被编译并存储在属性中
print(process_data.__annotations__)
# 输出: {'mapping': dict[str, list[int]], 'return': None}
为了直观理解这个机制,我们看下面的模块加载全流程:
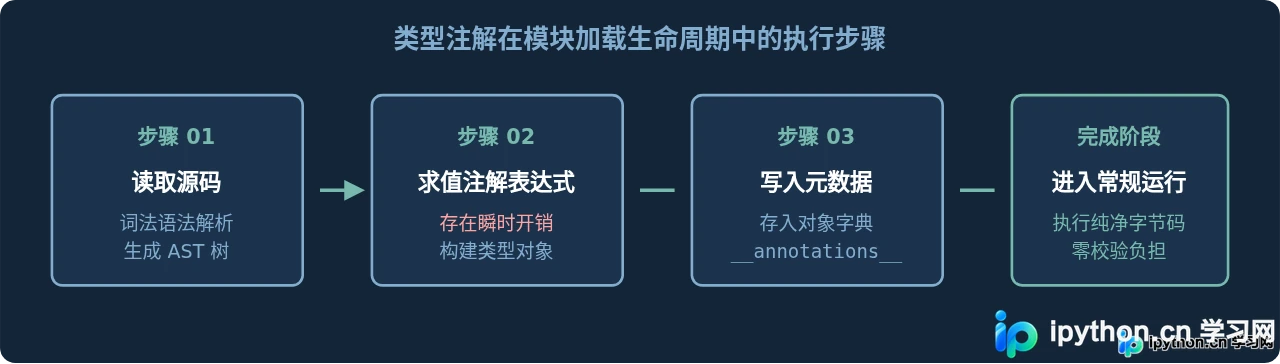
对于长期运行的 Web 服务或后台常驻任务,这微秒级的导入耗时可以忽略不计;但对于 CLI 命令行工具或 Serverless 无服务架构(如云函数冷启动),累积成百上千个带有复杂注解的模块会稍微拉长启动延迟。
三、容易产生性能损失的具体场景
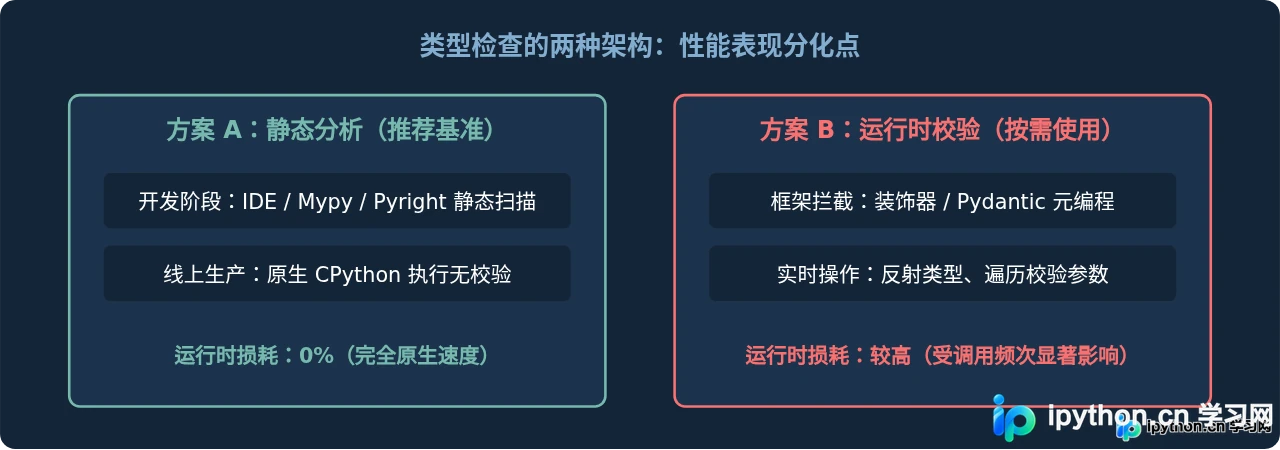
如果业务中确实出现了“加了注解后变慢”的情况,通常并不是 Python 本身造成的,而是由以下两个使用方式引起的:
1. 引入了运行时强校验框架
在原生 Python 中,传入与注解不符的参数完全可以正常运行:
def multiply(x: int, y: int) -> int:
    return x * y

# 传入浮点数不会触发错误,原样计算
print(multiply(2.5, 4.0))  # 输出 10.0
但如果在代码中使用了 Pydantic 或自定义类型检查装饰器(如 typeguard),框架会在函数被调用的那刻,通过反射拦截参数并逐个进行类型核对:
from pydantic import validate_call

@validate_call
def multiply_strict(x: int, y: int) -> int:
    return x * y
此时,每次函数调用都会叠加一层类型反射与数据转换的开销。对于每秒调用数十万次的密集循环,性能可能会出现数倍甚至数十倍的下降。
2. 导入了仅在静态检查时使用的沉重模块
有时候为了定义类型注解,我们不得不从大型库中导入类。如果直接写在文件顶部,即使运行时完全不用它,Python 也会在启动时加载整个模块。
四、消除潜在开销的最佳实践
为了既享受类型注解带来的智能补全和代码健壮性,又完全规避启动开销与依赖导入负担,可以采用以下两个标准做法:
1. 启用延迟求值(PEP 563)
在文件头部引入 from __future__ import annotations,Python 就不会在加载模块时立刻去求值注解,而是将注解统一当成纯字符串存储。这不仅大幅降低模块导入时的 CPU 开销,还能直接避免循环引用问题。
from __future__ import annotations

# 此处 dict[str, list[int]] 不会在导入阶段实例化复杂对象,直接存为字符串字面量
def parse_mapping(data: dict[str, list[int]]) -> None:
    pass

print(parse_mapping.__annotations__)
# 输出: {'data': 'dict[str, list[int]]', 'return': 'None'}typing.get_type_hints()。
2. 使用 TYPE_CHECKING 隔离重量级引用
如果某些类型注解需要引用非常沉重的模块或仅用于类型断言的类,可以使用 typing.TYPE_CHECKING 常量。该常量在静态检查器(如 Mypy)扫描时为 True,但在程序实际运行时永远为 False:
from __future__ import annotations
from typing import TYPE_CHECKING

if TYPE_CHECKING:
    # 仅静态检查时导入,运行时完全不加载该模块,无任何性能与内存开销
    from heavy_package import ComplexDataStructure

def handle_data(item: ComplexDataStructure) -> None:
    pass
五、全文总结与决策参考
面对“要不要加类型注解”的疑问,可以参照下面的分类矩阵做出合理判断:
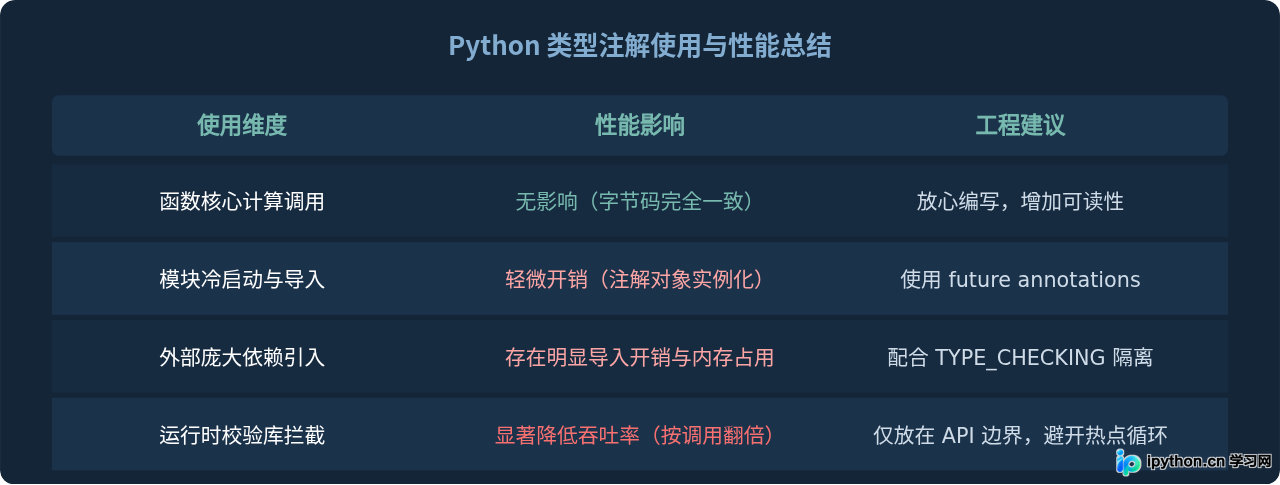
简单归纳:类型注解本身绝不是性能杀手。在日常绝大多数业务逻辑中,你可以放心地全面使用类型注解,将类型检查的工作安心交给 CI 流程中的 mypy 或编辑器的静态诊断。只要不将它作为高频循环内的运行时拦截器,它就不会对生产环境的运行速度造成任何阻碍。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















