


Python列表能当多维数组用吗?嵌套list与NumPy数组的区别

答案是:在语义和基础存取上可以,但在工程性能与数学运算上绝对不行。 Python的原生嵌套列表通过“列表套列表”的形式,能够表达棋盘、矩阵或层级数据结构,也能完成二维索引与遍历。然而,嵌套列表并非真正的多维数组。当面临批量数学运算、高维切片或大规模数据时,嵌套列表不仅代码冗长、极易引发浅拷贝隐患,在运行效率和内存开销上更与专门的科学计算数组存在质的差距。
一、直接回答:嵌套列表何时“能用”,何时“不能用”
是否使用嵌套列表代替多维数组,关键取决于你的数据规模以及你打算对这些数据执行什么操作:
- 允许使用的场景: 小规模数据的逻辑组合(如 3×3 的井字棋棋盘、网格配置、文本解析中的分段行结构);不需要引入外部第三方依赖的简单纯 Python 脚本;数据各行的长度本就不规则(锯齿数组)。
- 严禁替代的场景: 矩阵乘法、线性代数分解、广播运算等数学计算;成千上万行以上的量级数据;图像像素处理、音频信号处理与机器学习特征工程。在这些场景下,NumPy 提供的
ndarray才是真正的标准多维数组。
二、认知层对比:嵌套引用与连续内存
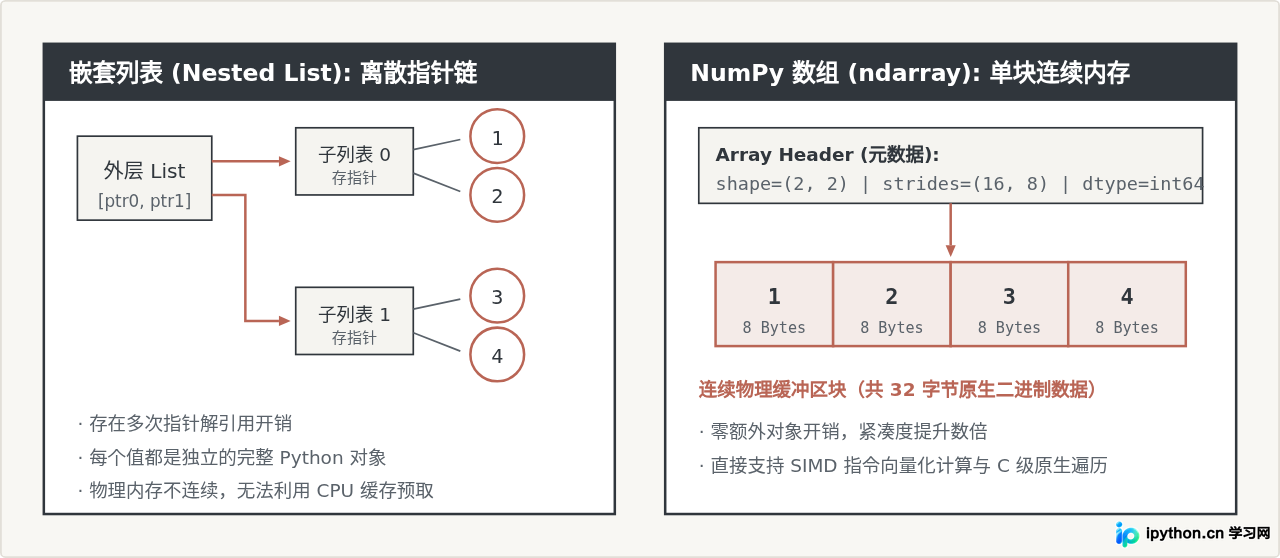
初学者常误以为 matrix = [[1, 2], [3, 4]] 是一个规整的二维矩形块。但从底层实现来看,Python 的 list 是一个存储指针(引用)的动态数组。
外层列表并不包含实际数值,它仅仅保存了两个指针,分别指向两个独立的内层子列表;而每个子列表内又分别保存了指向独立 Python 整数对象的指针。每个整数在 CPython 中都是一个完整的 PyObject(包含类型指针和引用计数,通常占据 28 字节以上)。这意味着数据在物理内存中完全是离散分布的,CPU 无法利用连续缓存(Cache Line)预取数据。
相反,NumPy 的 ndarray 在内存中分配的是一块严格连续的二进制字节缓冲区。一个形状为 (2, 2) 的整型 NumPy 数组,在物理内存上就是 4 个紧挨着的 64 位(8 字节)整数,元数据(维度、步长、数据类型)单独保存在数组头部。
三、实践陷阱:嵌套列表初始化中的“浅拷贝大坑”
如果你确实需要在不依赖第三方库的情况下创建一个 3×3 全零网格,新手极容易使用乘法语法,从而写出致命的隐蔽错误。
1. 乘法复制的浅拷贝灾难
# 错误做法:乘法复制子列表
grid_bad = [[0] * 3] * 3

# 修改坐标 (0, 0) 为 9
grid_bad[0][0] = 9
print(grid_bad)
虽然代码直观,但 [sub_list] * 3 只复制了子列表的对象引用3次。内存中实际上只有一个由 3 个零组成的列表,外层列表存储的是同一个内存地址的三份副本。修改其中任意一行的元素,其他行都会同时变化。
2. 正确的推导式创建流程与对比
纯 Python 中唯一可靠的多维全零网格构建方式是使用列表推导式,显式促使 Python 解释器在每次循环中构建全新、独立的列表对象:
# 正确做法:使用列表推导式
grid_correct = [[0 for _ in range(3)] for _ in range(3)]
grid_correct[0][0] = 9
print(grid_correct)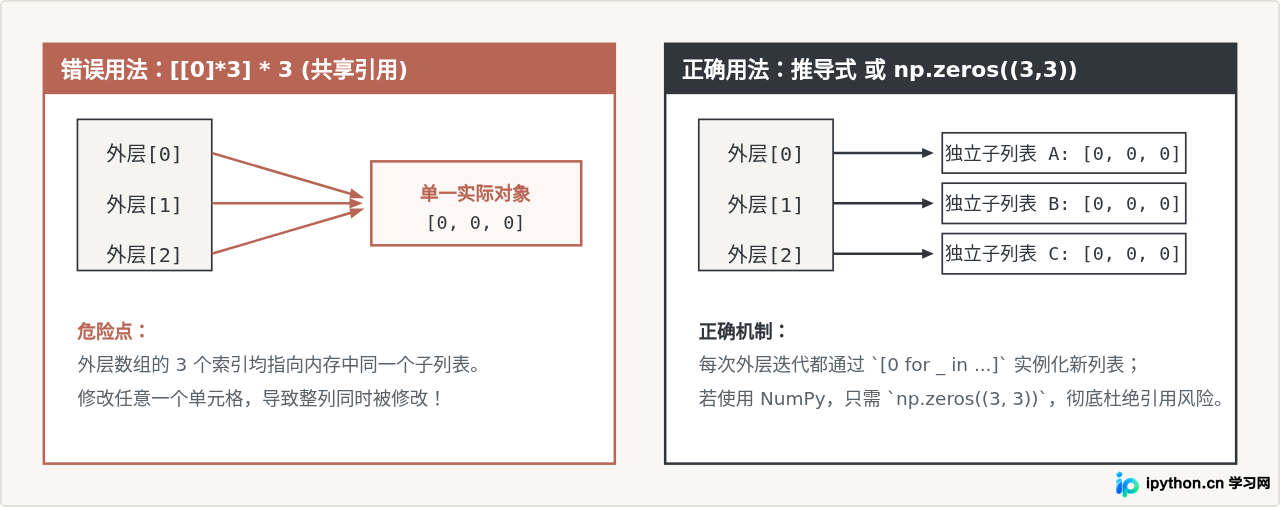
四、语法与操作差异:从索引、切片到数学运算
如果越过初始化阶段,直接进行数据的访问和处理,嵌套列表与 NumPy 数组的操作模式存在显著差异。
1. 索引与切片取值
嵌套列表只能使用连续的单轴方括号 list[row][col],无法一次性实现真正的高维切片。如果你想取出二维网格的“第二列全部数据”,嵌套列表必须借助列表推导式遍历提取,而 NumPy 则支持规范的逗号多维切片:
# 嵌套列表获取第 1 列(第二列)
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]
# 必须显式遍历每一行取对应位置
col_1 = [row[1] for row in matrix]
print("List 提取第二列:", col_1)

# NumPy 数组切片
import numpy as np
arr = np.array(matrix)
# arr[行切片, 列切片]
print("NumPy 提取第二列:", arr[:, 1])List 提取第二列: [2, 5, 8]
NumPy 提取第二列: [2 5 8]
2. 数学运算与广播机制
Python 列表上的运算符(如 + 和 *)执行的是序列拼接与重复,并不具备元素级代数意义。想要让一个 3×3 嵌套列表的所有数字乘以 2,你必须写双层嵌套循环。而在 NumPy 中,所有算术运算符均默认向量化并原生支持广播:
# 列表相加 = 拼接;列表乘法 = 复制
lst = [1, 2, 3]
print("List lst * 2:", lst * 2)

# NumPy 向量化元素计算
narr = np.array([1, 2, 3])
print("NumPy narr * 2:", narr * 2)
print("NumPy narr + 10:", narr + 10)List lst * 2: [1, 2, 3, 1, 2, 3]
NumPy narr * 2: [2 4 6]
NumPy narr + 10: [11 12 13]
五、性能与内存实测对比
为了直观感受底层差异带来的工程影响,我们对比处理一个 1000 × 1000(一百万个 64 位整数)矩阵时的资源占用与计算耗时。
import sys
import time
import numpy as np

# 1. 内存对比
rows, cols = 1000, 1000

# 纯 Python 列表
nested_list = [[i for i in range(cols)] for _ in range(rows)]
# 计算外层列表、内层列表以及所有整数对象的近似内存(字节)
size_list_approx = (
    sys.getsizeof(nested_list)
    + sum(sys.getsizeof(row) for row in nested_list)
    + (rows * cols * 28) # 每个独立 int 对象约 28 字节
)

# NumPy 数组
np_arr = np.zeros((rows, cols), dtype=np.int64)
size_numpy = np_arr.nbytes + sys.getsizeof(np_arr)

# 2. 运算时间对比 (全部元素 * 2)
# 纯 Python 双层推导式
t0 = time.perf_counter()
res_list = [[val * 2 for val in row] for row in nested_list]
t1 = time.perf_counter()
list_time = t1 - t0

# NumPy 向量化计算
t2 = time.perf_counter()
res_np = np_arr * 2
t3 = time.perf_counter()
numpy_time = t3 - t2

print(f"内存占用估算: List 约 {size_list_approx / 1024 / 1024:.2f} MB, NumPy 仅 {size_numpy / 1024 / 1024:.2f} MB")
print(f"矩阵标量乘法耗时: List 用时 {list_time:.4f} 秒, NumPy 用时 {numpy_time:.4f} 秒")内存占用估算: List 约 35.80 MB, NumPy 仅 7.63 MB
矩阵标量乘法耗时: List 用时 0.0520 秒, NumPy 用时 0.0006 秒 (速度相差近 80-100 倍)
从测试结果可以看出:
- 内存膨胀显著: 嵌套列表的内存消耗是连续 NumPy 数组的 4 到 5 倍以上。这主要是由于
PyObject包装头信息及指针引用的冗余所致。 - 计算效率差距悬殊: 简单的标量乘法,NumPy 就展现出了近百倍的性能优势。这是因为 NumPy 将核心计算下推到了编译好的 C 循环与 CPU 向量化扩展指令(如 AVX2、AVX-512)执行,完全避开了 Python 解释器在运行时逐个对象的类型检查、动态派发与垃圾回收开销。
六、维度约束:规则矩形 vs 锯齿数组(Ragged Array)
嵌套列表与 NumPy 数组在维度规范性上也存在本质约束差异:
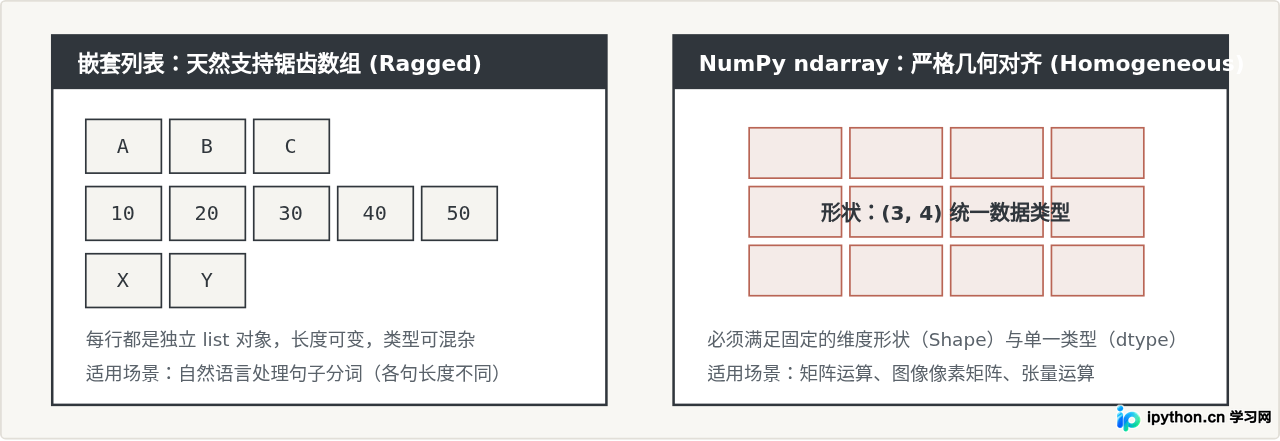
嵌套列表完全允许不规则的“锯齿状”结构。 第一行可以有 3 个元素,第二行可以有 10 个元素,第三行甚至可以塞入字符串或字典。Python 不会对列表子元素的长度和类型做任何强制校验。
NumPy 数组原则上要求严格的“几何对齐”与“同质类型”。 多维 ndarray 的每一行必须长度一致,所有元素必须为统一的数值类型(如 float32、int64)。虽然 NumPy 也能通过 dtype=object 强行塞入长度不一的序列,但这会导致数组退化为包含 Python 指针的容器,失去连续内存加速的全部意义。
七、技术属性综合对照表
为了方便快速查阅,以下将 Python 嵌套列表与 NumPy ndarray 的核心技术维度汇总对照:
| 对比属性 | Python 嵌套列表 (Nested List) | NumPy 多维数组 (ndarray) |
|---|---|---|
| 物理内存分配 | 离散分配,通过指针层层解引用,缓存命中率低 | 连续单一内存块,高度利用 CPU 缓存与预取 |
| 类型同质性 | 异构,同一列表可混存数字、字符串、字典等任意对象 | 同质(Homogeneous),所有元素具有固定的单个原生类型 |
| 数据形状约束 | 无约束,天然支持锯齿数组(各行长度不等) | 严格统一,每一维度必须对齐(矩形/长方体/N维张量) |
| 切片语法支持 | 单维度提取(需列表推导式提取多列) | 多轴逗号切片(如 arr[:, 1:4]),返回视图避免拷贝 |
| 代数算术行为 | + 表示拼接,* 表示复制 |
元素级代数运算,支持高维自动广播机制 |
| 外部依赖 | 无,Python 内置标准功能 | 需安装第三方库(pip install numpy) |
| 执行性能 | 解释器逐行循环解释,开销大,速度慢 | 预编译 C / Fortran 内核驱动,支持 SIMD 硬件加速 |
八、架构选择决策路径
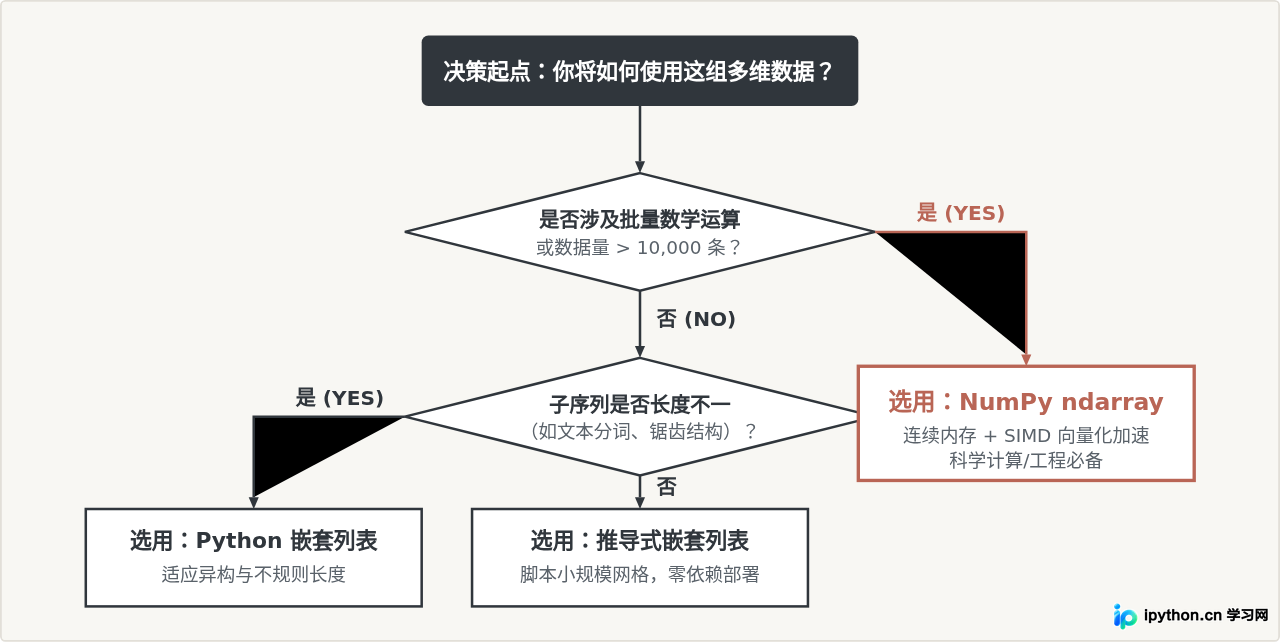
在实际项目落地时,你无需纠结于概念之争,直接遵循以下决策流程来决定使用哪种数据结构:
总结
回到标题的核心问题:Python 列表能当多维数组用吗?
答案的边界非常清晰:你可以用它在纯 Python 环境下组织小规模的层级关系、表示不规则的锯齿序列或搭建简单的棋盘模型。但只要涉及真正的“数值阵列计算”,嵌套列表在内存布局、切片逻辑与执行效率上就全面落于下风。理解指针链与连续缓冲区的区别,避开乘法浅拷贝的陷阱,并在适当时机果断迁移到 NumPy,是写出健壮且高性能 Python 代码的基础功底。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















