


Python3实战:爬取捧腹网与糗百笑话的完整教程

本文详细演示如何使用Python3结合urllib和BeautifulSoup库抓取网页笑话内容。文章从基础HTML结构分析入手,讲解如何定位目标元素,并深入解决因User-Agent被拒导致的RemoteDisconnected错误。通过代码示例,展示了如何配置请求头伪装浏览器,从而成功获取捧腹网和糗百的笑话数据,适合Python初学者参考。
Python3制作捧腹网段子页爬虫
0x01
春节期间闲暇时间较多,便编写了一个简单的程序来抓取一些笑话供娱乐,同时也记录下开发过程。初次接触爬虫技术时,曾看到有人通过脚本抓取煎蛋网图片,操作简便且效果显著。受此启发,我也尝试模仿并抓取了一些图片数据。
作为程序员,虽然技术可以应用于各种场景,但抓取笑话似乎更符合身心健康的需求。
爬虫理论基础与网页分析
0x02
在正式编写代码之前,先简要介绍相关的理论基础。
简单来说,爬虫的核心任务是从网页中提取特定位置的内容。为此,我们需要先分析目标网页的结构,确定所需数据的位置。例如,本次目标是抓取捧腹网段子页的笑话。打开该页面后,可以看到大量笑话内容,我们的目标就是提取这些信息。建议在操作前冷静分析,避免被页面内容干扰。在Chrome浏览器中,使用“审查元素”功能,逐级展开HTML标签或使用定位工具,可以找到我们需要的元素节点。
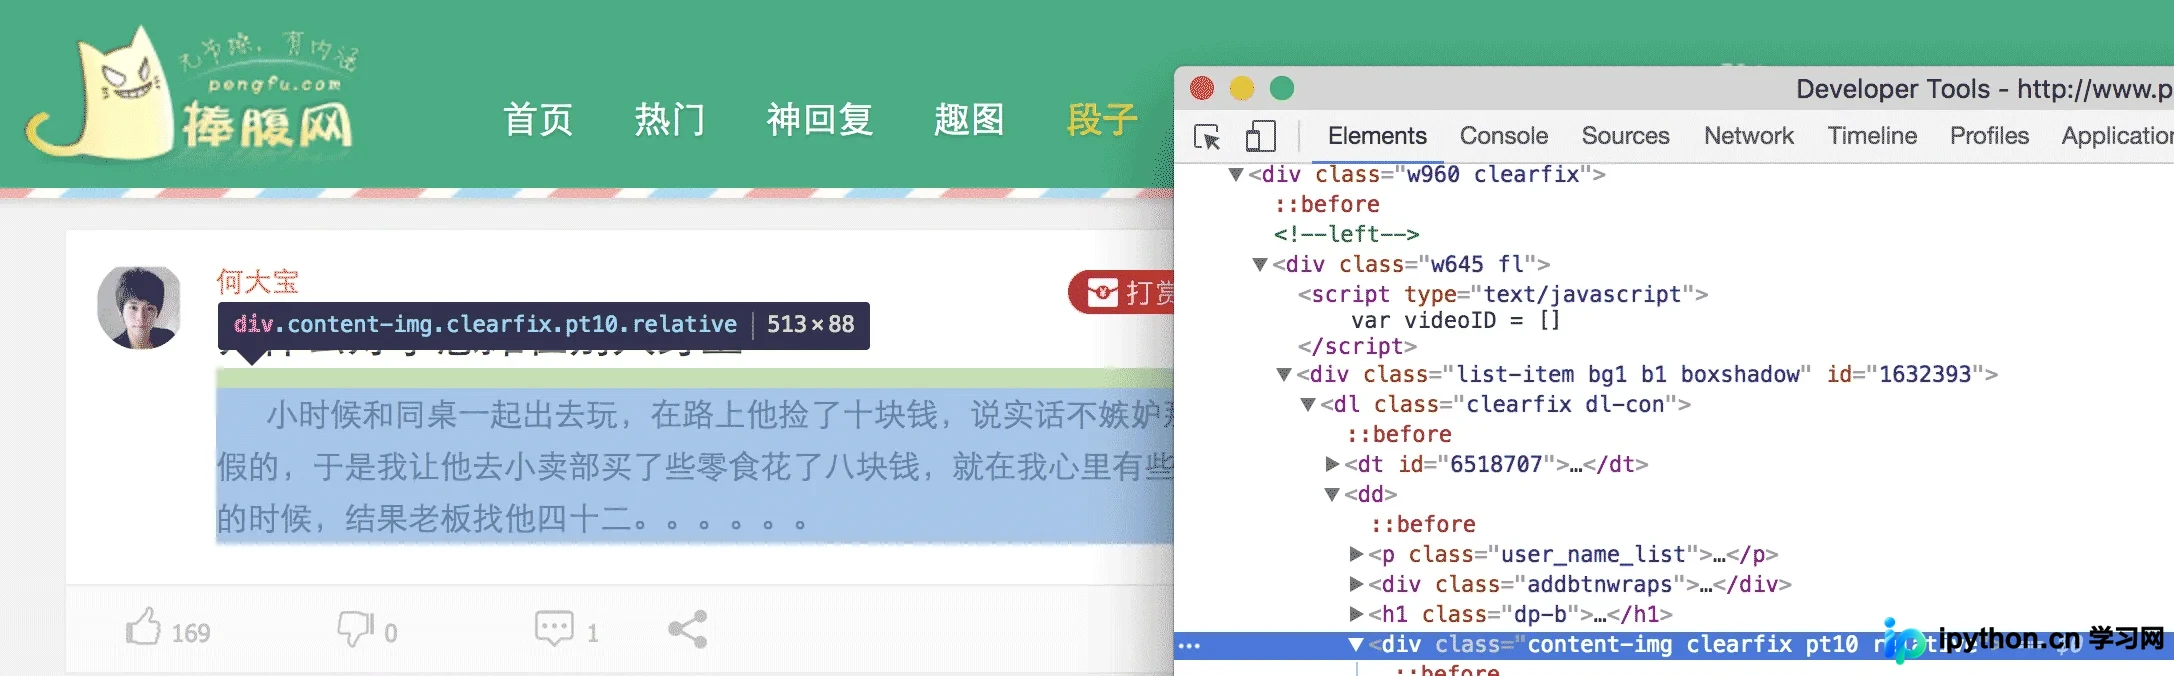
经过分析发现,笑话内容主要包含在特定的<div>标签中。观察第二条笑话,其结构与此相同。因此,我们可以通过查找网页中所有的<div>标签,并提取其中的内容,即可完成数据抓取。
Python3实现网页抓取与解析
0x03
明确目标后,即可开始编码。这里使用Python3进行开发,虽然Python2也能实现类似功能,但建议优先使用Python3,两者在部分库的使用上略有差异。为了获取网页内容,我们需要使用urllib库。该库提供了获取整个网页的方法。首先,导入urllib.request模块。
代码如下:
import urllib.request as request
随后,我们可以使用request模块来获取网页内容。
代码如下:
def getHTML(url):
return request.urlopen(url).read()
Python以简洁著称,仅用一行代码即可下载网页,这体现了Python的优势。下载网页后,接下来需要解析网页以提取所需元素。为此,我们引入BeautifulSoup库,它能快速解析HTML和XML文档,并提取目标元素。
代码如下:
soup = BeautifulSoup(getHTML("http://www.pengfu.com/xiaohua_1.html"))
使用BeautifulSoup解析网页仅需一行代码,但在运行时会收到警告,提示未指定解析器,这可能导致在不同平台或虚拟环境中行为不一致。
代码如下:
/Library/Frameworks/Python.framework/Versions/3.5/lib/python3.5/site-packages/bs4/__init__.py:181: UserWarning: No parser was explicitly specified, so I'm using the best available HTML parser for this system ("lxml"). This usually isn't a problem, but if you run this code on another system, or in a different virtual environment, it may use a different parser and behave differently.
The code that caused this warning is on line 64 of the file joke.py. To get rid of this warning, change code that looks like this:
BeautifulSoup([your markup])
to this:
BeautifulSoup([your markup], "lxml")
markup_type=markup_type))
关于解析器的种类及区别,官方文档有详细说明。目前来看,使用lxml解析器较为稳妥。修改代码后。
代码如下:
soup = BeautifulSoup(getHTML("http://www.pengfu.com/xiaohua_1.html", 'lxml'))
这样即可消除上述警告。
代码如下:
div_array = soup.find_all('div', {'class':"content-img clearfix pt10 relative"})
利用find_all函数,查找所有class属性为content-img clearfix pt10 relative的div标签,然后遍历该数组。
代码如下:
for x in div_array: content = x.string
处理User-Agent被拒问题
通过上述步骤,我们成功提取了目标div的内容,从而获取了笑话数据。然而,当尝试以相同方式抓取糗百时,会遇到如下错误。
代码如下:
raise RemoteDisconnected("Remote end closed connection without" http.client.RemoteDisconnected: Remote end closed connection without response
错误提示远端关闭连接且无响应。检查网络状态正常,且使用Charles抓包也未见异常。为何浏览器可正常访问而Python脚本失败?怀疑是User-Agent(UA)被服务器识别并拒绝。通过Charles观察,urllib默认UA为Python-urllib/3.5,而Chrome的UA为User-Agent:Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_3) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36。服务器可能根据UA拒绝Python请求。尝试伪装UA后测试。
代码如下:
def getHTML(url):
headers = {'User-Agent': 'User-Agent:Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_3) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36'}
req = request.Request(url, headers=headers)
return request.urlopen(req).read()
通过上述代码,将Python请求伪装为Chrome浏览器,从而成功获取糗百网页数据。
至此,利用Python抓取糗百和捧腹网笑话的流程结束。只需分析目标网页结构,定位感兴趣元素,利用Python的强大功能即可实现抓取。无论是图片还是段子,均可通过类似方法处理。
# -*- coding: utf-8 -*-
import sys
import urllib.request as request
from bs4 import BeautifulSoup

def getHTML(url):
  headers = {'User-Agent': 'User-Agent:Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_3) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36'}
  req = request.Request(url, headers=headers)
  return request.urlopen(req).read()

def get_pengfu_results(url):
  soup = BeautifulSoup(getHTML(url), 'lxml')
  return soup.find_all('div', {'class':"content-img clearfix pt10 relative"})

def get_pengfu_joke():
  for x in range(1, 2):
    url = 'http://www.pengfu.com/xiaohua_%d.html' % x
    for x in get_pengfu_results(url):
      content = x.string
      try:
        string = content.lstrip()
        print(string + '\n\n')
      except:
        continue
  return

def get_qiubai_results(url):
  soup = BeautifulSoup(getHTML(url), 'lxml')
  contents = soup.find_all('div', {'class':'content'})
  restlus = []
  for x in contents:
    str = x.find('span').getText('\n','<br/>')
    restlus.append(str)
  return restlus

def get_qiubai_joke():
  for x in range(1, 2):
    url = 'http://www.qiushibaike.com/8hr/page/%d/?s=4952526' % x
    for x in get_qiubai_results(url):
      print(x + '\n\n')
  return

if __name__ == '__main__':
  get_pengfu_joke()
get_qiubai_joke()本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















