


Python结巴分词实战:中文文本分词与词性标注完整示例

发布时间:2026-10-13 |
2人浏览过
本文详细介绍Python中使用结巴分词库进行中文文本分词及词性标注的完整流程。通过读取文本文件、调用pseg.cut进行分词,并将结果保存至新文件。针对Python 2.7环境下常见的编码报错问题,提供了添加sys.setdefaultencoding("utf-8")的解决方案,附带完整代码示例及运行结果分析,帮助开发者快速掌握该工具的实际应用。
本文通过具体实例,详细解析Python中文分词工具“结巴分词”的实际应用方法,旨在为读者提供具有参考价值的技术分享。
关于结巴分词的安装及基础用法,此前文章《Python结巴中文分词工具使用过程中遇到的问题及解决方法》已作说明。本文重点聚焦于更贴近实际开发的场景:从文本文件中读取中文内容,并利用结巴分词工具完成分词操作及词性标注任务。
具体实现示例代码如下:
#coding=utf-8
import jieba
import jieba.posseg as pseg
import time
t1=time.time()
f=open("t_with_splitter.txt","r") #读取文本
string=f.read().decode("utf-8")
words = pseg.cut(string) #进行分词
result="" #记录最终结果的变量
for w in words:
   result+= str(w.word)+"/"+str(w.flag) #加词性标注
f=open("t_with_POS_tag.txt","w") #将结果保存到另一个文档中
f.write(result)
f.close()
t2=time.time()
print("分词及词性标注完成,耗时:"+str(t2-t1)+"秒。") #反馈结果
其中,输入文件t_with_splitter.txt的内容如下所示:
本站是国内专业的网站建设资源、脚本编程学习类网站,提供asp、php、asp.net、javascript、jquery、vbscript、dos批处理、网页制作、网络编程、网站建设等编程资料。
在Python 2.7.9平台上运行上述代码时,会触发如图所示的错误提示:
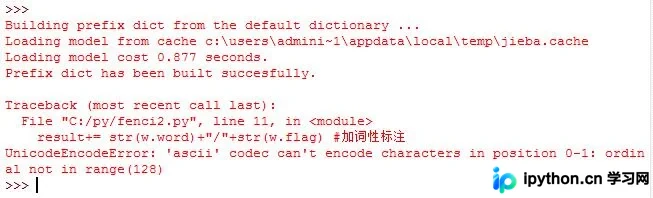
经查阅相关资料发现,需在代码开头部分添加特定的编码设置语句:
import sys
reload(sys)
sys.setdefaultencoding( "utf-8" )
修正后的完整代码如下:
#coding=utf-8
import jieba
import jieba.posseg as pseg
import time
import sys
reload(sys)
sys.setdefaultencoding( "utf-8" )
t1=time.time()
f=open("t_with_splitter.txt","r") #读取文本
string=f.read().decode("utf-8")
words = pseg.cut(string) #进行分词
result="" #记录最终结果的变量
for w in words:
   result+= str(w.word)+"/"+str(w.flag) #加词性标注
f=open("t_with_POS_tag.txt","w") #将结果保存到另一个文档中
f.write(result)
f.close()
t2=time.time()
print("分词及词性标注完成,耗时:"+str(t2-t1)+"秒。") #反馈结果
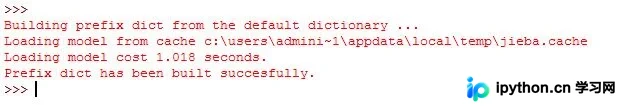
代码运行成功,具体结果如下:
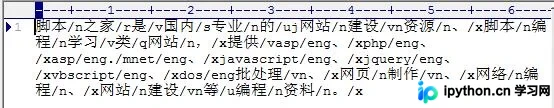
使用Editplus打开生成的t_with_POS_tag.txt文件,显示效果如下图所示:
如需了解更多Python相关知识,建议查阅本站系列专题:《Python字典操作技巧汇总》、《Python字符串操作技巧汇总》、《Python常用遍历技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》以及《Python入门与进阶经典教程》。
希望本文所述内容能对广大Python程序设计人员有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















