


Java与Python正则表达式实战指南:语法、常用模式及re模块详解

本文详细解析Java与Python中正则表达式的核心语法,涵盖元字符、转义处理及常用匹配模式(如邮箱、身份证、强密码验证)。重点介绍Python re模块的compile、search、match、findall等方法,深入讲解match对象的使用及子模式扩展语法,通过代码示例展示高级匹配技巧,帮助开发者高效处理复杂字符串任务。
正则表达式基础与元字符详解
正则表达式语法及常用元字符概述
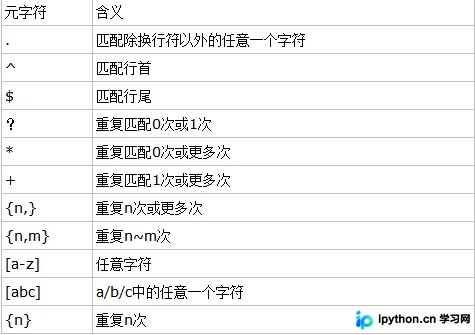
正则表达式由元字符及其各种组合构成,通过精心设计的表达式结构,可以精准匹配任意字符串,从而完成复杂的字符串处理需求。
掌握常用的元字符是构建正则表达式的基础,这些元字符定义了匹配的规则和范围。
在使用反斜杠进行转义时需特别注意:当以反斜杠开头的元字符与字符串中的转义字符冲突时,建议使用双反斜杠'\\'或在字符串前添加'r'或'R'前缀以创建原始字符串。原始字符串能简化输入,特别适用于正则表达式和文件路径;若字符串以反斜杠结尾,则需额外添加一个反斜杠以确保正确解析。
反斜杠'\'的作用是将下一个字符标记为特殊字符、原义字符、向后引用或八进制转义符。例如,'n'直接匹配字符"n",而'\n'匹配换行符;序列'\\'匹配反斜杠本身"\",而"\("则匹配左括号"("。
常用正则表达式模式示例
以下是正则表达式中几种常见的写法示例,展示了不同场景下的匹配规则。
常见正则表达式模式包括: '[a-zA-Z0-9]':匹配任意字母或数字。 '[^abc]':匹配除a、b、c之外的任意字符。 'p(ython|erl)':匹配"Python"或"perl"。 '(pattern)*':匹配前一个模式0次或多次。 '(pattern)+':匹配前一个模式1次或多次。 '(pattern){m,n}':匹配前一个模式m到n次。 '(a|b)*c':匹配0到n次a或b后紧跟c的情况。 '^[a-zA-Z]{1}([a-zA-Z0-9\._]){4,19}$':匹配以字母开头、总长20个字符的字符串。 '^(\w){6,20}$':匹配长度为6至20个单词字符的字符串。 '^\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3}$':匹配IPv4地址格式。 '^[a-zA-Z]+$':检查字符串是否仅包含英文字母。 '\w+@(\w+\.)\w+$':匹配常见的电子邮件地址格式。 '[\u4e00-\u9fa5]':匹配中文字符。 '^\d{18}|\d{15}$':匹配18位或15位的身份证号码(注:原文此处括号闭合可能有误,通常应为^\d{18}|^\d{15}$或类似结构,此处按原文保留逻辑)。 '\d{4}-\d{1,2}-\d{1,2}':匹配YYYY-MM-DD格式的时间。 '^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[,._]).{8,}$)':判断字符串是否为包含小写、大写、数字及特定符号且长度至少8位的强密码(注:原文此处右括号位置可能有误,通常应为^{...}形式,此处按原文保留)。 '(.)\1+':匹配任意字符的一次或多次连续出现。
Python re模块核心方法解析
在Python中,re模块提供了处理正则表达式的核心方法,掌握这些方法是进行字符串操作的关键。
re模块常用方法包括: compile(pattern[,flags]):编译正则表达式,创建模式对象以提高重复使用效率。 search(pattern,string[,flags]):在整个字符串中搜索第一个匹配模式的位置,返回match对象或None。 match(pattern,string[,flags]):从字符串的起始位置尝试匹配模式,若成功返回匹配对象。 findall(pattern,string[,flags]):查找字符串中所有符合模式的子串,并以列表形式返回。 split(pattern,string[,maxsplit=0]):根据匹配的模式分割字符串,可选最大分割次数。 sub(pat,repl,string[,count=0]):将字符串中所有匹配pat的部分替换为repl,可选替换次数。 escape(string):转义字符串中所有具有特殊含义的正则表达式字符。
match、search与findall的区别
理解match、search和findall三者的区别对于正确使用正则表达式至关重要,它们适用于不同的搜索场景。
match方法仅在字符串开头或指定的起始位置进行搜索,要求模式必须出现在该位置;search方法则在整个字符串或指定范围内搜索第一个匹配项;findall方法则查找字符串中所有符合正则表达式的子串,并将结果以列表形式返回。
子模式匹配与Match对象应用
子模式与match对象是处理复杂匹配结果的核心,通过它们可以提取具体的匹配片段。
当使用match或search方法成功匹配后,都会返回一个match对象。该对象提供了多种方法来获取匹配详情:group()用于返回匹配的一个或多个子模式内容;groups()返回包含所有子模式内容的元组;groupdict()返回包含命名子模式内容的字典;start()和end()分别返回子模式内容的起始和结束位置;span()则返回包含起始位置和结束位置前一个位置的元组,方便进行切片操作。
子模式扩展语法代码演示
通过具体的代码演示,可以更深入地验证和理解子模式扩展语法的功能。
>>> import re
>>> m = re.match(r'(\w+) (\w+)','Isaac Newton,physicist')
>>> m.group(0)
'Isaac Newton'
>>> m.group(1)
'Isaac'
>>> m.group(2)
'Newton'
>>> m.group(1,2)
('Isaac', 'Newton')
>>>m=re.match(r'(?P<first_name>\w+)(?P<last_name>\w+)','Malcolm Reynolds')
>>> m.group('first_name')
'Malcolm'
>>> m.group('last_name')
'Reynolds'
>>> m.groups()
('Malcolm', 'Reynolds')
>>> m.groupdict()
{'first_name': 'Malcolm', 'last_name': 'Reynolds'}
以下代码展示了如何使用子模式和前瞻/后顾断言进行精确匹配,验证扩展语法在实际应用中的效果。
>>> import re
>>> exampleString = '''There should be one--and preferably only one--obvious way to do it.
Although that way may not be obvious at first unless you're Dutch.
Now is better than never.
Although never never is often better than right now.'''
>>> pattern = re.compile(r'(?<=\w\s)never(?=\s\w)')
>>> matchResult = pattern.search(exampleString)
>>> matchResult.span()
(171, 176)
>>> pattern = re.compile(r'(?<=\w\s)never')
>>> matchResult = pattern.search(exampleString)
>>> matchResult.span()
(154, 159)
>>> pattern = re.compile(r'(?:is\s)better(\sthan)')
>>> matchResult = pattern.search(exampleString)
>>> matchResult.span()
(139, 153)
>>> matchResult.group(0)
'is better than'
>>> matchResult.group(1)
' than'
>>> pattern = re.compile(r'\b(?i)n\w+\b')
>>> index = 0
>>> while True:
 matchResult = pattern.search(exampleString,index)
 if not matchResult:
 break
 print(matchResult.group(0),':',matchResult.span(0))
 index = matchResult.end(0)

not : (90, 93)
Now : (135, 138)
never : (154, 159)
never : (171, 176)
never : (177, 182)
now : (210, 213)
>>> pattern = re.compile(r'(?<!not\s)be\b')
>>> index = 0
>>> while True:
 matchResult = pattern.search(exampleString,index)
 if not matchResult:
 break
 print(matchResult.group(0),':',matchResult.span(0))
 index = matchResult.end(0)

be : (13, 15)
>>> exampleString[13:20]
'be one-'
>>> pattern = re.compile(r'(\b\w*(?P<f>\w+)(?P=f)\w*\b)')
>>> index = 0
>>> while True:
 matchResult = pattern.search(exampleString,index)
 if not matchResult:
 break
 print(matchResult.group(0),':',matchResult.group(2))
 index = matchResult.end(0)+1

unless : s
better : t
better : t
>>> s = 'aabc abbcd abccd abbcd abcdd'
>>> p = re.compile(r'(\b\w*(?P<f>\w+)(?P=f)\w*\b)')
>>> p.findall(s)
[('aabc', 'a'), ('abbcd', 'b'), ('abccd', 'c'), ('abbcd', 'b'), ('abcdd', 'd')]
以上内容涵盖了Python正则表达式的主要知识点,包括语法、常用模式及re模块的高级用法。如需了解更多相关资料,建议查阅本站往期文章或官方文档。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















