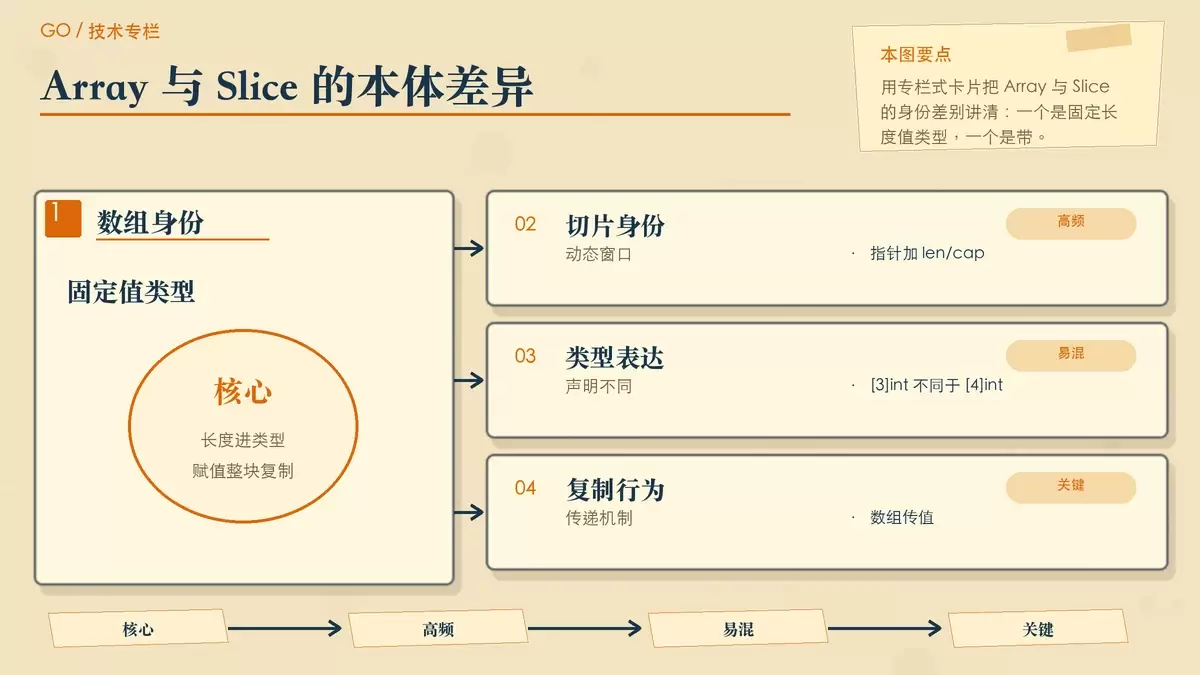
Go 语言 Array 和 Slice 深度解析:核心区别与实战指南
这篇文章围绕 Go 中最容易混淆的两种顺序容器展开:Array 是固定长度值类型,Slice 是基于底层数组的动态视图。文章从定义、传参、扩容、共享内存到常见陷阱逐项拆开,并给出何时选数组、何时直接用切片的实用判断。
08-25
205




这篇文章围绕 Go 中最容易混淆的两种顺序容器展开:Array 是固定长度值类型,Slice 是基于底层数组的动态视图。文章从定义、传参、扩容、共享内存到常见陷阱逐项拆开,并给出何时选数组、何时直接用切片的实用判断。
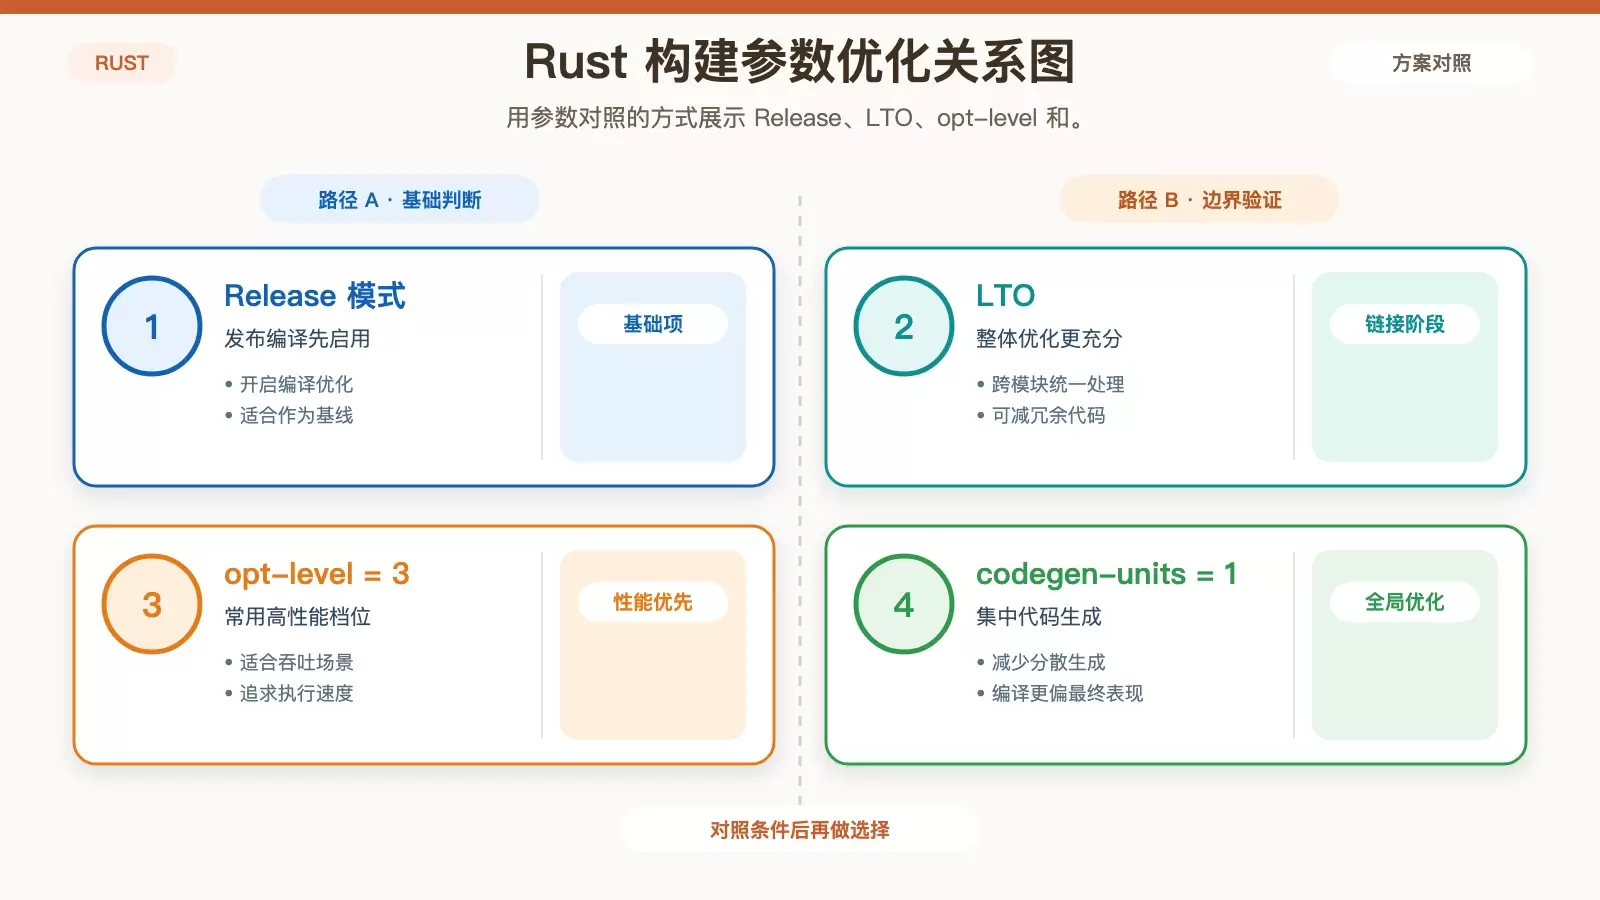
在 Debian 上做 Rust 内存优化,关键不只是“换个库”或“开发布模式”,而是把编译参数、分配器、数据结构、分配次数、并发方式和系统设置串成一条链路。本文按实操顺序梳理这些手段,并给出适用场景与判断依据。
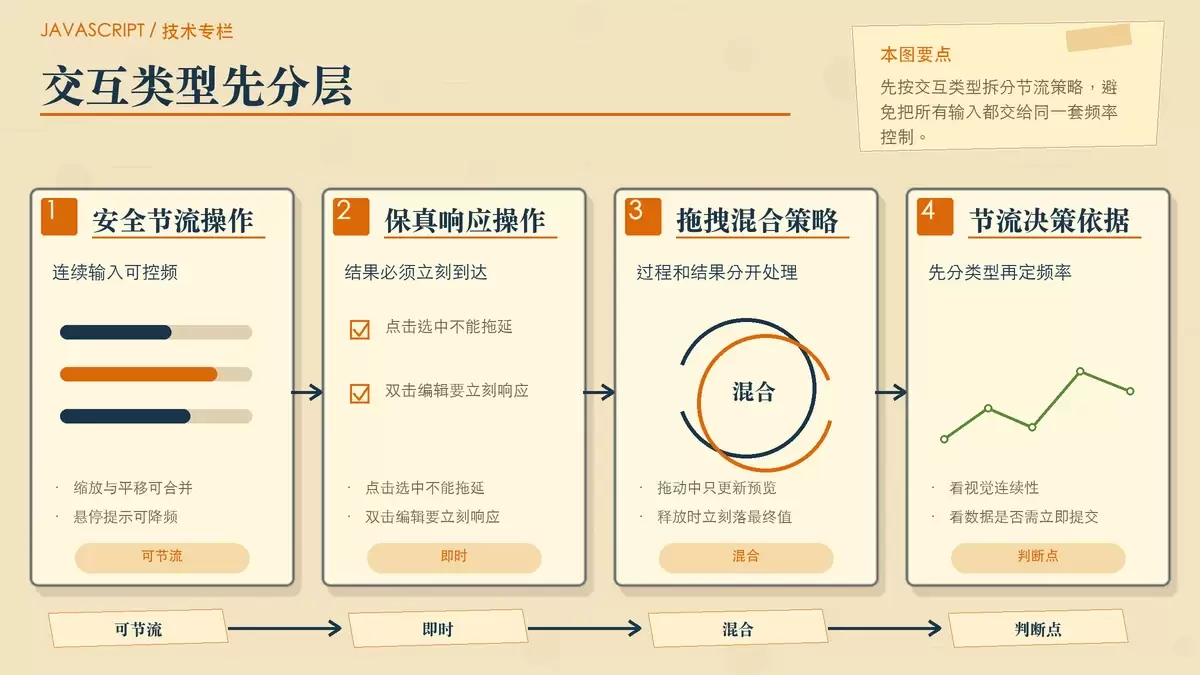
在 Canvas 或 SVG 图表里做实时缩放、拖拽和悬停提示时,节流能降 CPU,但前提不是给所有事件统一套一层 `throttle`。更有效的做法,是把触发与执行拆开,按交互类型和渲染层分别控频,再配合局部重绘、状态缓存和性能面板定位真正瓶颈。
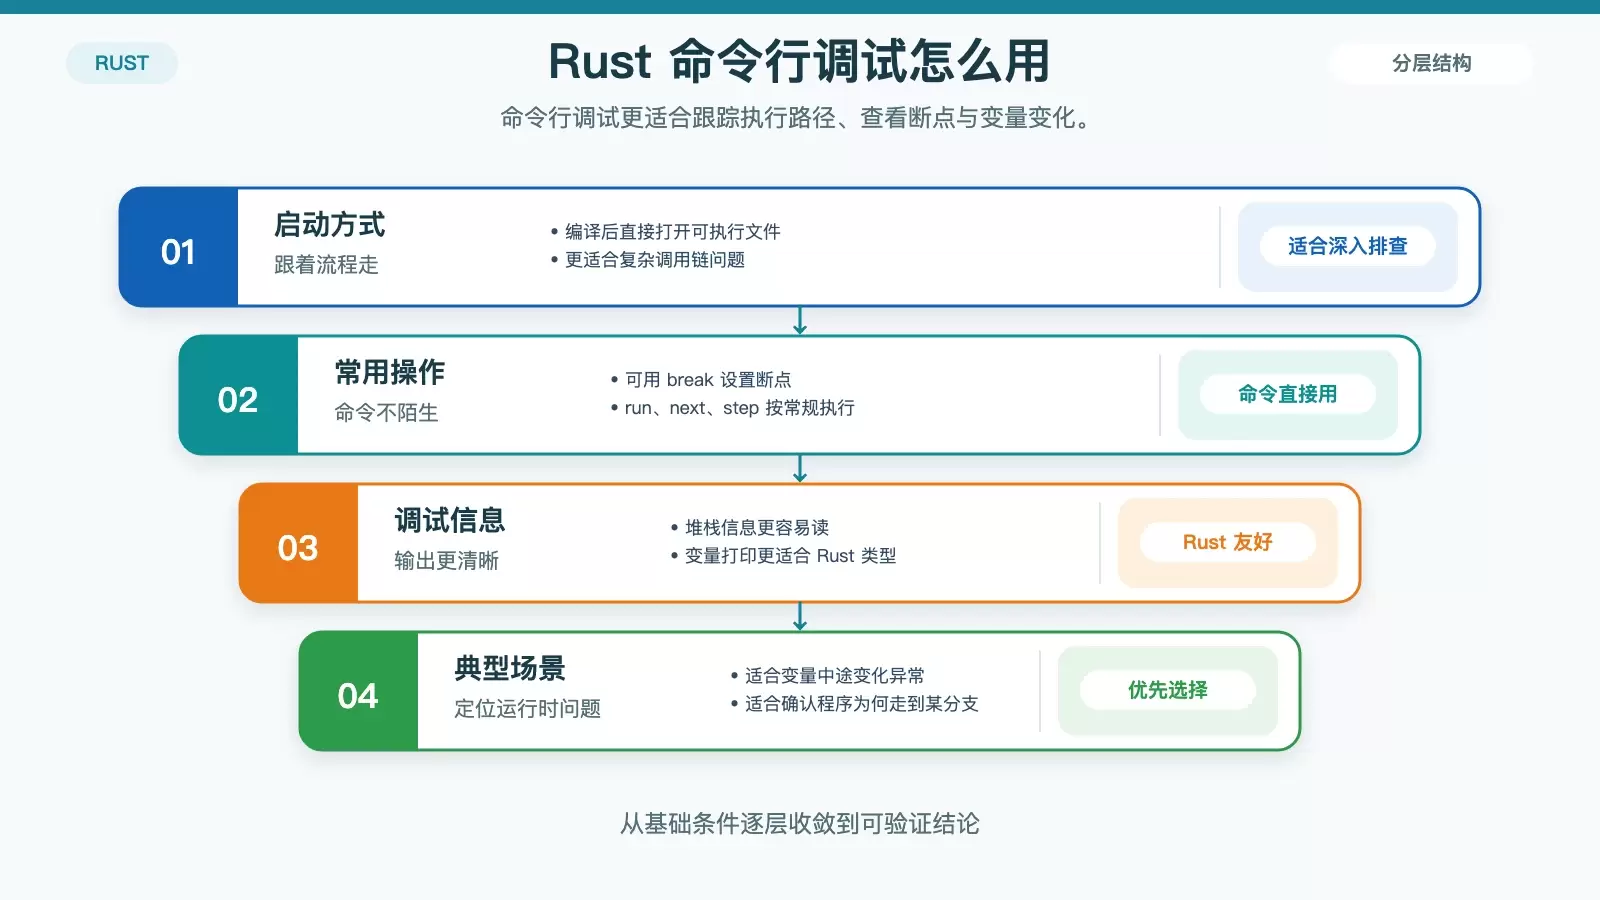
在 CentOS 上调试 Rust,并不只有单一步骤。本文按问题类型梳理命令行调试、IDE 断点、打印排查,以及内存和性能分析几条常用路径,保留关键命令与工具名称,帮助你判断不同场景下该优先用哪一种方法。
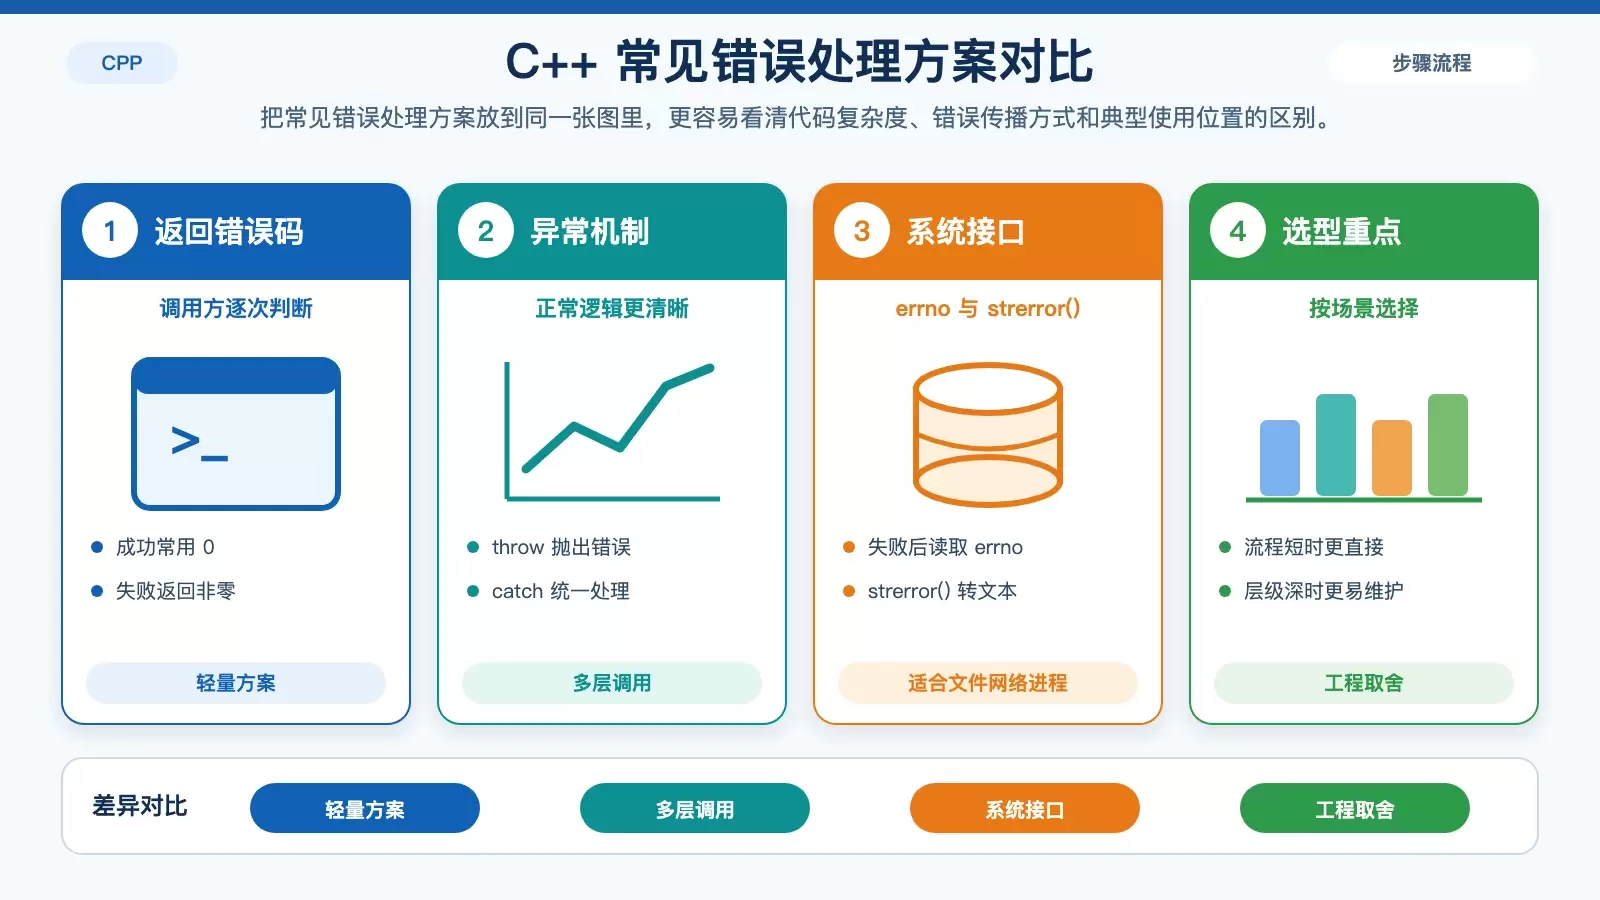
在 Linux 上写 C++ 程序时,错误处理通常集中在返回错误码、异常机制、`errno` 以及更现代的错误码封装几条路线上。它们看起来都能“报错”,但适用场景、可维护性和与系统接口的配合方式并不一样,选错了往往会让调试和扩展变得很麻烦。
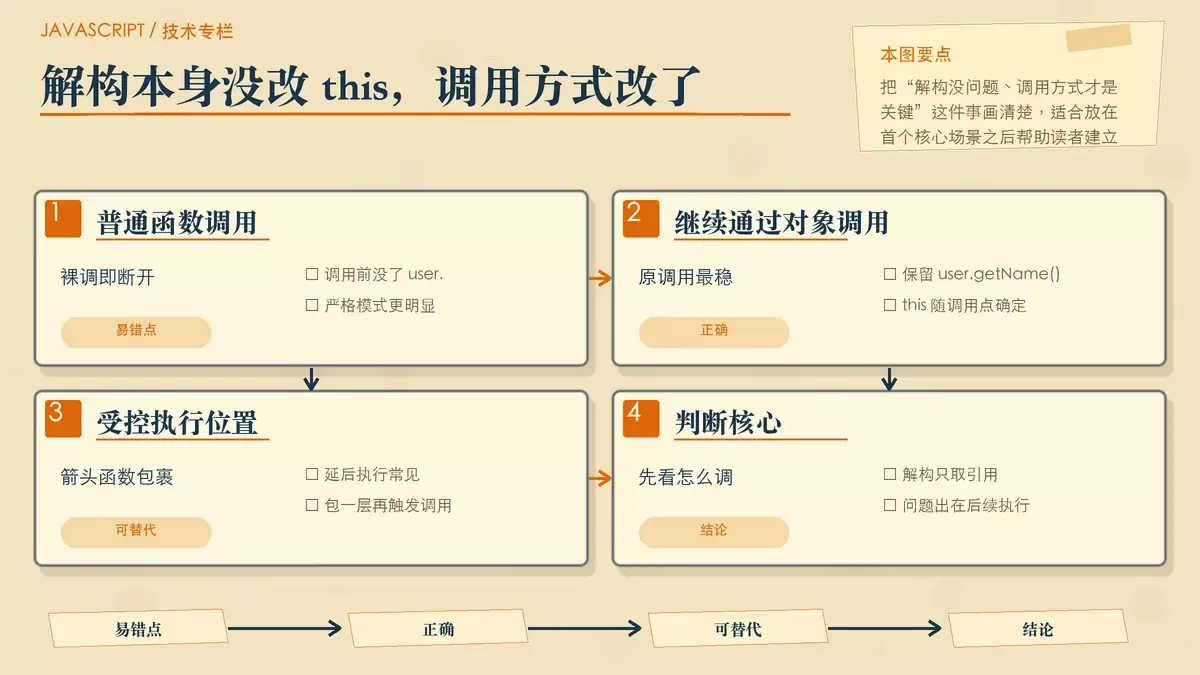
对象方法做解构赋值时,真正让 `this` 出问题的不是“解构”这一步,而是后续把方法当普通函数、回调或事件处理器来调用。本文按常见场景拆开说明 `this` 为什么会丢失,以及什么时候该保留对象调用、什么时候该用 `bind` 或箭头函数兜住上下文。
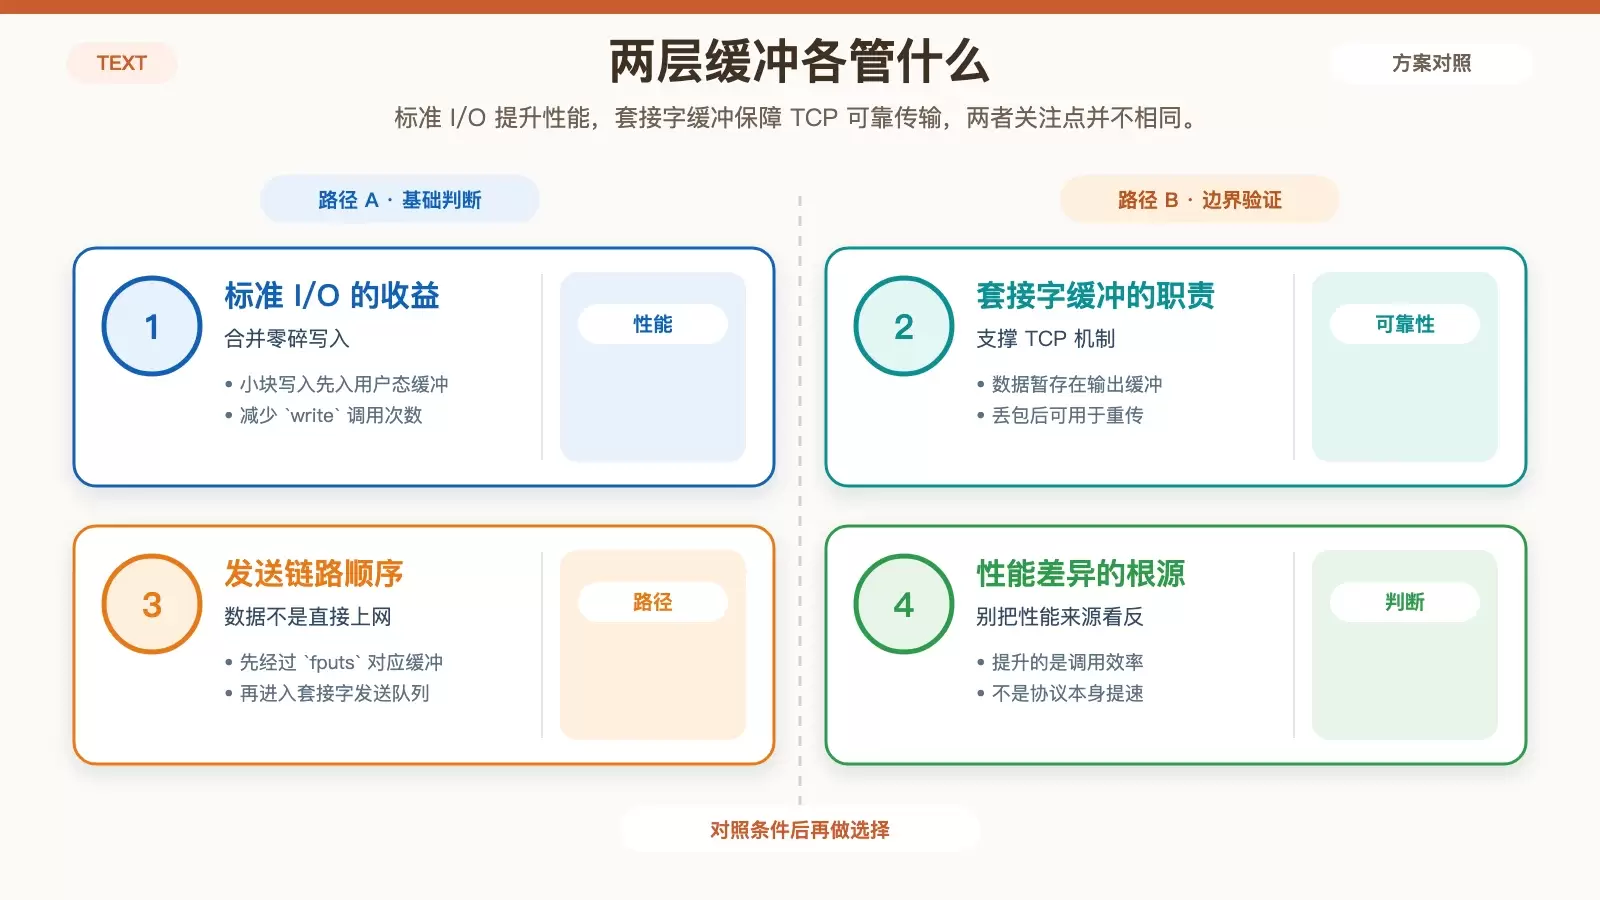
这篇文章围绕“套接字为什么还能配合标准 I/O 使用”展开,梳理标准 I/O 的性能收益、缓冲机制与局限,并结合 `fdopen`、`fileno` 以及回声客户端/服务端示例,说明它在网络编程中的适用场景和常见注意点。
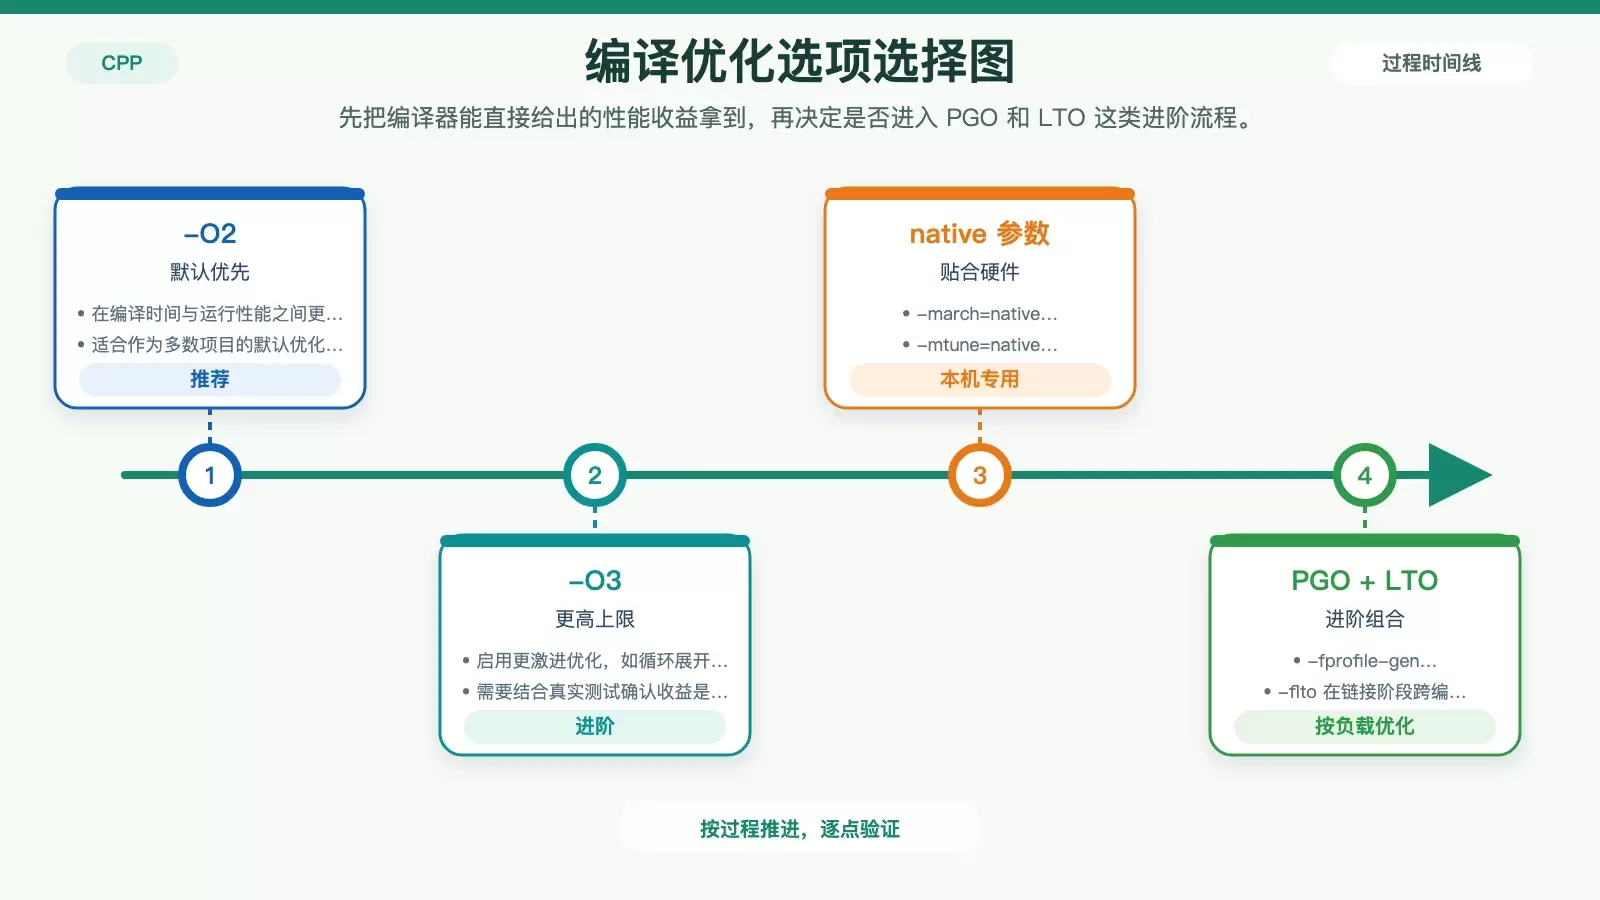
在 CentOS 上做 C++ 性能调优,先别急着改业务逻辑。更高效的做法,是按“编译选项、代码路径、系统参数、分析工具、硬件与库”这条链路逐层排查,用最小改动找到最有收益的优化点。 很多人在 CentOS 上做 C++ 性能优化,第一反应是重写热点代码,但实际更常见的情况是:编译参数没开全、容器和内存策略没选对,系统默认配。
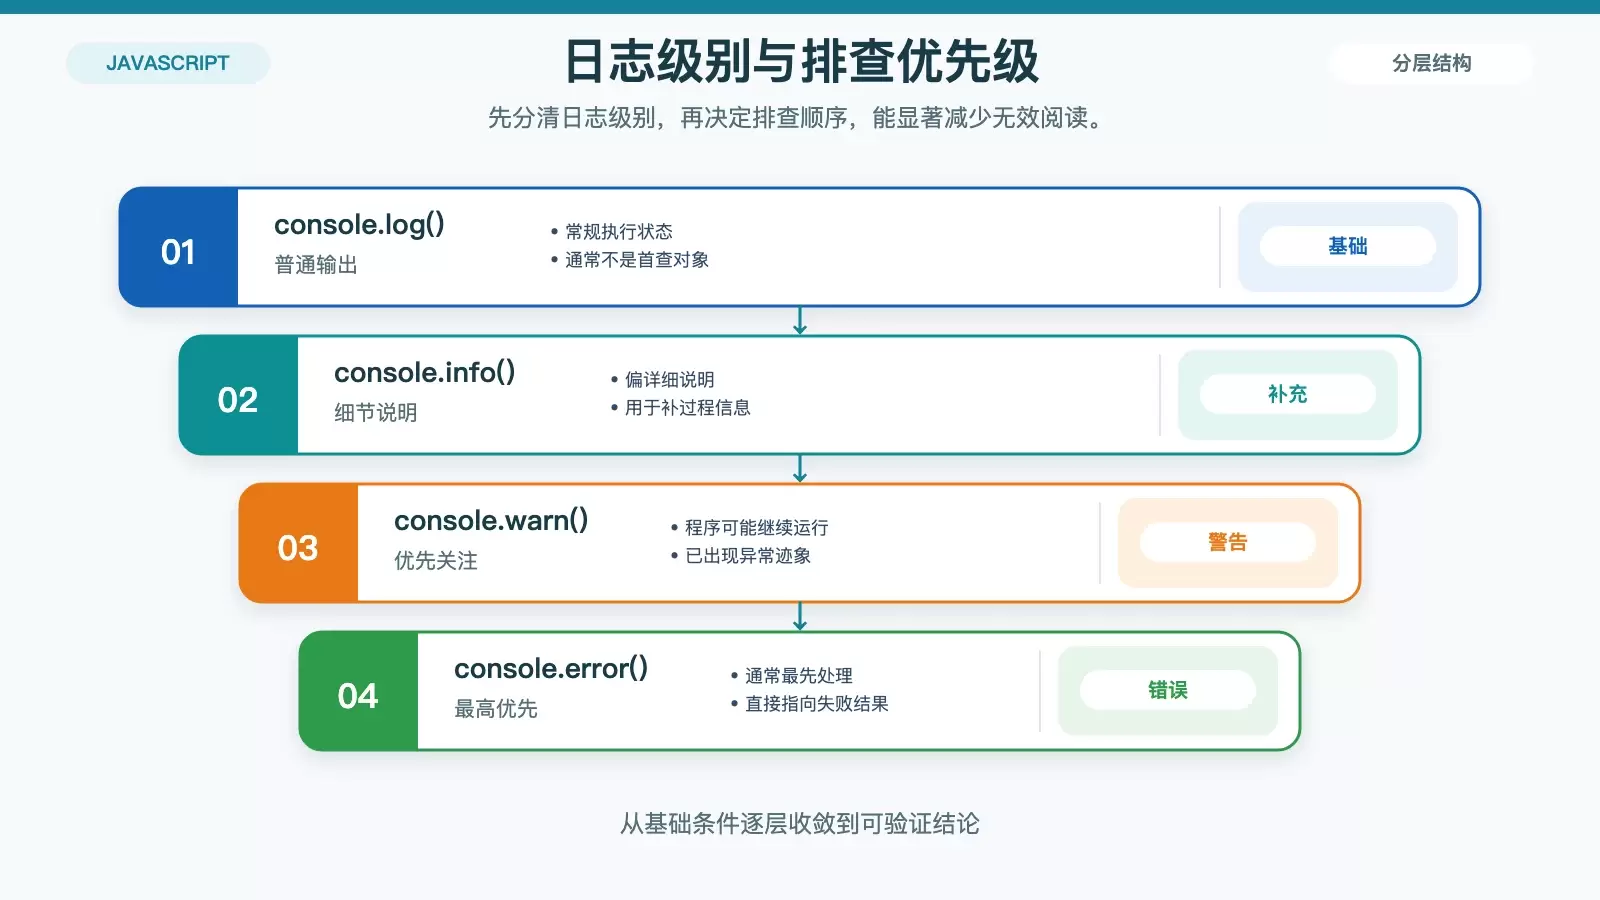
面对 Node.js 应用里层层叠叠的日志输出,关键不是逐字硬读,而是先建立一套筛选顺序。本文把原本分散的九个处理动作整理成一条可执行路径,帮助你从日志级别、来源、堆栈到上下文与工具选择,逐步判断问题位置并进入调试验证。
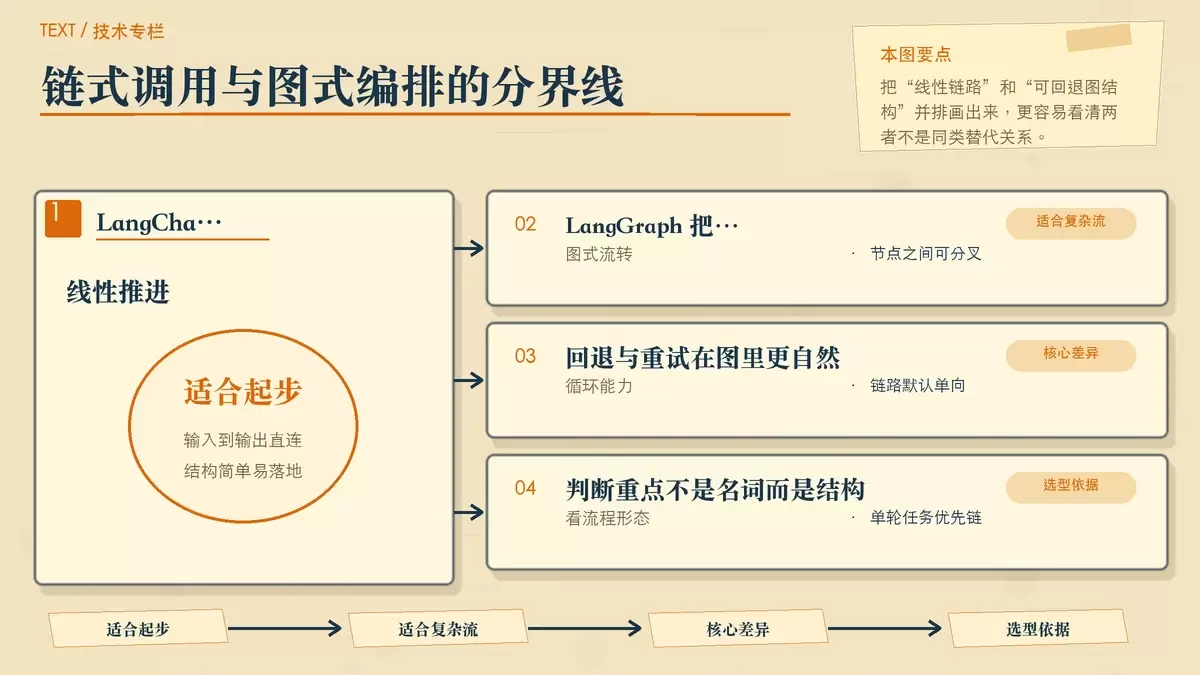
LangChain 和 LangGraph 经常被一起提起,但它们解决的并不是同一类问题。前者偏向快速搭建 LLM 应用,后者更适合处理循环、共享状态和复杂工作流。本文从开发痛点、能力边界和实战场景三部分拆开讲清楚,帮助你判断什么时候该继续用链,什么时候该换成图。
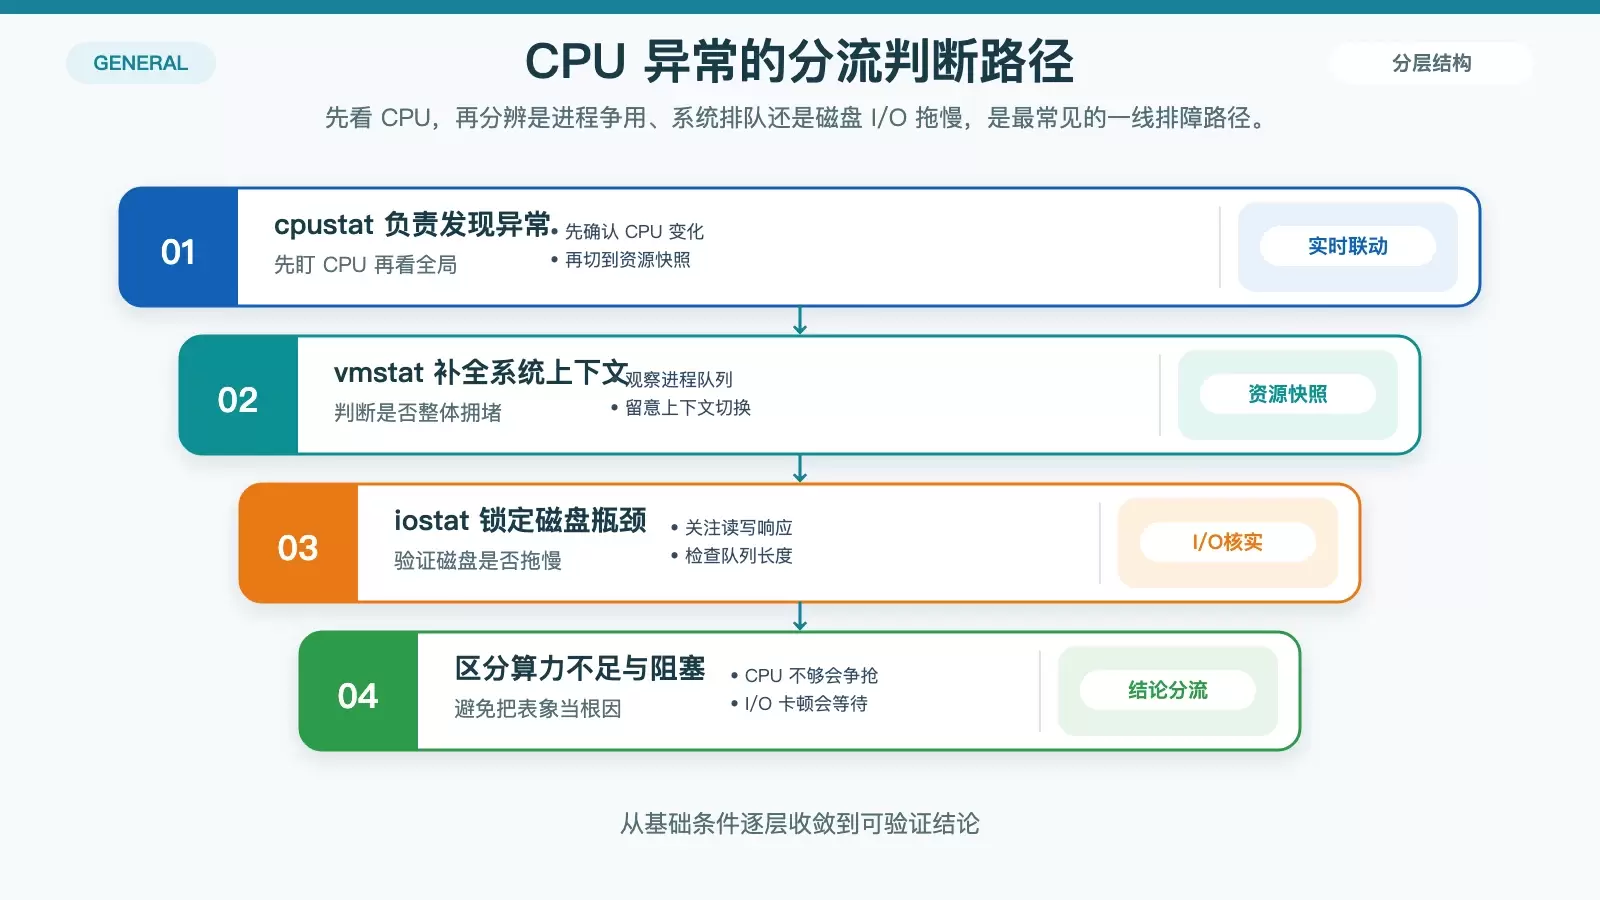
`cpustat` 适合盯住 CPU 变化,但单独使用很难解释性能波动背后的真正原因。把它和 `top`、`vmstat`、`iostat`、`sar`、`perf`、`dstat` 以及日志和脚本结合起来,才能从实时定位、历史回溯到自动采集形成完整的排障链路。 `cpustat` 能快速告诉你 CPU 有没有异常,但它很难单独解释性能问题究竟出在进程、内存调度、磁盘 I/O 还是更底层的调用热点。
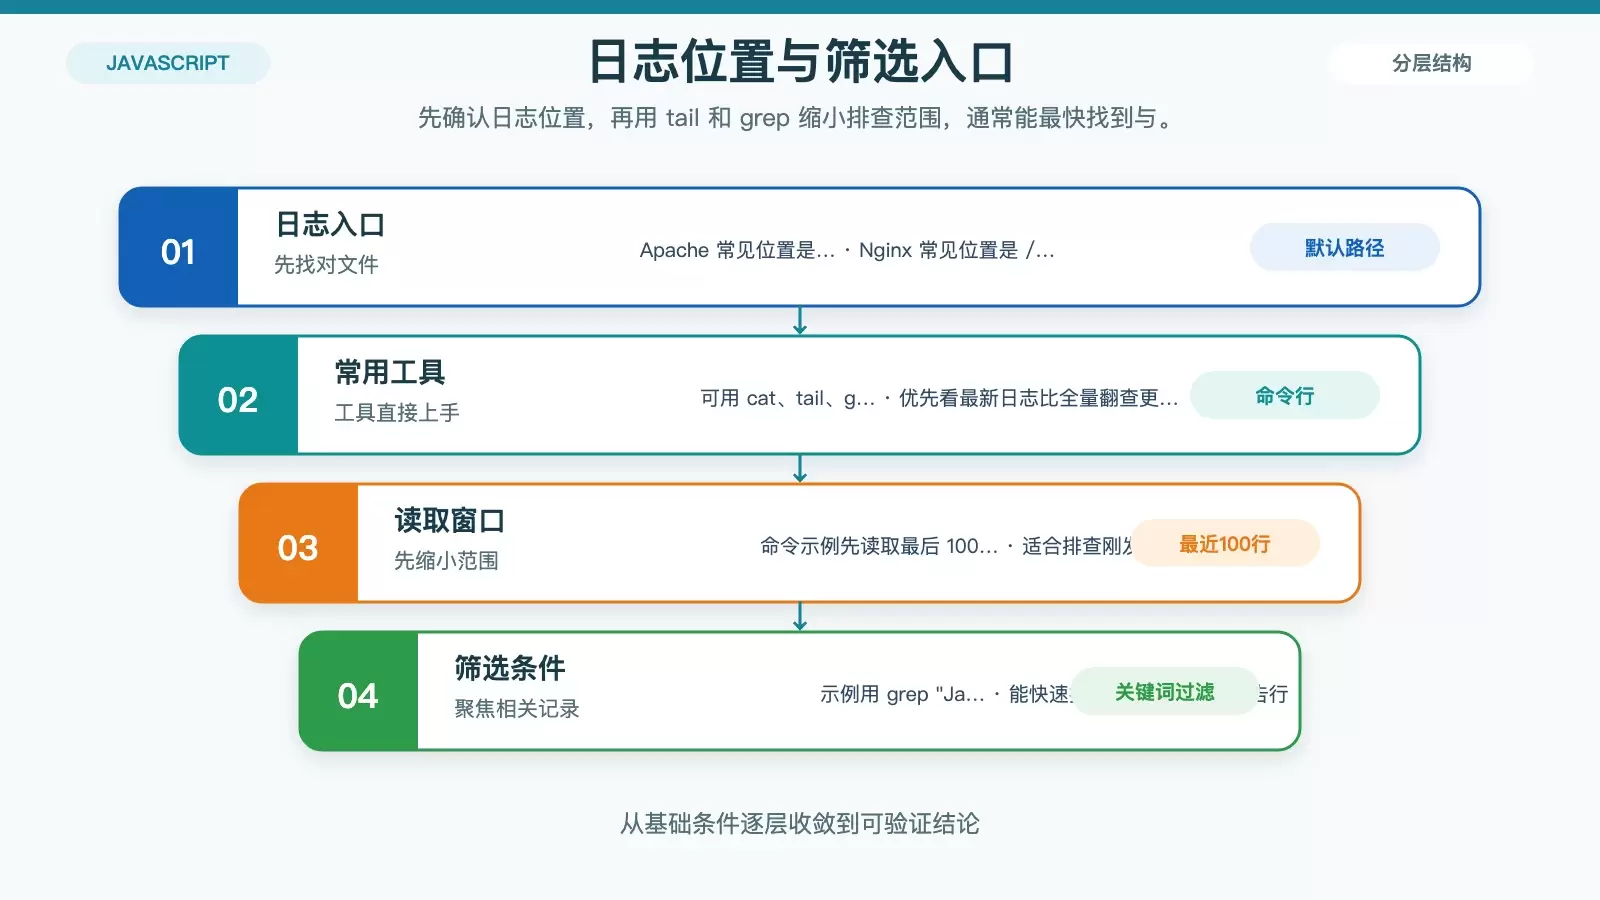
在 Linux 里排查 JavaScript 警告,关键不是盲目翻日志,而是先找对日志文件,再用命令快速筛出相关记录,结合报错里的文件名和行号定位代码。本文按“查找、筛选、分析、修复、验证”的顺序整理出一套可直接上手的处理方法。