


Spacy与Jieba、NLTK的区别:中文NLP工具选型指南
深入对比Spacy、Jieba与NLTK在中文自然语言处理中的算法原理、功能差异、性能表现与工程适用场景,提供清晰的中文NLP技术选型决策方案。
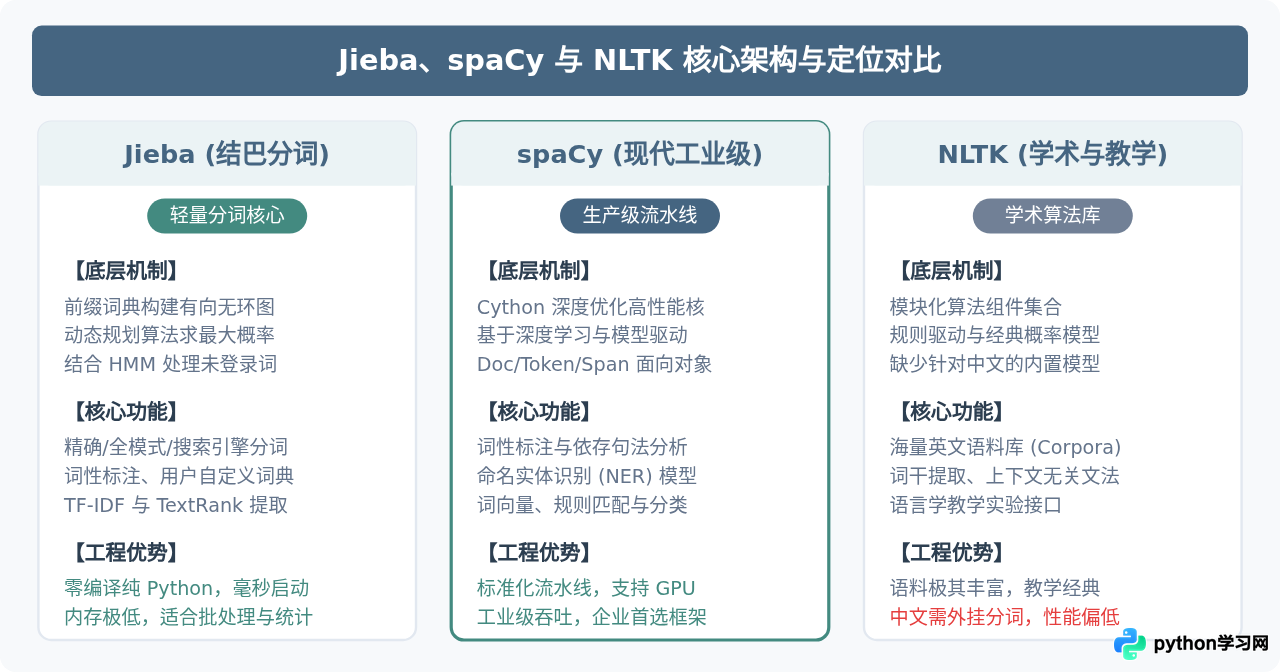
在中文自然语言处理(NLP)技术栈中,Jieba、spaCy 与 NLTK 经常同时出现在开发者的视野中,但三者的设计哲学、底层架构及应用边界存在根本差异。简而言之:Jieba 是开箱即用的轻量级中文分词利器,专攻词法切分与高频词统计;spaCy 是工业级端到端 NLP 处理流水线,长于深度词法、命名实体识别(NER)与依存句法分析;NLTK 则是经典教学与学术研究工具包,拥有强大的英文语料库支持,但在中文原生工程化落地上能力薄弱。掌握这三者的区别,是搭建高效中文文本处理系统的首要前提。
一、工具定位与核心功能横向对照
中文文本不像西欧语言那样具有自然的空格作为词边界,因此中文处理对分词(Word Segmentation)有着刚性依赖。三者在这一环节表现迥异:
| 对比维度 | Jieba (结巴分词) | spaCy | NLTK |
|---|---|---|---|
| 定位与主要受众 | 中文分词专业工具,适合中小型工程与快速文本挖掘 | 工业级生产框架,面向企业级复杂信息抽取与全流程 NLP | 自然语言处理教材标配,面向语言学研究与高校教学 |
| 中文分词支持 | 开箱即用,原生内置大规模中文词典,支持自定义词典 | 通过预训练中文管线(如 zh_core_web_sm)提供高精度切分 |
无原生开箱中文分词能力,默认按空格或字符切分,需外接组件 |
| 句法与实体识别 | 仅支持词性标注与简单关键词抽取,不支持依存句法与复杂 NER | 原生支持完备的命名实体识别(NER)与依存句法树(Dependency Parsing) | 支持英文句法分析与基础分块,缺少直接可用的中文预训练语法树 |
| 执行效率与资源占用 | 极快,内存占用通常在 100MB 以内,毫秒级初始化 | Cython 底层优化,吞吐量高;但加载模型需要较大内存(数百 MB 至数 GB) | 纯 Python 为主,运行速度相对缓慢,处理大规模语料耗时较长 |
| 现代硬件支持 | 仅支持 CPU 运算 | 全面支持 GPU 加速,支持接入 PyTorch / Hugging Face Transformers | 仅 CPU 运算,缺乏现代深度学习硬件优化 |
二、文本处理流水线与处理机制对比
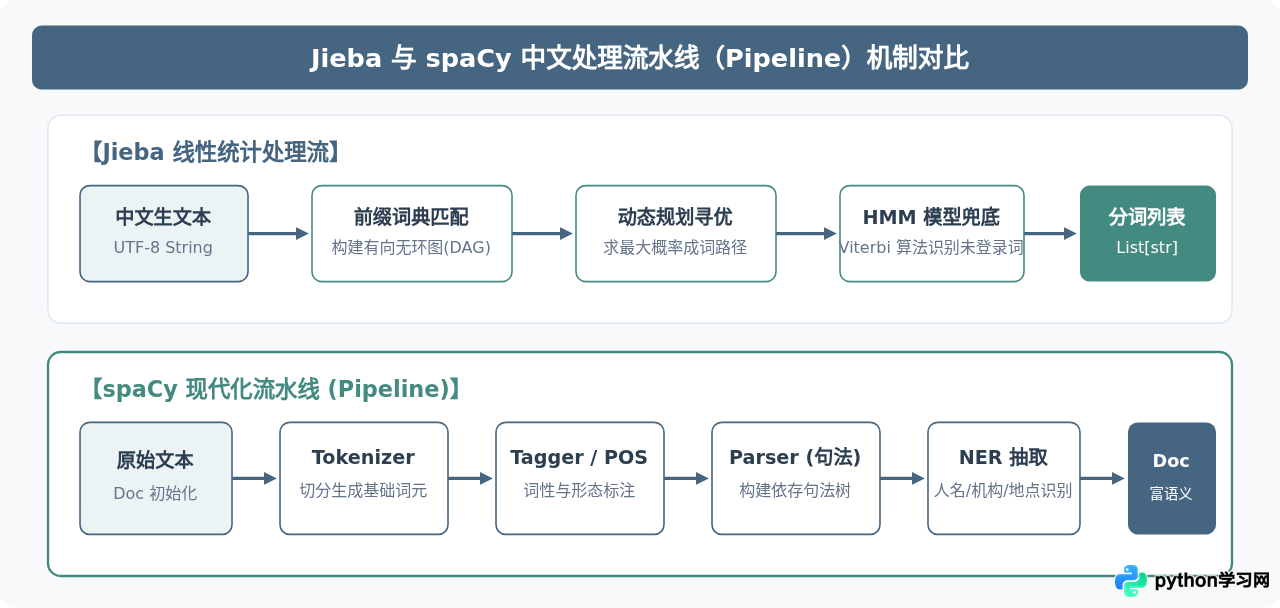
理解这三款工具差异的关键在于它们的处理流水线模式。以处理一段复杂的中文句子为例:Jieba 采取的是直接的“字典 + 统计”式串行模式;而 spaCy 则采用面向对象的流水线模式,将字符串一步解析为包含丰富句法与语义标注的 Doc 容器。
三、代码实现与常见操作对比
通过具体的 Python 代码调用,可以最直观地感受到三者在开发接口和输出结构上的差异。
1. Jieba 分词与关键词提取示例
Jieba 的调用极其简短,无需繁琐的模型加载过程:
import jieba
import jieba.posseg as pseg
import jieba.analyse

text = "华为在深圳发布了最新的开源AI模型框架"

# 1. 基础分词
words = list(jieba.cut(text))
print("精确模式分词结果:", words)
# 输出: ['华为', '在', '深圳', '发布', '了', '最新', '的', '开源', 'AI', '模型', '框架']

# 2. 词性标注
tagged_words = [(w.word, w.flag) for w in pseg.cut(text)]
print("词性标注结果:", tagged_words)
# 输出包含: [('华为', 'nr'), ('在', 'p'), ('深圳', 'ns'), ('发布', 'v'), ...]

# 3. 关键词提取 (基于 TF-IDF 算法)
keywords = jieba.analyse.extract_tags(text, topK=3)
print("核心关键词:", keywords)
# 输出: ['开源', '华为', '深圳']
2. spaCy 中文预训练管线示例
spaCy 需要先下载中文模型(如 python -m spacy download zh_core_web_sm),它返回的是一个高度结构化的 Doc 对象:
import spacy

# 加载中文语言模型
nlp = spacy.load("zh_core_web_sm")

text = "华为在深圳发布了最新的开源AI模型框架"
doc = nlp(text)

# 1. 词元及句法分析 (Token, POS, 依存关系)
print("Token分析:")
for token in doc:
    print(f"{token.text} | 词性: {token.pos_} | 依存关系: {token.dep_} | 父节点: {token.head.text}")

# 2. 命名实体识别 (NER)
print("\n命名实体:")
for ent in doc.ents:
    print(f"实体: {ent.text} -> 类型: {ent.label_}")
# 自动识别: 华为 (ORG), 深圳 (GPE) 等
3. NLTK 的中文处理现状与桥接方式
NLTK 本身缺乏训练好的中文模型。如果在未安装第三方扩展的情况下直接在 NLTK 中调用 word_tokenize,中文会被当成没有分隔符的整串字符或单字切分,失去了词法意义。在实际工程中,开发者通常必须将 Jieba 作为切词后端包装进 NLTK,或者通过挂载外部的 Stanford CoreNLP 接口来实现:
import nltk
import jieba

text = "华为在深圳发布了最新的开源AI模型框架"

# NLTK 自带分词器处理中文(存在明显局限)
# nltk.word_tokenize(text) 会将整句保留或按标点拆碎,无法识别中文词语

# 常见桥接做法:使用 Jieba 切词后喂给 NLTK 进行频数统计与 N-gram 分析
tokens = list(jieba.cut(text))
fdist = nltk.FreqDist(tokens)
bigrams = list(nltk.bigrams(tokens))

print("词频分布:", fdist.most_common(3))
print("2-gram 组合:", bigrams[:3])
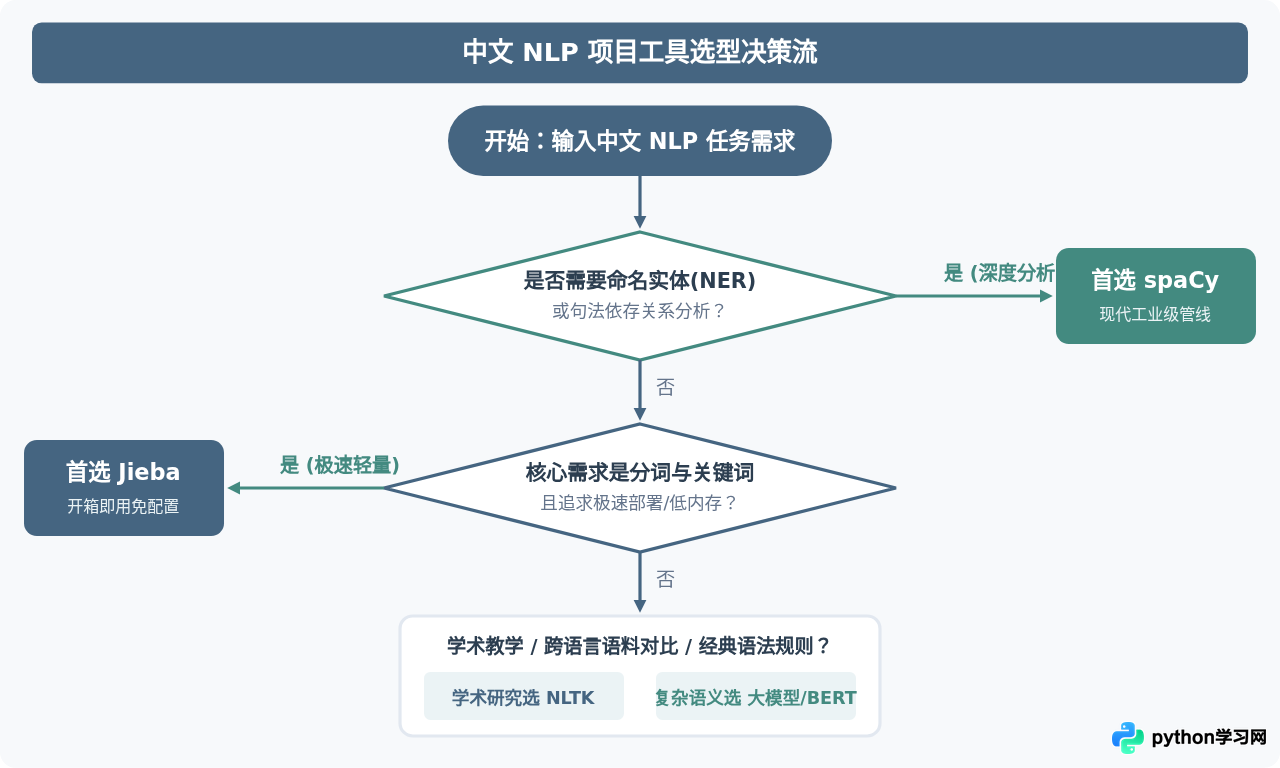
四、中文 NLP 工具选型决策路径
为了在实际技术开发中做出正确取舍,可以根据团队的人力、算力条件以及业务对“语义深度”的要求,按照以下决策路径进行选择:
五、选型陷阱与避坑指南
在实际工程选型中,很多初学者容易因对工具特性的误解而踩坑,以下是三个常见的问题场景与解决方案:
1. 误区一:把 NLTK 作为中文项目的默认预处理库
很多 Python NLP 入门教程沿袭了国外大学的经典教案,将 NLTK 放在第一章。但在处理无空格中文语料时,NLTK 缺乏经过预训练的切分词典,强行调用只会导致分词错误或逐字切割。避坑建议:凡是中文为主的项目,切词阶段应直接选用 Jieba 或 spaCy,仅在需要利用 NLTK 丰富的多国语言词典(如 WordNet)或纯教学场景下使用 NLTK。
2. 误区二:在纯分词场景过度引入 spaCy 大模型
如果业务目标仅仅是对千万级日志进行“词频清洗”或“倒排索引切词”,直接启动 spacy.load("zh_core_web_trf") 或 zh_core_web_sm 会产生不必要的模型加载开销与显存/内存消耗。避坑建议:在日志检索、搜索引擎切词或传统机器学习(TF-IDF + 逻辑回归/SVM)特征提取阶段,Jieba 的吞吐效率更高,且无需维护复杂的深度学习环境依赖。
3. 误区三:忽略 Jieba 的专有名词与新词切分失真
Jieba 默认基于通用语料词典构建,在医疗、法律、半导体等垂直专业领域,常常会将多字专业术语拆分成碎片词汇。避坑建议:在使用 Jieba 时,务必通过 jieba.load_userdict(file_path) 注入垂直领域的领域词典,或者使用 jieba.suggest_freq() 动态修正高频歧义切分。
六、综合维度评估与总结建议
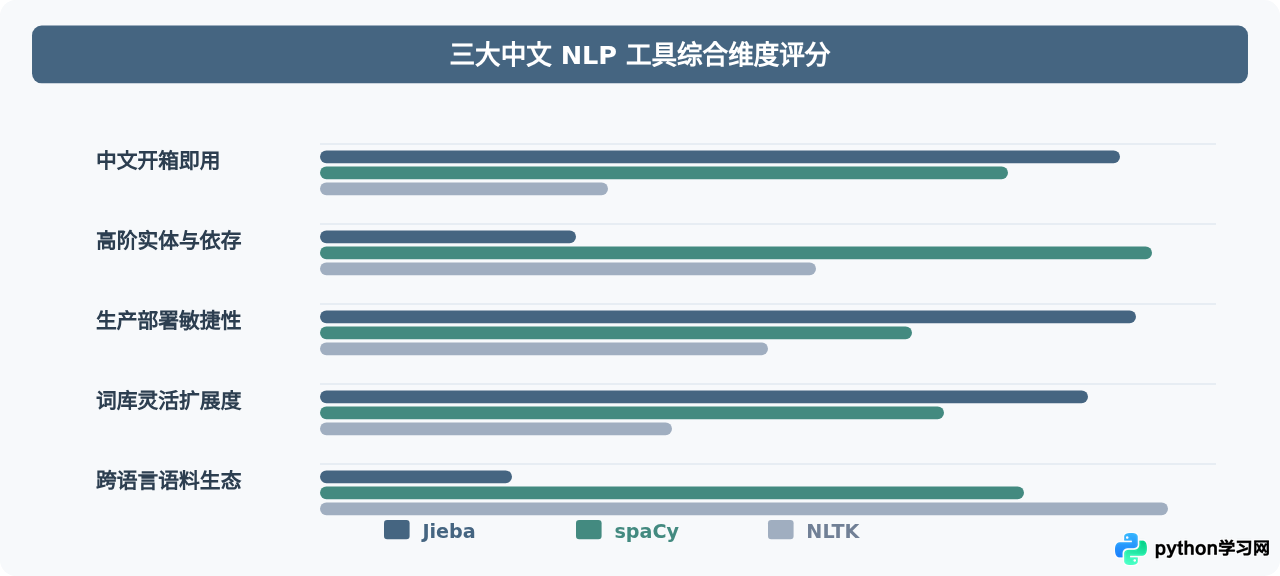
1. 如果你的任务仅限于中文分词、高频词统计、轻量文本特征提取,选择 Jieba 是最高效、成本最低的方案。
2. 如果你需要搭建现代信息抽取流水线、实体识别系统或深入分析句子语法成分,应毫不犹豫地采用 spaCy。
3. 如果你处于高校学习阶段、进行多语种经典 NLP 实验或需要查阅大量语言学语料库,可以选择 NLTK 作为辅助工具,但在中文实际生产部署中不建议单独将其作为主力引擎。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















