


Python中文情感分析怎么做?从SnowNLP到Transformers
系统介绍Python中文情感分析的完整实施方案,对比轻量级统计库SnowNLP与深度学习Transformers架构的原理、代码实现、复杂语义判定与领域微调选型。
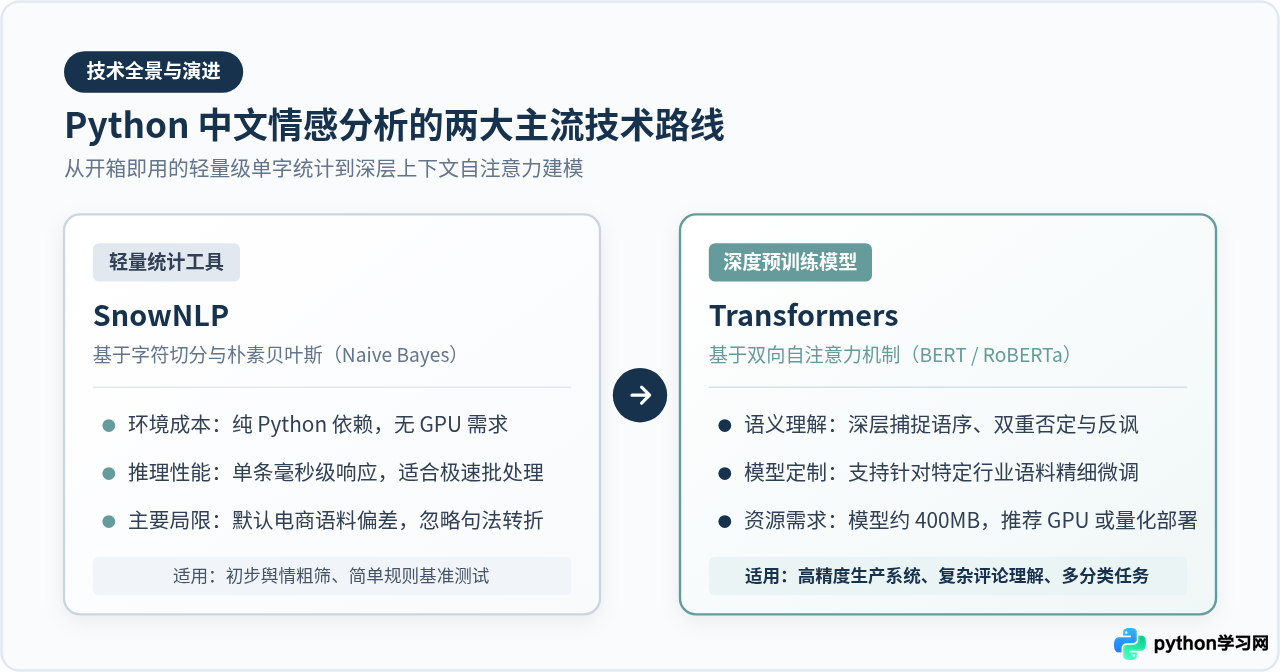
一、轻量级快速起步:使用 SnowNLP 进行情感打分
对于刚接触自然语言处理的开发者,或者算力资源有限、仅需要对大量结构简单文本(如商品评价、简单留言)进行快速分类的场景,SnowNLP 是门槛最低的选择。它是专门面向中文文本设计的工具包,自带分词、词性标注、拼音转换以及情感分析模块。
1. 安装与基础调用
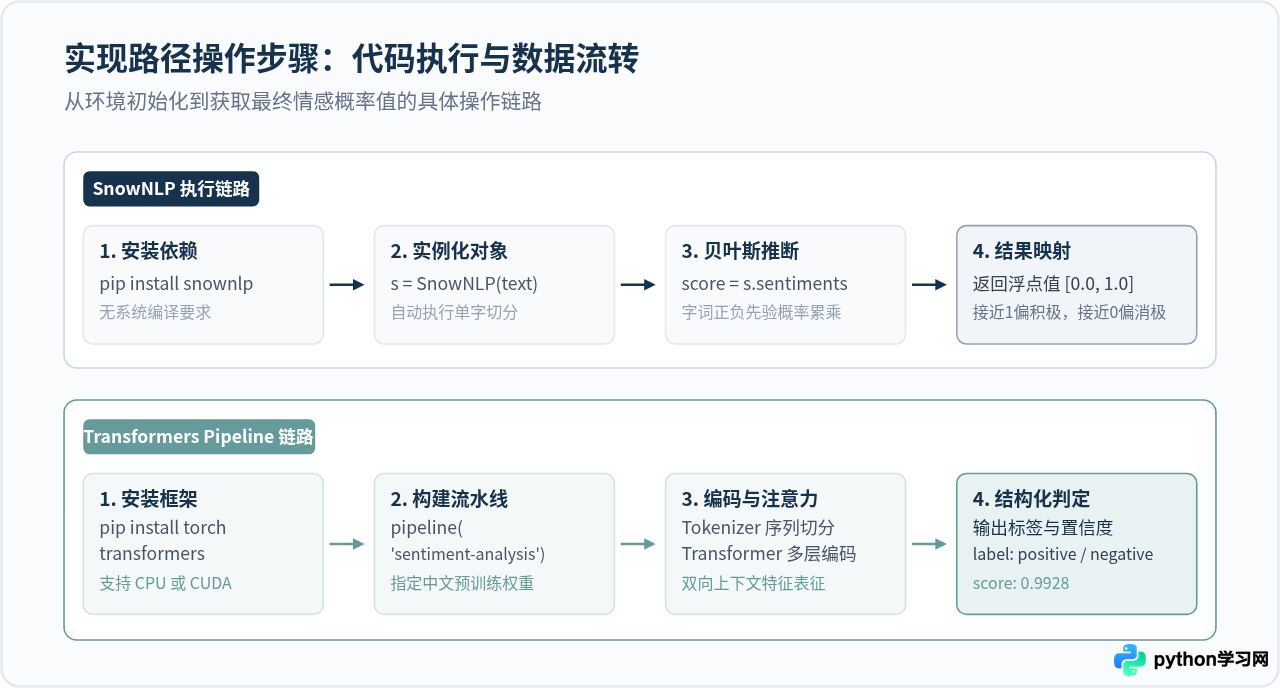
SnowNLP 不依赖大型神经网络框架,纯 Python 编写,安装迅速:
pip install snownlp
完成安装后,直接将中文字符串传入 SnowNLP 构造函数,访问实例的 sentiments 属性即可获取一个处于 0.0 到 1.0 之间的浮点数。数值越接近 1,表示情感越积极正面;数值越接近 0,则表示情感越消极负面:
from snownlp import SnowNLP

texts = [
    "包装非常严实,物流给力,商品质量超出预期,好评!",
    "做工粗糙,刚用一天就开线了,客服态度很差,必须退货!",
    "屏幕外观还可以,电池续航一般,马马虎虎吧。"
]

for text in texts:
    s = SnowNLP(text)
    print(f"文本: {text}")
    print(f"情感得分: {s.sentiments:.4f}\n")
情感得分: 0.9842
文本: 做工粗糙,刚用一天就开线了,客服态度很差,必须退货!
情感得分: 0.0156
文本: 屏幕外观还可以,电池续航一般,马马虎虎吧。
情感得分: 0.4621
2. SnowNLP 的底层机制与关键局限
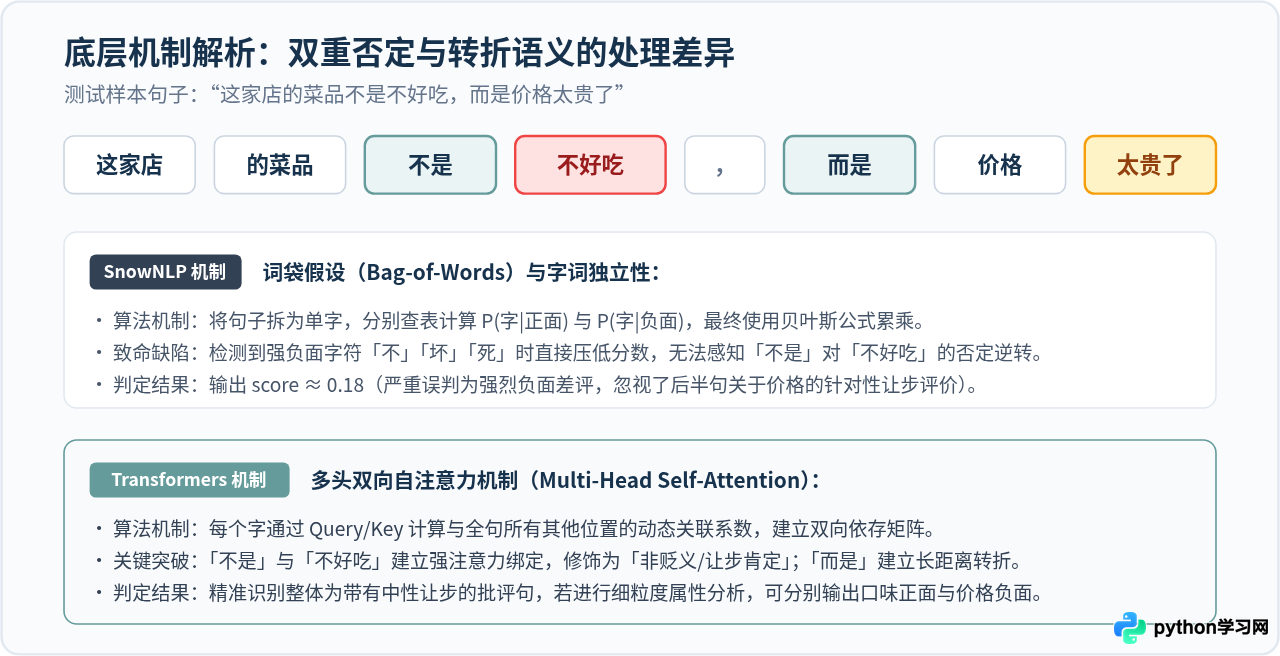
SnowNLP 情感模块的底层是一个基于字符级别的朴素贝叶斯分类器(Naive Bayes)。其核心假设是“特征条件独立”,即假定文本中每个字词的出现与上下文其他字词互不干扰,通过统计字词在正负语料库中的先验概率来累乘推断整体倾向。
- 预训练语料偏差:SnowNLP 默认的情感词库主要来源于电商网站的实物购物评价。当将其应用于金融新闻、社交媒体情绪、政务留言或医疗咨询时,准确率会大幅下滑。
- 无法正确处理句法转折与双重否定:由于采用词袋与字独立假设,只要句子中出现“不”、“差”、“烂”等字眼,贝叶斯乘积就会剧烈跌向负值,哪怕是“不是不好”、“不得不说很棒”这类弱肯定或双重肯定句式。
- 缺乏自适应阈值:默认输出分布往往集中在极近 0 或极近 1 的两端,对于中性评论很难界定合理的中间阈值。
二、复杂语义的突破:基于 Transformers 的高精度分析
当分析目标包含转折、双重否定、反讽,或者属于需要严谨判定的垂直领域时,传统的词袋与统计分类器已无法满足要求。此时应采用基于 Transformers 架构的预训练语言模型(如 BERT、RoBERTa 等)。
1. 为什么 Transformers 能够攻克复杂中文?
与按字独立查表的朴素贝叶斯不同,Transformers 模型依托双向自注意力机制(Bidirectional Self-Attention)。在计算任何一个字(Token)的向量表示时,模型都会动态计算该字与整句其他所有字之间的关联权重。
例如对于句子“这家店的菜品不是不好吃,而是分量太少”:
- SnowNLP 检测到“不”、“不好”、“少”,将其简单相加累乘,判定为强烈差评。
- Transformers 模型中,“不是”与“不好吃”通过注意力相互关联,消除了局部负面词对整体语义的片面主导,同时准确捕捉“而是”引发的语义重心转移,得出符合客观事实的精准推断。
2. 使用 Hugging Face Pipeline 快速推理
Hugging Face 提供的 transformers 库对中文模型有极好的支持。不需要从零编写张量操作,使用封装好的 pipeline 即可直接调用社区已在海量中文数据上微调好的模型。
首先安装 PyTorch 与 Transformers:
pip install torch transformers使用以下 Python 脚本加载已针对中文商品评价微调的 RoBERTa 情感模型进行批量预测:
from transformers import pipeline

# 实例化情感分析流水线,指定中文微调权重
classifier = pipeline(
    task="sentiment-analysis",
    model="uer/roberta-base-finetuned-jd-binary-chinese"
)

# 测试包含双重否定和转折的复杂句子
sample_sentences = [
    "这家店的菜品不是不好吃,但是性价比确实不算太高。",
    "本以为小众品牌质量不行,用了一个月居然意外好用,彻底颠覆了预期。",
    "外观看着高大上,实际上系统卡顿严重,所谓的黑科技纯属噱头。"
]

results = classifier(sample_sentences)

for text, res in zip(sample_sentences, results):
    label = "积极 (positive)" if res["label"] == "positive (label 1)" else "消极 (negative)"
    print(f"输入: {text}")
    print(f"预测: {label} | 置信度: {res['score']:.4f}\n")
预测: 消极 (negative) | 置信度: 0.9412
输入: 本以为小众品牌质量不行,用了一个月居然意外好用,彻底颠覆了预期。
预测: 积极 (positive) | 置信度: 0.9918
输入: 外观看着高大上,实际上系统卡顿严重,所谓的黑科技纯属噱头。
预测: 消极 (negative) | 置信度: 0.9984
三、垂直业务落地:基于私有数据的 Transformers 微调
开源社区的模型虽然在电商或通用社交评论上表现出色,但进入特定领域(如金融研报利好利空分析、游戏玩家论坛黑话、医疗满意度反馈)后,通用模型的表现同样会受词汇与特定句式限制。此时最有效的方案是:以中文预训练底座为基础,利用自身少量的标注数据进行微调(Fine-Tuning)。
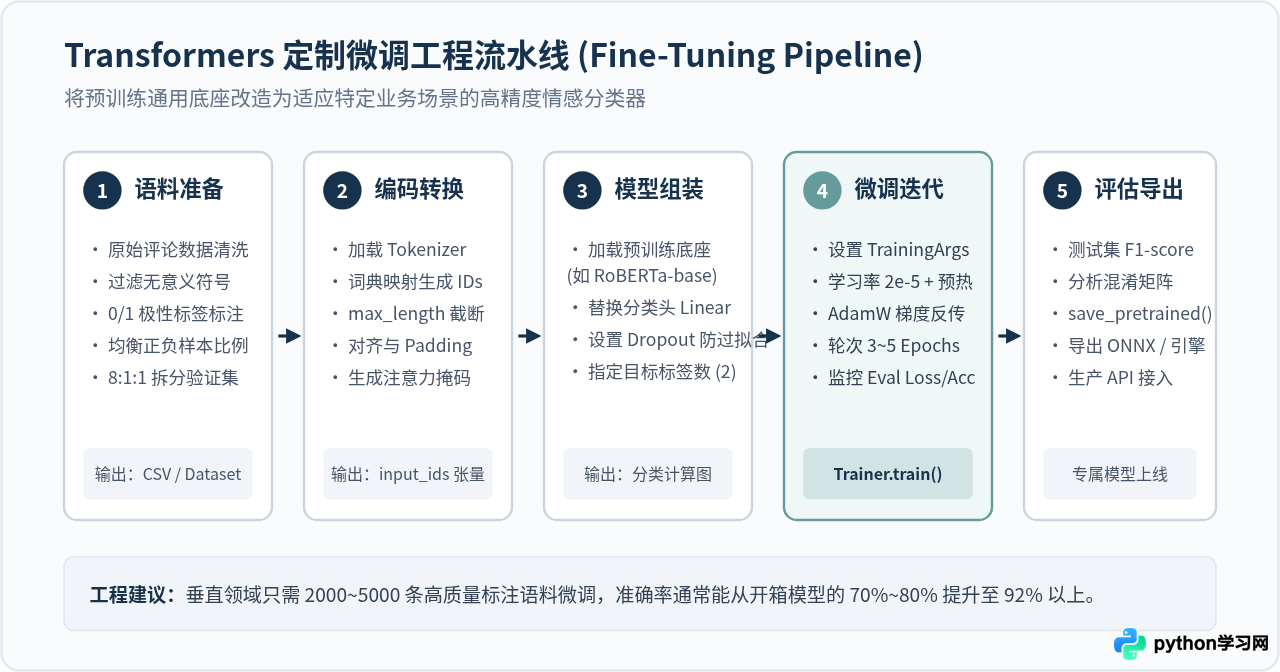
微调的核心步骤与代码骨架
通常只需准备 2000 到 5000 条人工标注的正负样本(格式为 text, label),即可在几十分钟内训练出一个高精度的专属模型。以下是使用原生 Trainer API 进行微调的核心代码:
import torch
from transformers import (
    AutoTokenizer,
    AutoModelForSequenceClassification,
    TrainingArguments,
    Trainer
)
from datasets import Dataset

# 1. 准备样本数据(示例数据)
data = {
    "text": [
        "本次季度业绩超预期,净利润同比大幅增长。",
        "产品召回事件引发市场担忧,短期股价承压。",
        "新业务线拓展顺利,客户续约率稳步提高。",
        "核心技术人员离职,研发进度存在延期风险。"
    ],
    "label": [1, 0, 1, 0]  # 1 为积极,0 为消极
}
dataset = Dataset.from_dict(data)

# 2. 分词与向量编码
model_name = "hfl/chinese-roberta-wwm-ext"
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_func(batch):
    return tokenizer(batch["text"], padding="max_length", truncation=True, max_length=128)

tokenized_dataset = dataset.map(tokenize_func, batched=True)

# 3. 加载预训练模型骨干与分类头
model = AutoModelForSequenceClassification.from_pretrained(model_name, num_labels=2)

# 4. 配置训练超参数
training_args = TrainingArguments(
    output_dir="./custom_sentiment_model",
    learning_rate=2e-5,
    per_device_train_batch_size=8,
    num_train_epochs=3,
    weight_decay=0.01,
    logging_steps=10,
    save_strategy="epoch"
)

# 5. 启动微调
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset,
)

# trainer.train()  # GPU 环境下解除注释即可启动训练
2e-5 至 5e-5 之间,轮次设置在 3 到 5 轮即可。过大的学习率容易破坏底座预训练权重已有的语言表征能力,而过多的轮次容易在小样本上发生过拟合。
四、方案对比与技术选型指南
选择情感分析技术方案并不是盲目追求最新或参数量最大的模型,而需要综合权衡硬件成本、推理延迟(QPS 要求)、业务文本复杂度与开发维护周期。
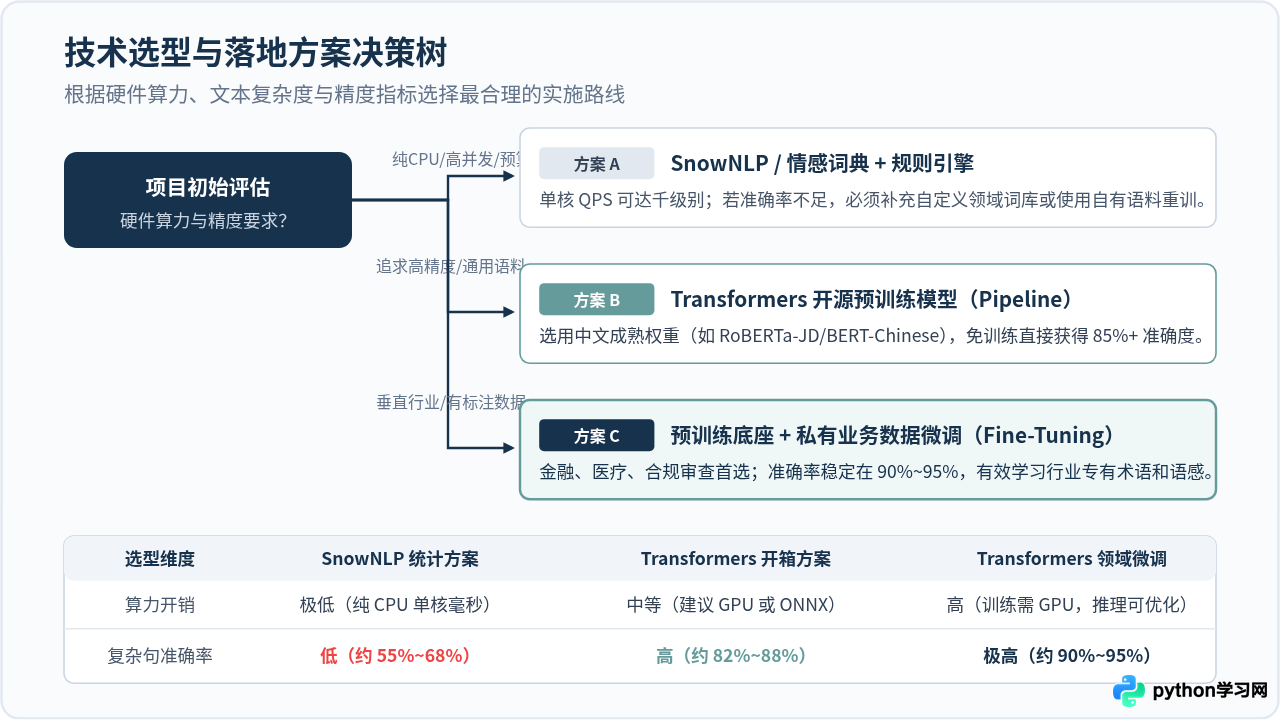
| 对比维度 | SnowNLP 统计方案 | Transformers 开箱方案 | Transformers 领域微调 |
|---|---|---|---|
| 核心算法 | 单字切分 + 朴素贝叶斯 | 预训练自注意力(BERT/RoBERTa) | 预训练底座 + 领域分类头微调 |
| 环境与硬件依赖 | 极低,仅需 Python 与标准 CPU | 中等,模型约 400MB,需 PyTorch | 高,训练需 GPU,部署可用 ONNX 优化 |
| 单条推理耗时 | < 1 毫秒(极速) | 约 15~50 毫秒(CPU)/ 3 毫秒(GPU) | 约 15~50 毫秒(CPU)/ 3 毫秒(GPU) |
| 复杂句识别准确率 | 较低(约 55%~68%) | 较高(通用领域约 82%~88%) | 极高(专属领域可达 92%~96%) |
| 推荐业务场景 | 离线千万级日志粗筛、简单规则基准 | 中等规模用户评价分析、通用舆情洞察 | 金融风控、医疗分析、政企精细化舆情系统 |
选型落地三步走建议:
- 概念验证阶段(Day 1):先使用
SnowNLP或 Hugging Face 开箱pipeline快速跑通 50 条业务样本,人工核对分类表现,建立基线。 - 若开箱准确率达到要求:直接基于开源模型搭建推理服务;若吞吐量受限,可通过
ONNX Runtime或TensorRT进行量化加速(FP16/INT8),兼顾速度与准确率。 - 若存在明显行业黑话或特殊句式:收集 2000 条内部真实业务数据进行人工核对标注,基于
chinese-roberta-wwm-ext等优质底座进行微调,这是获取生产级高准确度的最可靠路径。
五、常见问题排查与避坑指南
1. Transformers 首次运行时下载权重失败或网络超时
AutoModelForSequenceClassification.from_pretrained() 默认从 Hugging Face Hub 下载模型。如果在无外部网络环境或连接较慢的服务器上运行,可以提前在具备网络的环境中将模型完整权重文件(包含 config.json、pytorch_model.bin、vocab.txt 等)下载到本地磁盘目录,代码中将模型名称直接替换为本地绝对路径即可离线加载。
2. 遇到超过 512 字符的长文本如何处理?
原生 BERT 架构支持的最大序列长度通常为 512 个 Token。若直接传入数千字长文章,截断会丢失后半部分信息。针对长篇文本,生产中推荐采用段落切片汇聚法:先将文章按照句号或段落切分为若干短句,逐段计算情感概率,最后结合各段落位置权重或字数权重进行加权平均。
3. 正负样本严重不均衡时如何保证指标健康?
在大部分电商或客服实际数据中,好评比例往往远高于差评(如 9:1)。在此类数据上微调时,模型很容易偷懒全部预测为好评以获得看似很高的 Accuracy。在准备微调数据时,应主动通过欠采样(下采样多数类)或对少数类增加权重(设置 Loss 函数中的 weight 参数),并始终以 Macro F1-score 和混淆矩阵作为核心评估标准,而非单纯依赖总准确率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















