


Python调用Hugging Face预训练模型进行NLP任务指南
详细介绍在Python中使用Hugging Face Transformers库加载并运行预训练模型的全流程,涵盖环境安装、高阶pipeline快速调用、底层AutoClass分步张量推理、常见NLP任务实践及报错排查。
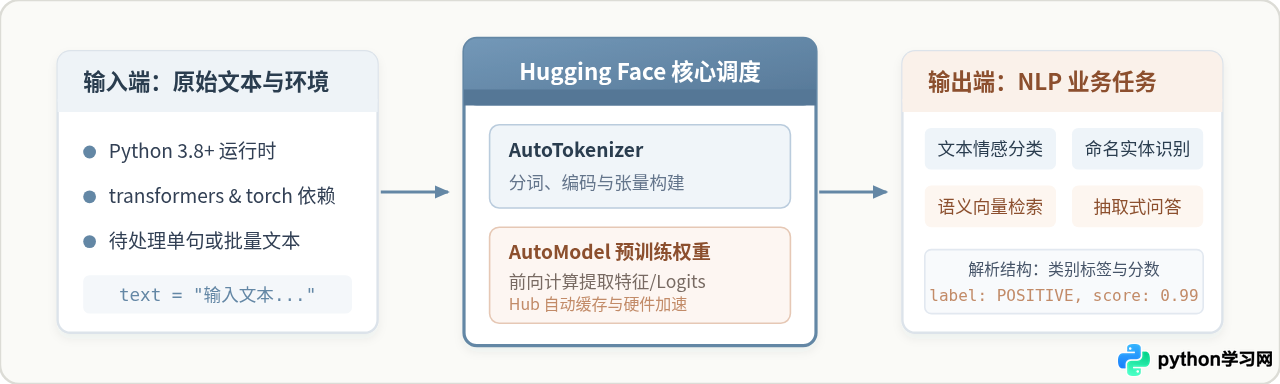
在 Python 中调用 Hugging Face 预训练模型完成自然语言处理(NLP)任务,标准路径主要分为两条:一是借助高阶封装 pipeline() 函数,仅需数行代码即可实现开箱即用的推理;二是通过 AutoTokenizer 与 AutoModel 系列类,精细控制文本分词、张量前向传播及结果后处理的全过程。本文将依次讲解环境准备、两类调用方式的具体实现步骤、常见 NLP 任务的代码范式以及实际运行中易出现的报错排查方法。
一、准备工作:运行环境与模型库依赖安装
调用预训练模型需要安装两个核心依赖库:负责模型结构与分词调度的 transformers,以及负责底层张量数学运算的深度学习框架(推荐使用 PyTorch)。
请在终端(Terminal 或命令提示符)中执行以下命令完成环境安装:
pip install transformers torch# Linux / macOS 终端
export HF_ENDPOINT=https://hf-mirror.com
# Windows PowerShell 终端
$env:HF_ENDPOINT="https://hf-mirror.com"from_pretrained() 发起的下载请求都会自动重定向至镜像站点。
安装完成后,可在 Python 交互式环境或脚本中运行以下最小代码检验环境是否就绪:
import transformers
import torch

print("Transformers 版本:", transformers.__version__)
print("PyTorch 版本:", torch.__version__)
print("CUDA 硬件加速可用状态:", torch.cuda.is_available())若输出了具体的版本号且未报告 ModuleNotFoundError,则表明运行环境已配置完毕。
二、核心流程:调用预训练模型的 5 个标准步骤
无论是进行情感分析、实体识别还是语义嵌入计算,在 Python 中调用预训练模型时底层均遵循统一的数据处理流水线。理解这 5 个连续步骤,有助于在遇到推理异常时快速定位环节。
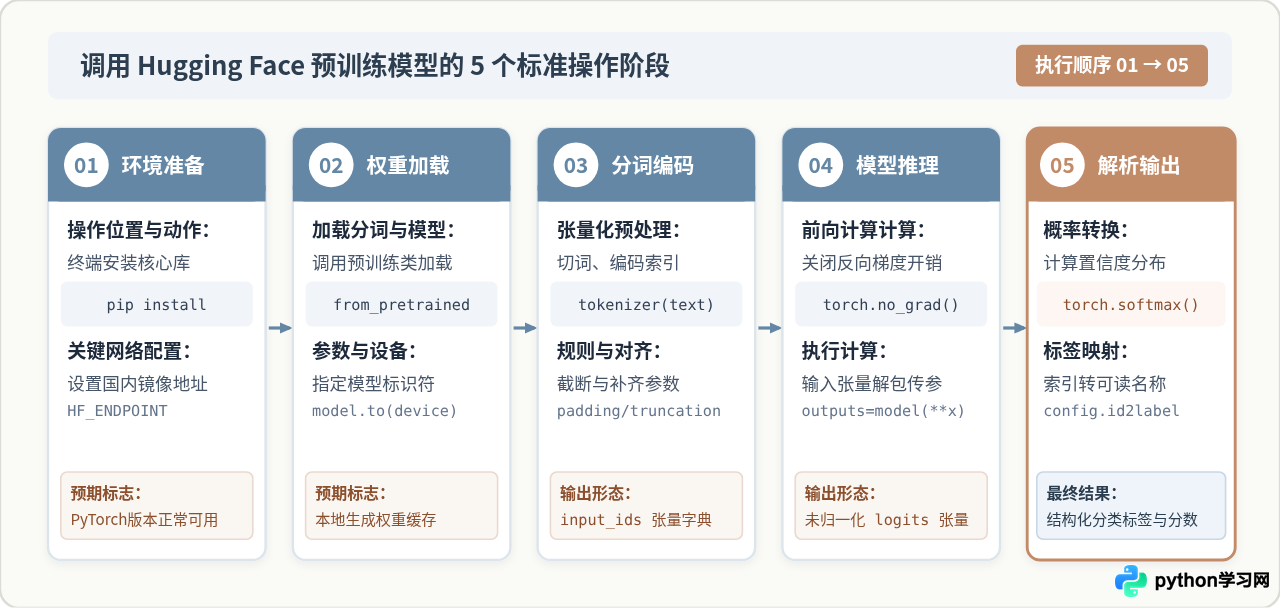
- 环境准备与模型选型:在 Hugging Face 模型库中确认任务类型与对应模型标识符(如
bert-base-chinese)。 - 权重与配置加载:通过对应的 AutoClass 调用
from_pretrained(),自动下载并缓存配置文件、词表与模型权重。 - 文本分词与张量化:将输入的原始字符串切分为 Token 序列,转换为模型所需的数值索引并包装为张量(Tensor)。
- 模型前向推理(Forward Pass):将输入张量传给模型计算,得到最后一层输出的未归一化特征得分(Logits)。
- 结果解析与映射:通过数学激活函数(如 Softmax 或 Sigmoid)计算概率分布,并结合
id2label将数值索引还原为人类可读的业务标签。
三、快速上手:使用高阶 Pipeline 进行开箱即用推理
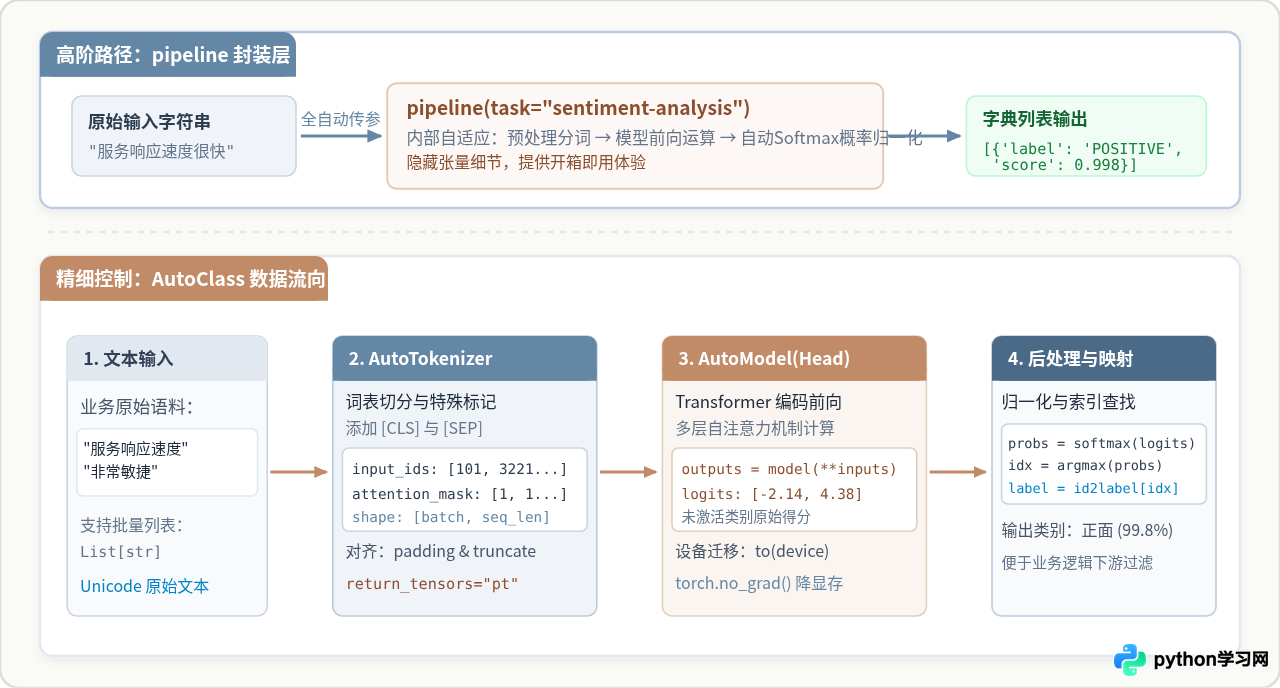
pipeline() 是 Transformers 库提供的高层抽象接口。它内部集成了分词器加载、文本截断、模型推理与输出后处理的全部步骤,非常适合快速验证模型效果或开发轻量级推理脚本。
以中文文本情感分类为例,使用 pipeline 调用的完整代码如下:
from transformers import pipeline

# 1. 实例化分类管线
# task 指定任务类型,model 指定 Hugging Face Hub 上的模型仓库名称
# device 参数:-1 表示使用 CPU,0 表示使用第一块 GPU
classifier = pipeline(
    task="sentiment-analysis",
    model="uer/roberta-base-finetuned-jd-binary-chinese",
    device=-1
)

# 2. 准备待分析的中文语料
sentences = [
    "屏幕色彩非常真实,做工精致,使用体验超出预期!",
    "物流速度很慢,包装破损严重,产品还存在明显划痕。"
]

# 3. 执行推理
results = classifier(sentences)

# 4. 打印格式化输出
for text, res in zip(sentences, results):
    print(f"输入文本: {text}")
    print(f"预测结果: 标签={res['label']}, 置信度={res['score']:.4f}
")从输出可以看到,pipeline() 直接返回了解析好的列表字典,无需手动处理矩阵维度或标签字典。
四、深入底层:使用 AutoClass 精细控制推理全流程
当需要将模型部署到低延迟生产服务、提取隐藏层词向量(Embeddings)、动态干预注意力掩码或自定义批量并行策略时,必须使用底层的 AutoTokenizer 和 AutoModel 类。
1. 分词器(AutoTokenizer)的核心作用与关键参数
预训练模型无法直接读取原始字符,必须通过分词器将文字转化为词表索引。分词器负责在两端添加特殊标记(例如 [CLS] 与 [SEP]),并生成注意力掩码(attention_mask),告知模型哪些位置是有效内容,哪些是补齐的空白填充。
2. 完整分步推理代码示例
以下代码展示了从原始字符串、张量构建、GPU/CPU 迁移到 Logits 概率归一化的完整底层实现:
import torch
from transformers import AutoTokenizer, AutoModelForSequenceClassification

# 1. 指定模型标识符并确定运行设备
model_name = "uer/roberta-base-finetuned-jd-binary-chinese"
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# 2. 加载与模型严格匹配的分词器和模型权重
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForSequenceClassification.from_pretrained(model_name)
model.to(device)

# 将模型切换为评估模式,关闭 Dropout 随机失活
model.eval()

# 3. 准备文本并执行分词与张量转换
texts = ["这款手机系统流畅度非常出色。", "按键松动,质量令人失望。"]
inputs = tokenizer(
    texts,
    padding=True,          # 自动按照批次中最长句子补齐 padding
    truncation=True,       # 句子超过最大长度时截断
    max_length=128,        # 最大允许长度限制
    return_tensors="pt"    # 返回 PyTorch Tensor 格式(若使用 TensorFlow 则填 "tf")
)

# 将输入张量转移至对应计算设备
inputs = {key: val.to(device) for key, val in inputs.items()}

# 4. 执行模型前向推理(禁用梯度计算以节省内存与算力)
with torch.no_grad():
    outputs = model(**inputs)

# outputs.logits 维度为 [batch_size, num_classes]
logits = outputs.logits

# 5. 后处理:使用 Softmax 转换为置信度概率
probabilities = torch.softmax(logits, dim=-1)

# 获取概率最大的类别索引及对应置信度数值
confidence_scores, predicted_indices = torch.max(probabilities, dim=-1)

# 6. 利用模型自带的 id2label 字典还原标签名
id2label = model.config.id2label

for text, pred_idx, conf in zip(texts, predicted_indices, confidence_scores):
    label_str = id2label[pred_idx.item()]
    print(f"语料: {text}")
    print(f"判定类别: {label_str} | 置信概率: {conf.item():.4f}
")五、方案选型:高阶 Pipeline 与底层 AutoClass 的权衡对比
在实际开发过程中,应当根据具体的应用阶段和系统约束选择恰当的调用方式。下表与图示系统梳理了两者的核心差异:
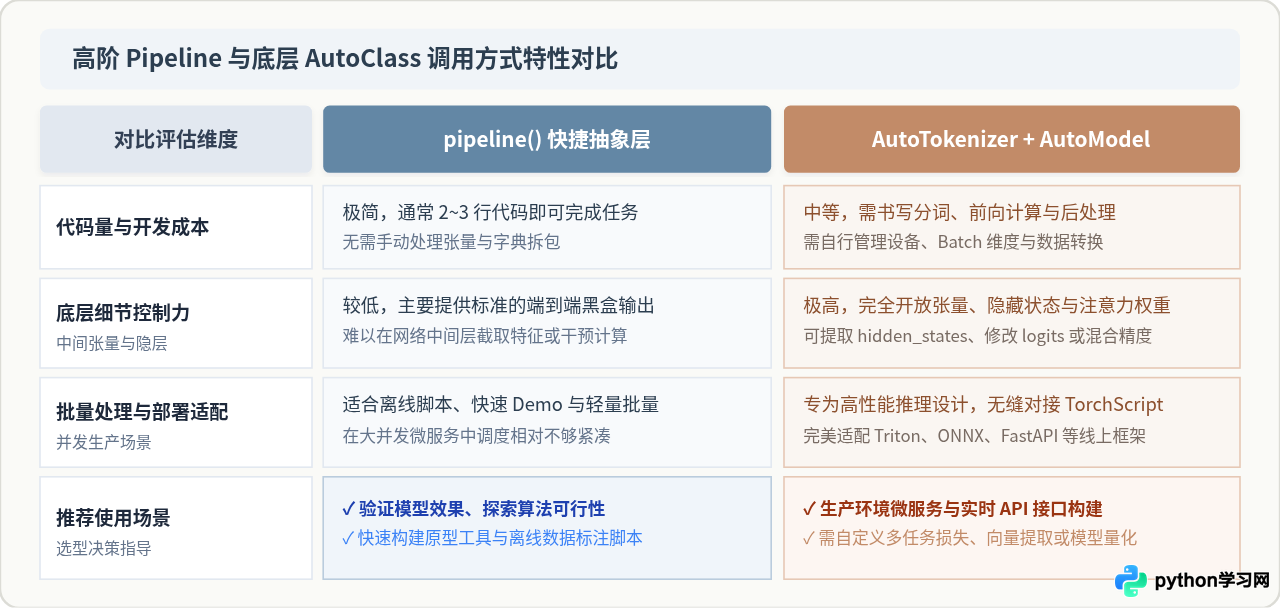
| 评估维度 | pipeline() 快捷抽象层 | AutoTokenizer + AutoModel 底层方式 |
|---|---|---|
| 代码复杂度 | 极低(1~2 行代码启动) | 中等(需自行维护输入字典、张量形状与设备迁移) |
| 中间结果可访问性 | 仅能获得最终整理好的预测结果 | 可自由获取全连接层输入、各层 Hidden States 与 Attention 权重 |
| 显存与性能调优 | 封装严密,调控手段较为有限 | 支持混合精度(AMP)、动态 Batching、量化加载(BitsAndBytes) |
| 最佳适用场景 | 快速探索、数据离线打标、PoC 原型验证 | 生产级 API 接口封装、向量化检索服务、多任务集成模型 |
六、实战延伸:四类典型 NLP 任务代码模版
除了常规文本分类,NLP 领域还包括命名实体识别(NER)、语义向量提取(Embedding)和抽取式问答(QA)。不同任务主要在于加载的 AutoModelFor* 类头部结构不同。
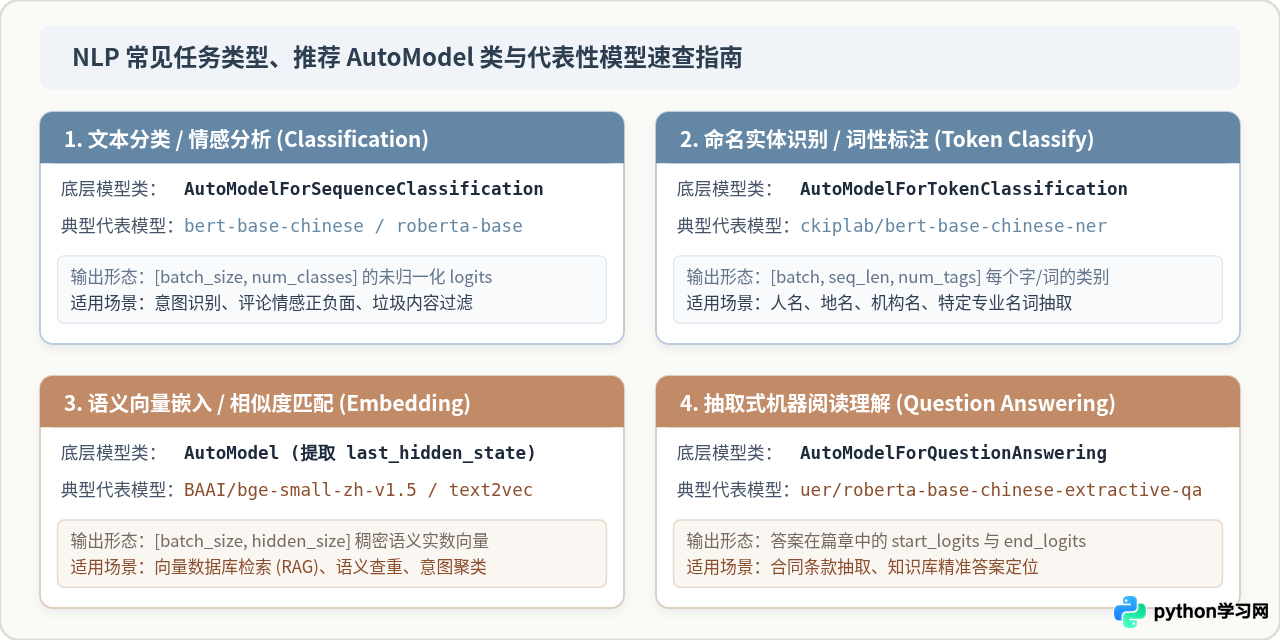
1. 命名实体识别(Token Classification)
实体识别用于提取文本中的人名、地名或机构名。模型会对每一个 Token 预测一个实体类别标签。
from transformers import pipeline

ner_tagger = pipeline(
    task="ner",
    model="ckiplab/bert-base-chinese-ner",
    aggregation_strategy="simple"  # 自动合并相邻同类实体词
)

text = "张三在北京市清华大学计算机系攻读博士学位。"
entities = ner_tagger(text)

for ent in entities:
print(f"实体内容: {ent['word']} | 类型: {ent['entity_group']} | 置信度: {ent['score']:.4f}")2. 文本语义嵌入与相似度向量提取(Feature Extraction)
在基于大语言模型的检索增强生成(RAG)或语义去重场景中,需将文本转化为稠密语义向量。此时应使用不带分类头的基座 AutoModel,并对末层隐层特征进行平均池化(Mean Pooling):
import torch
from transformers import AutoTokenizer, AutoModel

model_id = "BAAI/bge-small-zh-v1.5"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModel.from_pretrained(model_id)
model.eval()

query = "自然语言处理技术的发展应用"
inputs = tokenizer(query, return_tensors="pt", padding=True, truncation=True)

with torch.no_grad():
    outputs = model(**inputs)
    # 提取最后一层隐藏状态,维度为 [batch_size, sequence_length, hidden_dimension]
    token_embeddings = outputs.last_hidden_state

    # 结合 attention_mask 进行平均池化,生成句级别向量
    attention_mask = inputs["attention_mask"].unsqueeze(-1).expand(token_embeddings.size()).float()
    sum_embeddings = torch.sum(token_embeddings * attention_mask, 1)
    sum_mask = torch.clamp(attention_mask.sum(1), min=1e-9)
    sentence_embedding = sum_embeddings / sum_mask

# 对向量进行 L2 归一化,方便直接使用点积计算余弦相似度
normalized_embedding = torch.nn.functional.normalize(sentence_embedding, p=2, dim=1)
print(f"生成语义向量维度: {normalized_embedding.shape}")3. 抽取式问答(Question Answering)
给定参考段落与问题,模型直接定位答案在段落中的起始与结束字符位置:
from transformers import pipeline

qa_pipeline = pipeline(task="question-answering", model="uer/roberta-base-chinese-extractive-qa")

context = "深度学习是机器学习的一个分支,它通过构建多层神经网络来从大量数据中学习高级特征表达。"
question = "深度学习依靠什么学习高级特征?"

res = qa_pipeline(question=question, context=context)
print(f"问题: {question}")
print(f"提取答案: {res['answer']} (置信度: {res['score']:.4f})")七、常见问题排查与注意事项
1. 本地磁盘空间与模型缓存目录自定义
Transformers 默认会将下载的权重保存在用户主目录下的 ~/.cache/huggingface/hub。在系统盘空间紧张的服务器上,多模型下载容易导致磁盘占满。可通过设置环境变量 HF_HOME 或在代码中显式指定 cache_dir 参数改变保存位置:
tokenizer = AutoTokenizer.from_pretrained("bert-base-chinese", cache_dir="/data/models_cache")
model = AutoModel.from_pretrained("bert-base-chinese", cache_dir="/data/models_cache")
2. 序列长度超限报错(Token indices sequence length is longer than the specified maximum sequence length)
BERT、RoBERTa 等经典编码器模型的位置编码上限通常为 512 个 Token。若传入长篇文稿而未设置截断,将触发越界警告或张量运算异常。解决方案:分词时务必明确添加参数 truncation=True,必要时配合 max_length=512。
3. CPU 与 GPU 设备不一致报错(RuntimeError: Expected all tensors to be on the same device)
该错误通常是因为模型已通过 model.to("cuda") 移至 GPU,但通过分词器生成的 inputs 张量仍停留在 CPU 内存中。解决方案:确保输入字典内的全部张量显式迁移至与模型相同的设备:
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)

inputs = tokenizer(text, return_tensors="pt")
# 正确做法:遍历字典将所有张量移至 device
inputs = {k: v.to(device) for k, v in inputs.items()}
outputs = model(**inputs)本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















