Python实现全角与半角字符转换的方法
本文介绍Python中全角与半角字符转换的实现原理及代码。全角字符Unicode范围通常为0xFF01~0xFF5E,半角为0x21~0x7E,空格需单独处理(全角12288,半角32)。通过chr()、ord()函数结合偏移量计算,可高效完成非中文及符号的全半角互换,适用于NLP数据预处理。
10-15
8




本文介绍Python中全角与半角字符转换的实现原理及代码。全角字符Unicode范围通常为0xFF01~0xFF5E,半角为0x21~0x7E,空格需单独处理(全角12288,半角32)。通过chr()、ord()函数结合偏移量计算,可高效完成非中文及符号的全半角互换,适用于NLP数据预处理。
本文提供PHP环境下实现Unicode字符串编码(将中文转为\u格式)和解码(将\u格式还原为可读文本)的完整类库代码。通过iconv进行字符集转换,结合正则表达式解析Unicode序列,解决JSON数据交互或前端展示中的乱码问题。
在Java开发中,默认String.length()无法准确反映包含汉字的字符串实际显示长度(通常一个汉字占2字节或2个字符位置)。本文介绍了利用Unicode编码范围\u4E00至\u9FBB识别汉字,并通过累加偏移量来精确计算字符串视觉长度的原理与完整代码实现。
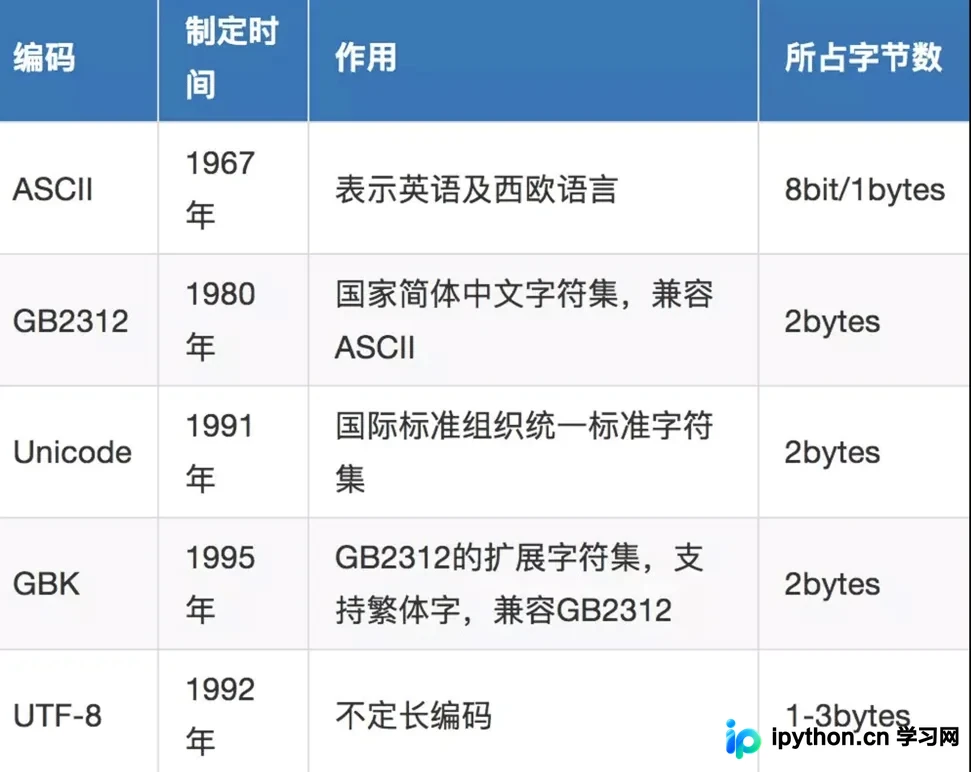
本文详细解析Python中常见的四种编码格式:ASCII、Unicode、UTF-8及GBK。从Python2默认ASCII到Python3默认UTF-8的演变出发,阐述各编码的字节占用、适用范围及存储效率差异,帮助开发者理解字符编码原理并解决乱码问题。
本文详细解析Python中字符串前缀r、f、u、b及L的具体含义与应用场景。涵盖Unicode编码处理中文、原始字符串r避免转义、字节串b用于网络编程、f-string高效格式化以及宽字符L的使用差异,帮助开发者根据需求选择正确的字符串类型。
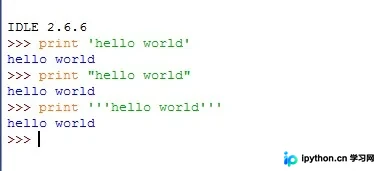
本文深入解析Python字符串的核心机制,涵盖单引号、双引号及三引号的声明差异,辨析str与unicode编码在中文处理中的表现。详细讲解转义字符与原始字符串(r/R)的使用场景,对比raw_input与input函数的行为区别,并演示基于百分号的字符串格式化输出技巧,帮助开发者掌握Python文本处理基础。
本文介绍在Python爬虫或数据处理中,当保存的中文数据呈现为Unicode编码格式时,如何利用eval函数将其还原为可读字符串。通过解析Python表达式,eval可将表示字符串的Unicode字面量转换为实际字符。文章同时补充了使用str或repr函数处理特殊字符的基础知识,并提供相关代码示例以供参考。
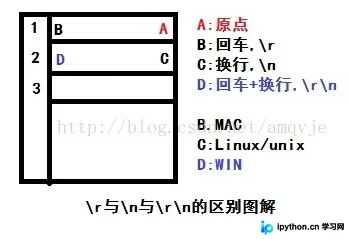
本文详细解析了Python中\r、\n及\r\n的历史渊源与系统差异,涵盖Unix、MAC和Windows的不同标准。同时介绍了如何处理爬虫获取的Unicode编码文件,通过指定encoding='unicode_escape'等参数正确读取和解码内容,确保数据准确输出。
本文介绍使用Python将单个TXT文本文件按固定字节数分割为多个小文件,并通过特定二进制标记进行重组的方法。代码重点处理了Unicode编码下的中文字符截断问题,利用struct模块打包字符以维持文件完整性,适用于大文本文件的分片处理场景。
本文详解Python3处理Unicode编码转中文时的常见误区,特别是通过requests获取非硬编码字符串时的显示问题。提供了利用decode().encode('unicode_escape')进行转换的具体代码方案,并介绍了使用__future__模块及codecs库解决文件写入UnicodeEncodeError的方法,帮助开发者避免Python2迁移过程中的编码困扰。
本文探讨Python2中常见的中文乱码问题,特别是当Unicode字符串被错误地按GBK系列编码解码时产生的现象。通过分析repr()输出及字节序列,揭示“会员”等汉字显示为“盲录職氓聭聵”的原因,并提供使用encode('raw_unicode_escape').decode()进行修复的具体方法。
本文详细解析Python 2与Python 3在字符编码处理上的核心差异。Python 2默认使用ASCII,需手动指定编码;而Python 3默认采用UTF-8。文章深入探讨了内存中Unicode存储机制、终端编码转换过程,以及通过u前缀解决乱码问题的具体方法,帮助开发者理解并避免编码错误。