
Python全栈开发核心语法与基础知识点梳理
本文梳理Python全栈开发所需的核心语法,涵盖中文编码、数值类型、HTML标签优化及变量命名规范。重点详解%s、%d与f-string格式化输出技巧,并通过实际代码示例演示输入处理与特殊字符转义,帮助开发者掌握独立开发所需的基础编程技能。



本文梳理Python全栈开发所需的核心语法,涵盖中文编码、数值类型、HTML标签优化及变量命名规范。重点详解%s、%d与f-string格式化输出技巧,并通过实际代码示例演示输入处理与特殊字符转义,帮助开发者掌握独立开发所需的基础编程技能。
本文介绍了一个基于PHP的密码生成类GeneratePassword的实现。该类支持自定义密码长度(4-50位)、生成数量及组合规则(大小写字母、数字、特殊字符)。通过构造函数初始化参数,调用batchGenerate方法即可批量获取符合要求的随机密码,适用于需要强密码生成的场景。
本文深入解析神经网络中的反向传播算法,阐述其通过计算成本函数对权重和偏置的偏导数来优化模型的核心原理。结合Python代码示例,详细演示Sigmoid与ReLU激活函数的导数计算,并提供完整的BP算法实现案例,帮助开发者掌握深度学习的基础训练机制。
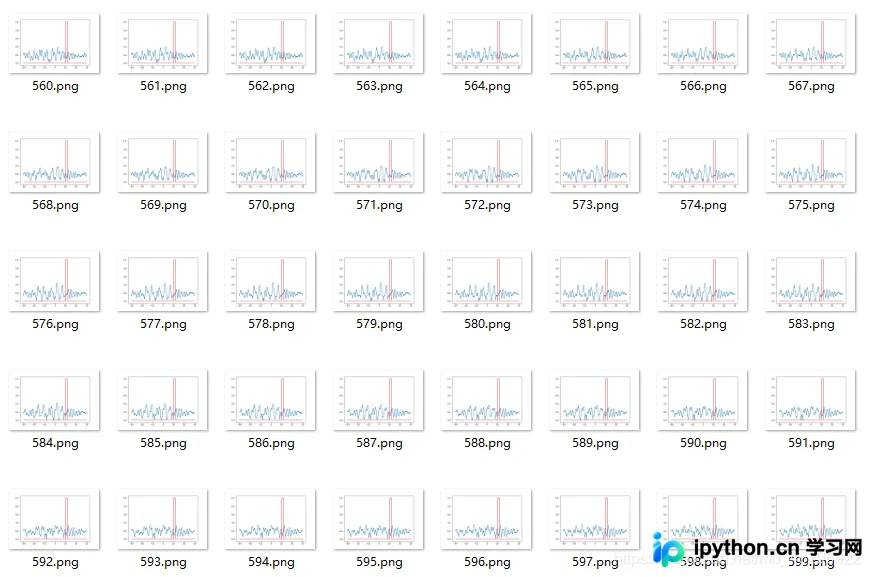
本文介绍如何使用Python和OpenCV库将多张图片序列合成为视频文件。核心步骤包括读取图片、创建VideoWriter对象并写入帧。重点解决中文路径无法读取及路径格式错误等常见问题,提供完整代码示例与参数说明,适用于制作演示动画或视频序列处理。
本文介绍了一个基于Python编写的简单脚本,用于检测特定关键词在百度搜索引擎中的网站排名。通过模拟HTTP请求获取搜索结果页面,并利用正则表达式解析HTML内容,脚本能够筛选出目标域名在搜索结果中的位置。文章提供了完整的源代码及命令行使用示例,适用于需要快速验证SEO效果的技术人员。
本文详解如何利用Python爬虫技术处理招聘数据。重点讲解如何校正拉勾网与Boss直聘的工作年限描述差异,建立统一的等级标准,并建议舍弃“经验不限”数据以保证统计准确性。同时提供基于PIL库的图片批量筛选代码实例,帮助开发者提升数据处理效率。
本文深入解析Python中的动态规划算法,通过斐波那契数列和爬楼梯两个经典案例,展示从暴力递归到空间优化的完整思路。详细讲解如何识别重叠子问题,利用数组或常数变量存储中间状态,从而显著提升算法效率,适用于LeetCode等编程实战场景。
本文详解Python Scrapy框架中项目数据的持久化处理方案。针对抓取数据需后期分析的需求,重点介绍如何将默认的文件存储切换至MySQL数据库。通过修改settings.py配置文件,启用SavetoMySQLPipeline并配置数据库连接参数,实现高效的数据存储与管理,避免文件散乱带来的检索难题。
本文系统梳理Python Scrapy框架在爬虫开发中的关键注意事项。涵盖利用Redis实现分布式去重与存储、通过Middleware处理代理IP与Headers、合理配置Settings文件、使用FormRequest提交表单数据,以及结合PhantomJS处理动态渲染页面的技术方案。旨在帮助开发者提升爬取效率与稳定性,解决常见技术痛点。
本文介绍如何利用Python和OpenCV库实现图像角点检测及基于角点的水平连线功能。通过goodFeaturesToTrack算法提取角点坐标,计算最大最小Y值,并绘制两条水平直线。代码完整展示了从读取图像、灰度转换到角点标记及连线绘制的完整流程,适用于图像特征处理场景。
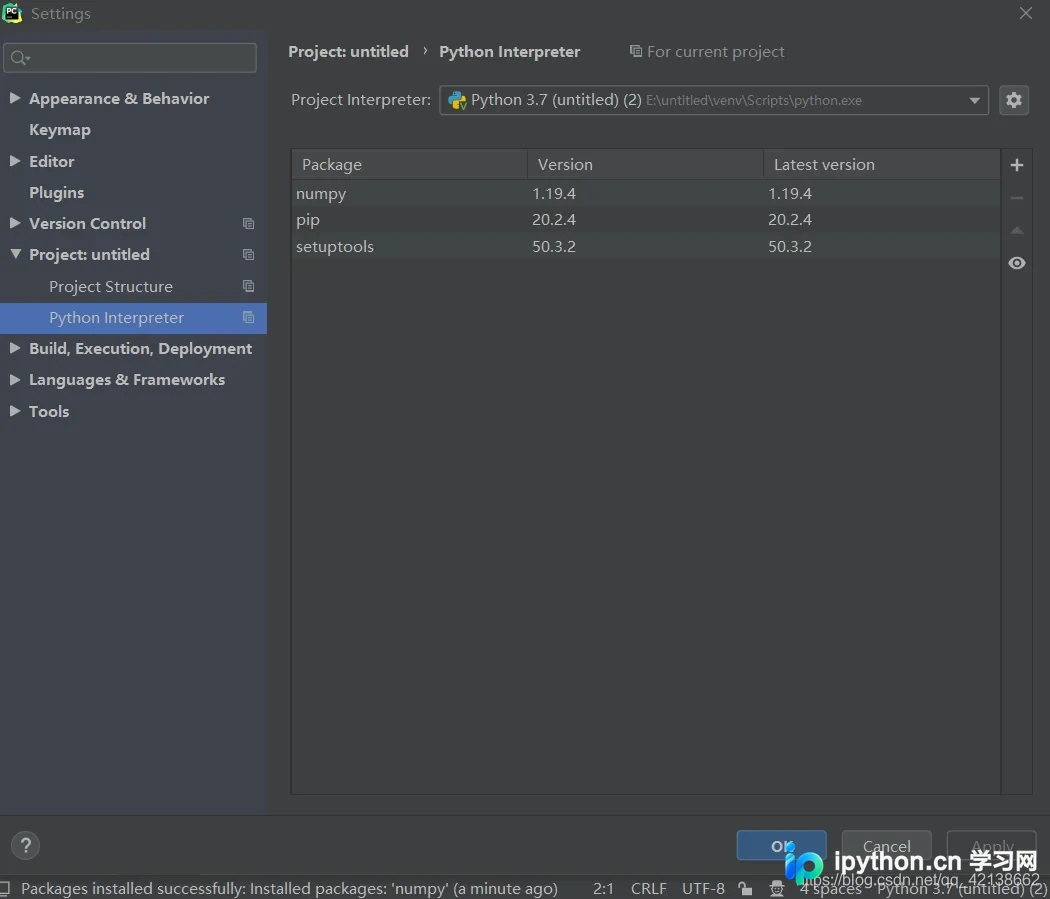
本文介绍在 PyCharm 2020.1 版本中安装 Python 库的具体步骤。通过进入 File-Setting-Project untitled-Python Interpreter 界面,点击左上角 + 号,在搜索栏输入依赖库名称并点击左下角 Install Package 即可完成安装。
本文提供 PyCharm 2020.2.3 版本的激活码及破解补丁安装教程。内容涵盖直接输入激活码方案,以及通过 jetbrains-agent-latest.zip 补丁文件进行插件安装的详细步骤。从注册界面操作到重启验证,完整演示如何获取永久激活状态及创建新项目。




