Python数据分析常见报错修复:SettingWithCopyWarning与KeyError代码解决
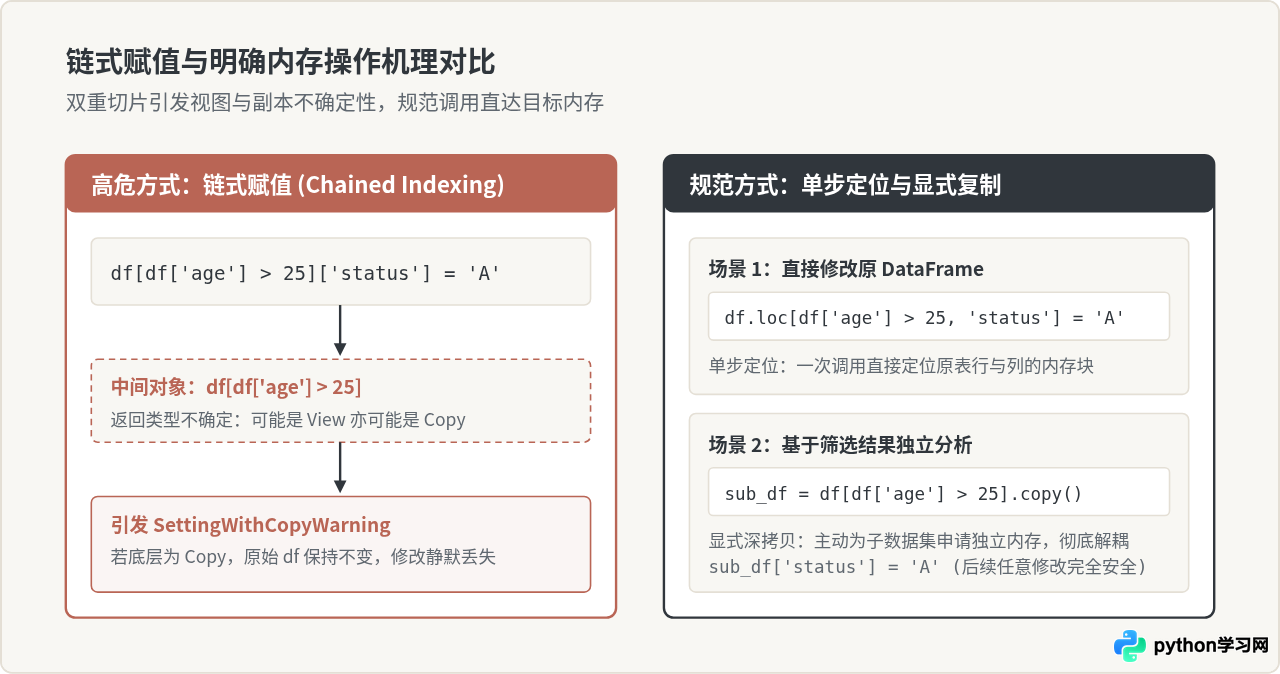
详细剖析Python与pandas数据分析中高频出现的SettingWithCopyWarning与KeyError报错成因,给出基于.loc、.copy()及索引规范的代码解决方案与排查流程。



详细剖析Python与pandas数据分析中高频出现的SettingWithCopyWarning与KeyError报错成因,给出基于.loc、.copy()及索引规范的代码解决方案与排查流程。
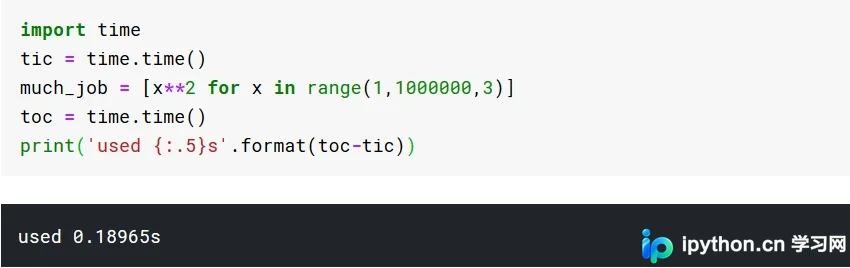
本文系统整理了24个Python性能优化技巧,涵盖代码计时、查找与循环加速、函数优化、标准库与高阶函数应用、NumPy向量化、Pandas及Dask数据处理,以及多线程多进程并行计算。通过对比低速与高速实现方案,帮助开发者显著提升代码执行效率。
本文深入解析Python开发中的核心安全风险,涵盖SQL注入、跨站脚本(XSS)及CSRF攻击的原理与防御。通过对比不安全代码与使用参数化查询、CSRF令牌及哈希算法的安全实现,提供具体的代码修复方案。同时介绍cryptography、pyjwt等库的应用及敏感信息配置规范,帮助开发者构建高安全性的Python应用。
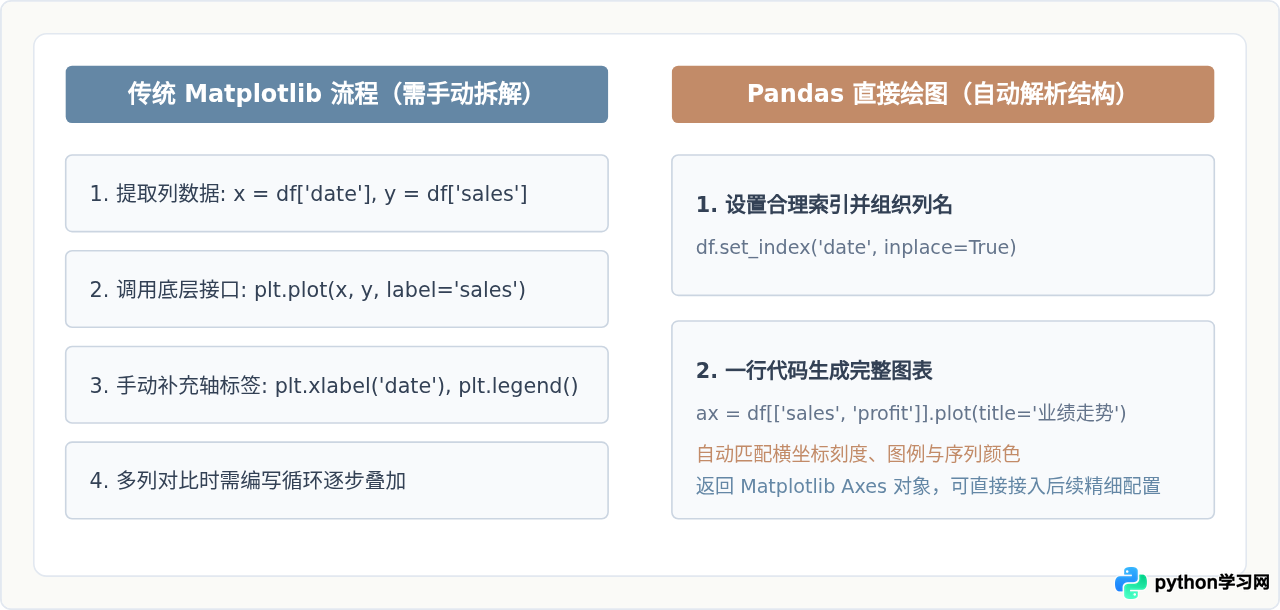
详解如何使用Pandas DataFrame内置的.plot()方法直接生成图表,省去繁琐的数据拆分与标签配置,简化Python数据分析中的可视化代码。
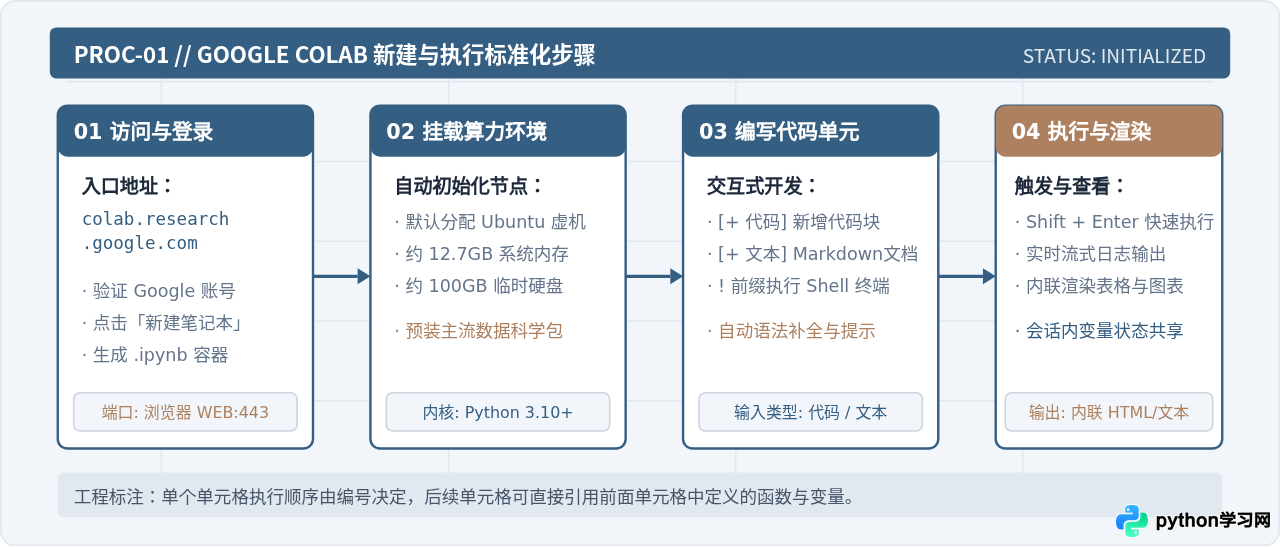
针对初学者的Google Colab免费使用全流程指南,涵盖云端环境初始化、Python代码与交互式单元格执行、免费T4 GPU硬件加速切换、Google Drive持久化存储挂载以及完整的数据分析实操案例与避坑技巧。
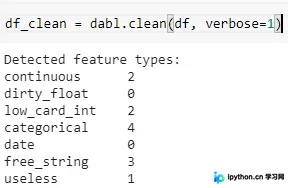
dabl是Python开源数据分析基线库,通过几行代码自动完成数据预处理、特征可视化及基线模型训练。本文介绍其核心功能,包括自动识别数据类型、执行探索性数据分析(EDA)及返回最佳预测模型,旨在简化机器学习开发流程。
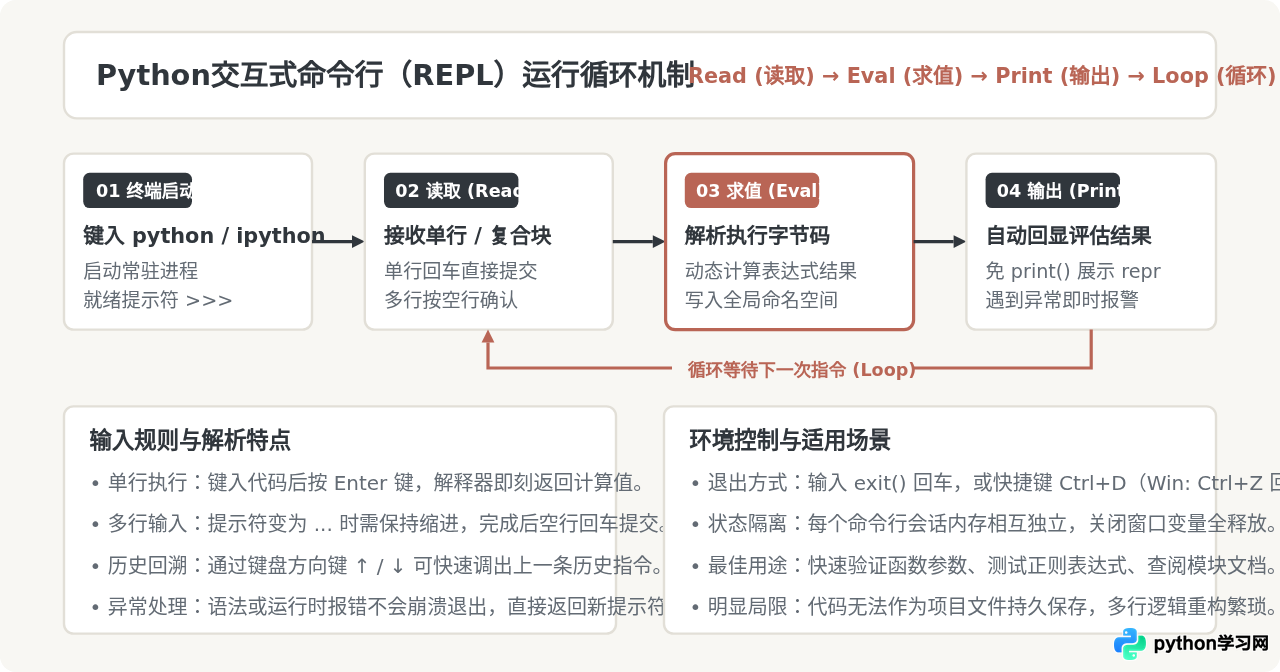
详细讲解Python交互式命令行(REPL)与Jupyter Notebook运行代码的具体步骤、底层执行机制、常用快捷键与操作避坑技巧,帮助开发者根据场景选择最合适的交互式开发工具。
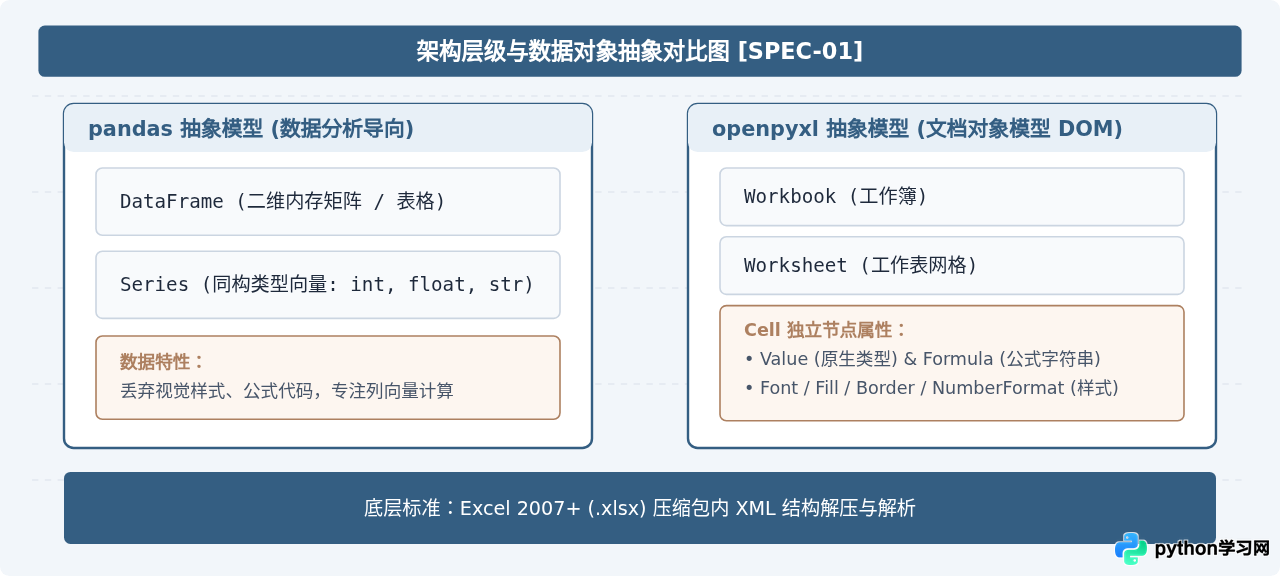
深入对比Python中pandas与openpyxl读取Excel文件的核心差异、底层实现、性能表现与适用场景,提供代码示例与清晰的工程选型决策路径。
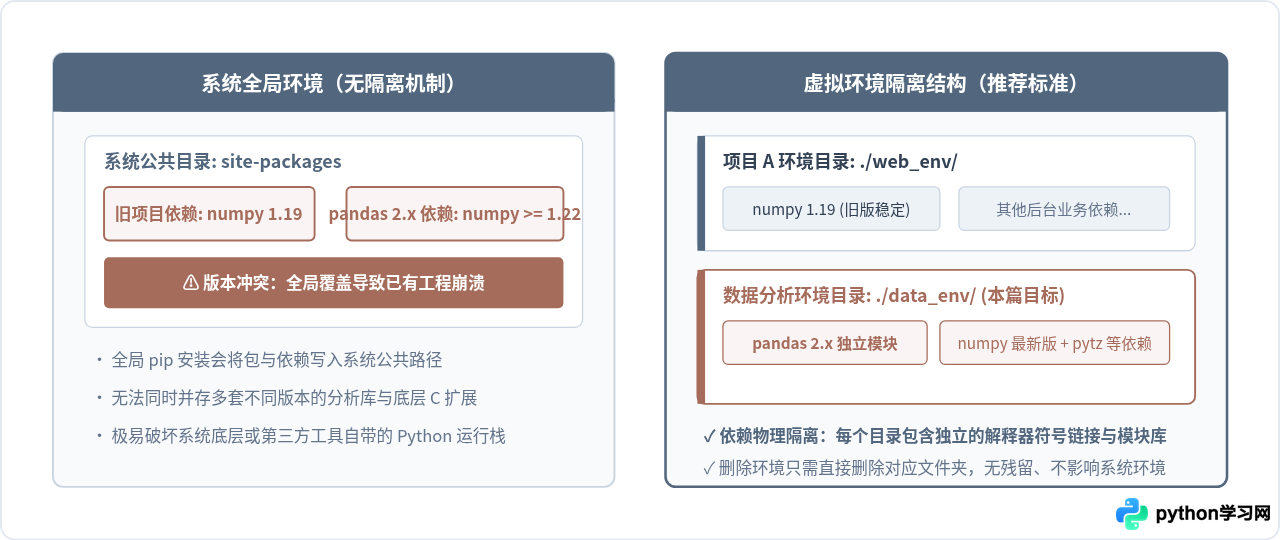
本文详解如何在Python中利用内置venv工具创建独立的虚拟环境,并实现pandas模块及其依赖的完全隔离安装。包含隔离原理对比、PATH重定向机制、端到端终端操作命令、安装验证方法及常见踩坑排查。
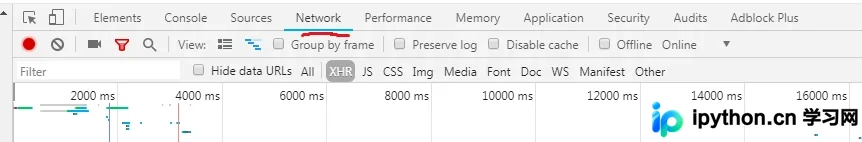
本文介绍如何利用Python爬虫技术抓取智联招聘网站上的数据分析师岗位信息。通过浏览器开发者工具分析网络请求,定位Ajax接口并构造请求参数,最终使用Python代码实现数据提取与保存,为求职分析提供数据支持。
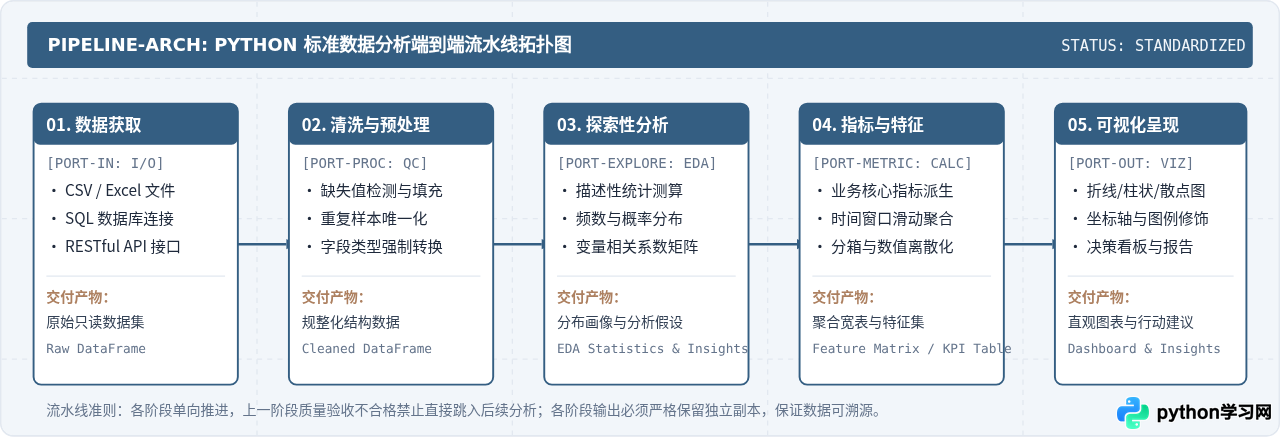
详细拆解Python数据分析的标准执行流程,从数据获取、数据清洗、探索性分析、指标计算到数据可视化呈现五个核心步骤,提供可复用的工程代码与实战注意事项。
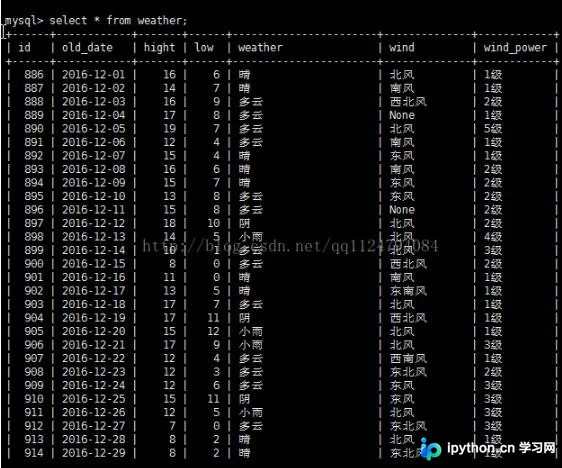
本文介绍如何利用Python进行历史天气数据的采集与分析。通过编写脚本获取天气信息,并将数据存入MySQL数据库及Excel文件中,为后续趋势分析提供数据支持。文章包含完整代码示例,适合对数据抓取和存储感兴趣的开发者参考。