



大模型已经很擅长理解需求、组织语言,甚至能给出看起来完整的处理方案,但真正做业务系统时,问题很快会暴露出来:它能判断该做什么,却不能直接替你调用后台接口、扣减库存或查询数据库。Function Calling 的价值,正是在模型的“判断”与程序的“执行”之间补上一层可控机制。
如果你用 Go 来做这件事,其实不一定需要先引入 LangChain 一类的重型框架。把核心链路拆开看,无非是让模型返回函数意图、由 Go 程序完成分发和执行、再把结果送回模型形成闭环。理解这几个环节之后,你更容易判断系统边界、安全风险,以及怎样把延迟和复杂度压到合理范围内。
Function Calling 到底解决了什么问题
先要澄清一个常见误解:Function Calling 并不是让 LLM 直接运行你的 Go 代码。
更准确地说,模型在这里扮演的是“调度员”。你把一组可用工具及其说明告诉模型后,它会结合用户意图做判断;如果认为应该调用某个工具,就返回一段特定格式的结果,通常是 JSON,告诉你的程序“建议调用哪个函数、参数是什么”。
真正的执行权仍然在应用程序手里。包括代码执行、权限校验、审计、异常处理,都应由 Go 服务负责。这条边界非常关键,可以概括为一句话:意图在模型,执行在代码。只要这条边界不被打破,系统就不会因为模型“会说”而自动拥有过高权限。
这也是 Function Calling 能成为 Agentic Workflow 基础设施的原因。它不是为了让模型更像魔法,而是为了把“不确定的语言输出”转成“确定的业务动作”。
先让模型听懂你的工具:Schema 如何定义
模型不会凭空知道你的函数能做什么、参数怎么传,所以你需要提供一份清晰的“说明书”。在 OpenAI 这一类主流接口规范里,这份说明通常就是 JSON Schema。
对 Go 开发者来说,手写一大段 JSON 描述既重复又容易失配。更实用的做法,是利用结构体和标签,把业务参数定义和模型说明绑在一起。这样一来,代码本身就是单一事实来源,后续维护成本会低很多。
// 定义工具参数的结构体
type GetWeatherArgs struct {
    City string `json:"city" description:"城市名称,例如:北京"`
    Unit string `json:"unit" enum:"c,f" description:"温度单位"`
}

// 自动生成 Schema 的伪代码逻辑
// 通过 reflect 遍历字段名和 tag,生成 JSON 定义
这类写法的价值不只是“省事”,更重要的是同步。比如你改了 City 字段的描述,或者新增了一个可选参数,只要 Schema 是通过反射自动生成的,模型看到的工具说明也会随之更新,不容易出现“代码已经变了,提示文档还停在旧版本”的问题。
在实践里,Schema 至少应覆盖几个关键点:参数名称、类型、是否必填、枚举值约束,以及必要的业务提示。描述不需要写成长文,但要足够精确,否则模型虽然能调用工具,却未必总能传对参数。
中心化分发器怎么设计
当模型已经能返回函数名和 JSON 参数,下一步就是接住它,并把请求路由到正确的业务逻辑上。这一层通常可以抽象成一个中心化的 Dispatcher 或 Registry。
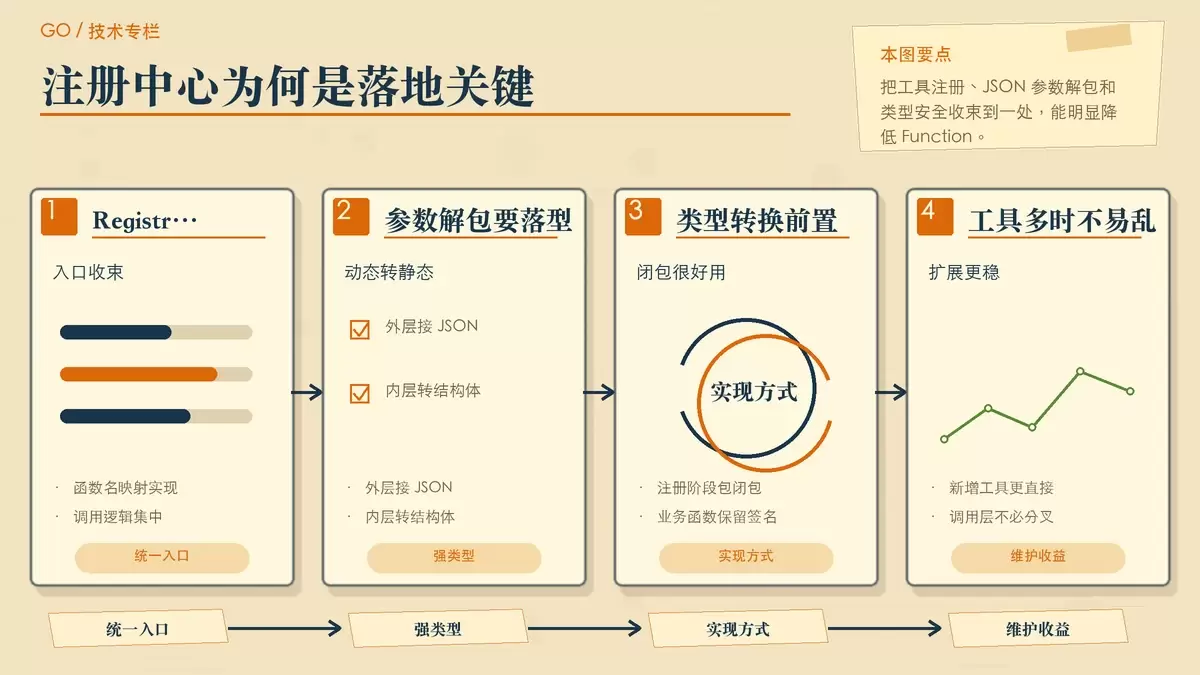
它的职责很直接:根据模型给出的函数名找到对应实现,再把参数交给具体函数执行。这样做的好处是,工具注册、调用入口、错误处理都能收束到一处,后续扩展几十个工具时也不会失控。
// ToolRegistry 维护函数名与执行逻辑的映射
type ToolRegistry struct {
    tools map[string]func(jsonArgs string) (string, error)
}

func (r *ToolRegistry) Register(name string, fn func(string) (string, error)) {
    r.tools[name] = fn
}
这里真正需要处理的难点,在于“模型返回的是动态 JSON,而 Go 是强类型语言”。一个常见做法是在 Register 阶段用闭包把解包逻辑包进去:外层统一接收字符串参数,内层再转换成具体结构体,并调用真正的业务函数。
这样设计有两个现实好处。第一,注册中心保持统一入口,不会因为每个工具参数类型不同而让调用层变得混乱;第二,业务函数仍然能拿到类型安全的结构体,而不是到处手动解析 map[string]any。
参数解包不能只靠 json.Unmarshal
Function Calling 真正容易踩坑的地方,往往不是“能不能调起来”,而是“调起来之后够不够稳”。因为模型输出的参数本质上仍然是不可信输入,它可能漏字段、类型写错,甚至带着明显幻觉。
因此,参数解包最好不要停留在简单的反序列化,而要把校验、容错和错误反馈都考虑进去。
func (r *ToolRegistry) Invoke(name string, args string) (string, error) {
    fn, ok := r.tools[name]
    if !ok {
        return "", fmt.Errorf("未定义的工具: %s", name)
    }
    // 执行具体的业务逻辑并返回结果
    return fn(args)
}
像下面这些情况,在实际接入里都很常见:
- 模型把数字写成字符串;
- 遗漏了可选参数,或者把必填参数拼错;
- 枚举值超出约束范围;
- 字段表面上存在,但语义并不成立。
所以,一个健壮的参数处理流程通常至少包括三层:JSON 解包、字段级校验、业务级校验。前两层解决格式问题,后一层解决“能不能执行”的问题。
还有一个很实用的原则:校验失败时,不一定要立刻终止整个对话。很多场景下,把明确的错误原因反馈给模型,反而能让它基于错误提示重新生成一版更正确的参数,完成一次“自愈式重试”。这比直接抛给用户一句模糊报错更适合 Agent 场景。
执行完还不够:结果必须回到模型上下文
函数调用成功,并不等于对话已经结束。模型之所以发起工具调用,是为了借助外部信息继续完成回答,所以执行结果必须再回传给它,整条链路才算闭环。
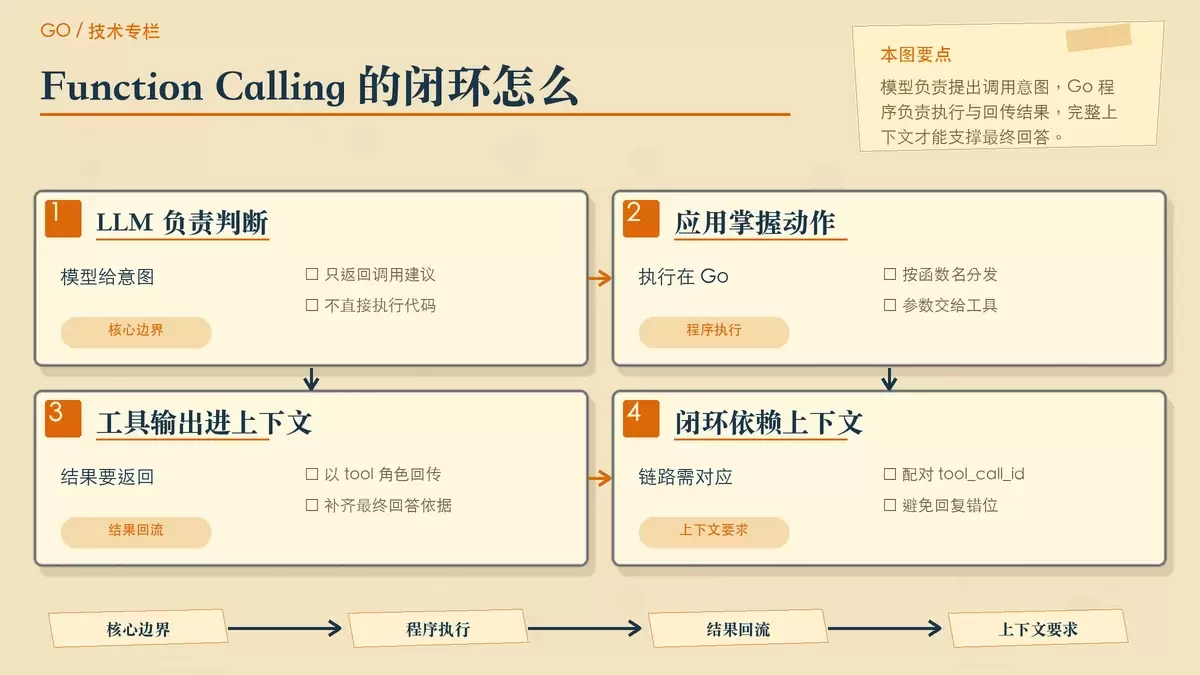
一个典型流程通常是这样的:
- 用户:现在上海天气怎么样?
- LLM:建议调用
get_weather,参数{"city": "shanghai"}。 - Go 程序:调用 API 得到结果
{"temp": 25, "desc": "晴"}。 - Go 程序:将结果以
tool角色发回给 LLM。 - LLM:现在上海天气晴朗,气温 25 度。
这里最容易被低估的,不是调用本身,而是上下文管理。你需要确保模型返回的 tool_call_id 与程序回传的执行结果能准确对应,否则模型可能拿到结果却不知道它属于哪一次调用,最终生成混乱或前后不一致的回复。
换句话说,Function Calling 不是一次性请求,而是一段多回合协议。用户消息、模型的工具调用、程序的执行结果、模型的最终回答,这几步都必须在同一条上下文链路中被完整保留。
工具一多,真正的难点是安全与并发
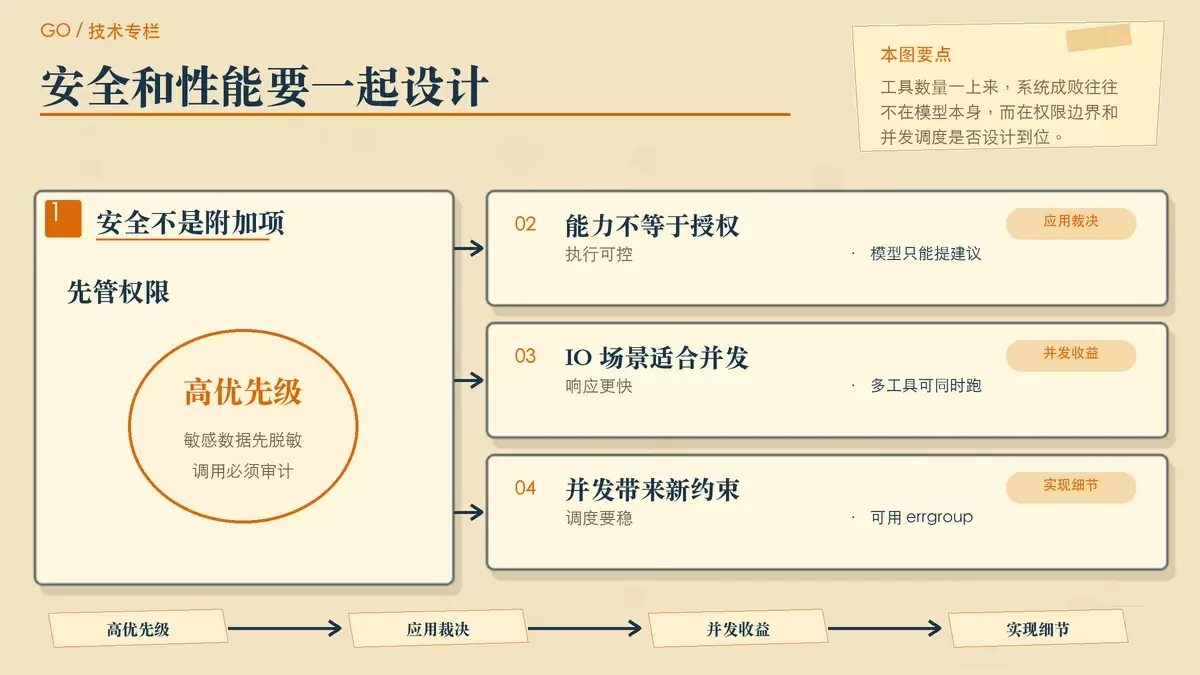
当系统里只有一两个工具时,问题还不明显;一旦工具数量上到几十个,安全约束和性能开销就会立刻成为主线问题。
权限边界必须先于能力边界
首先要坚持沙箱化思维。不要因为模型“看起来理解了需求”,就让它接触未经脱敏的敏感数据。所有函数调用都应该经过严格的权限校验、审计和访问控制,特别是数据库查询、后台操作、跨系统写入这类高风险动作。
模型可以提出调用建议,但它不应该天然拥有执行一切工具的资格。是否允许调用、能调用到什么数据、是否需要二次确认,应该由应用层规则决定。
并发执行能明显降低响应时间
另一个现实问题是时延。如果模型在一次回复里同时触发多个工具调用,串行执行会直接拉长用户等待时间,尤其是面对数据库查询、外部 API、搜索服务这类 IO 密集型任务时更明显。
// 使用 errgroup 并发处理多个工具调用
var g errgroup.Group
for _, call := range toolCalls {
    call := call // 闭包陷阱注意
    g.Go(func() error {
        res, err := registry.Invoke(call.Name, call.Args)
        // 存储结果...
        return err
    })
}
利用 Go 的 errgroup 或 sync.WaitGroup,可以比较自然地把多个工具并行跑起来。这样做对于复杂任务拆解尤其重要:模型先分解子任务,再由程序并发执行,最后汇总结果回给模型,整体体验会比串行链路顺畅得多。
当然,并发也会带来新的工程问题,比如结果汇总顺序、共享状态写入、超时控制和局部失败处理。这些都应该在分发器层提前设计,而不是等工具数量膨胀后再补漏洞。
Go 做 Function Calling,关键不在框架而在底层链路
Function Calling 的意义,不是让大模型直接接管系统,而是让它有机会把语言理解转成可靠动作。对 Go 开发者来说,真正值得掌握的核心并不神秘:定义清晰的 JSON Schema、让结构体与工具描述同步、建立中心化分发器、做好参数校验和结果回传,再用好 Go 在并发上的天然优势。
很多时候,你并不需要先追逐花哨的 AI 框架。只要底层函数调用链路足够稳,智能体就能从“会说”走向“能做”,而且是在权限可控、行为可追踪、性能可接受的前提下去做。
后续随着 Agentic Workflow 变复杂,确实还会遇到多级嵌套调用、异步长任务回调等新问题。但这些能力能否站得住,最终还是取决于最基础的这一层函数调用机制是否设计扎实。















