


Python爬虫使用代理IP防封IP实战指南

本文详解Python爬虫中如何使用代理IP防止IP被封。通过urllib.request的ProxyHandler构建自定义opener,并调用install_opener设置全局代理,使urlopen默认使用代理IP。文中涵盖HTTP/HTTPS代理设置、端口配置及常见连接拒绝错误的排查方法,帮助开发者实现稳定的数据抓取。
网络爬虫是用于自动抓取互联网信息的程序,旨在获取有价值的网络数据。在实际开发中,Python爬虫常需借助代理IP地址来规避限制。然而,Python默认的urlopen方法并不直接支持代理设置。本文将分享如何在Python爬虫中正确配置和使用代理IP。建议注册使用可靠的代理服务以获取稳定资源。
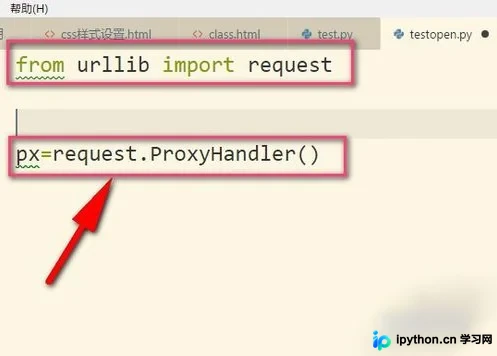
首先需明确,本教程基于Python3环境。使用时需导入urllib库中的request模块,并调用ProxyHandler类,该类用于接收和处理代理IP参数。用户可根据需求选择代理类型,虽然存在免费代理,但其可用性和稳定性通常不如付费服务。
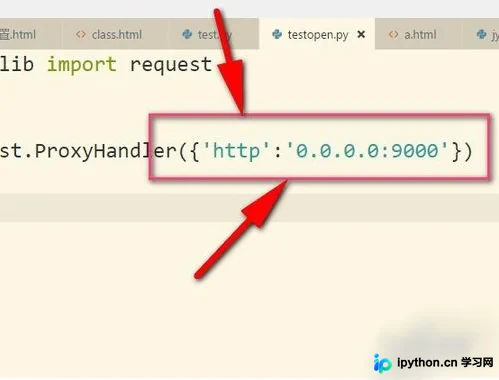
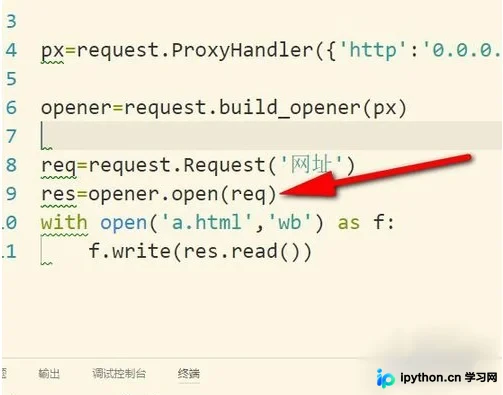
接下来,将代理IP地址以字典形式传入ProxyHandler。示例中的IP地址仅为演示用途。需设置字典的键为'http',若使用HTTPS代理则对应'https'键,值部分包含具体的IP地址及端口号(如9000)。具体端口号需根据所选代理服务的类型及服务商提供的实际端口为准。
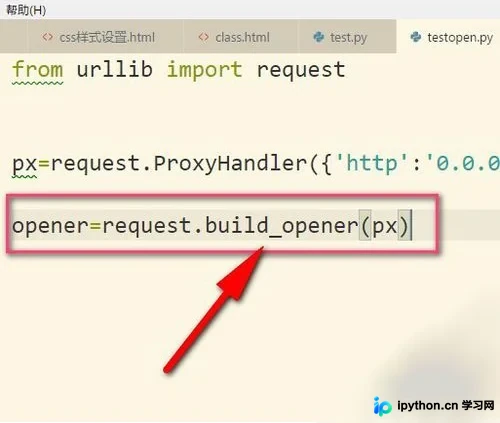
随后,使用build_opener()函数构建一个opener对象。该对象封装了代理处理逻辑,用于后续的网络请求操作。
构建完成后,调用该opener对象内部的open方法发起网络请求。本质上,默认的urlopen也是通过内部定义的opener.open()来实现请求发送,此处相当于手动重写这一过程,以实现自定义代理功能。
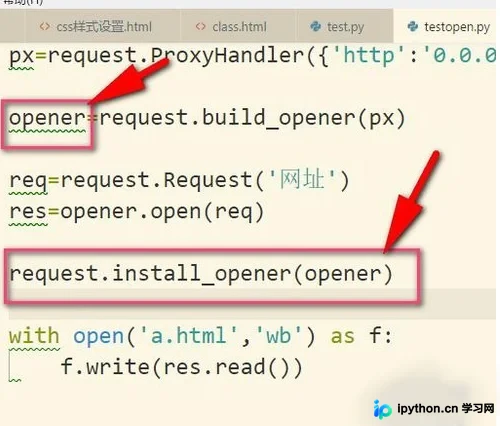
此外,若希望所有后续请求均自动使用此代理,可调用install_opener()函数。该函数将之前自定义构建的opener设置为全局默认配置。
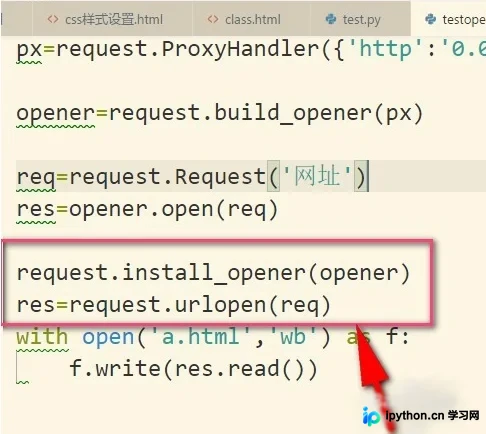
完成全局设置后,再次使用标准的urlopen方法发送请求时,系统会自动应用之前配置的代理IP,从而确保请求通过代理服务器发出,而非直接使用本机IP地址。
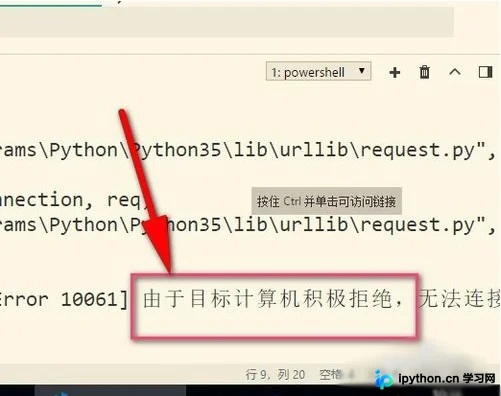
最后,讨论使用代理时可能遇到的错误。若提示“目标计算机积极拒绝”,通常意味着代理IP无效、端口配置错误或代理服务不可用。此时需更换有效的代理IP地址。示例中使用的为测试IP,实际应用中应选择稳定的代理服务以确保持续连接。
综上所述,本文介绍了Python爬虫中配置代理IP以防止IP被封的技术细节。通过合理配置ProxyHandler和全局opener,可有效提升爬虫的稳定性和隐蔽性。感谢阅读与支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















