



在 C++ 多线程代码里,真正棘手的往往不是立刻崩溃的错误,而是偶发性的“状态已更新、结果却还是旧的”。这类问题通常和内存屏障、原子操作的发布-消费关系有关,单靠日志、单次调试值甚至 TSAN 静默都不足以说明代码正确。下面按几种最常见误区拆开看,顺带给出更稳妥的判断和写法。
内存屏障放错位置,为什么等于没同步
这类 Bug 最常见的表现,是开发者已经意识到需要屏障,于是补了 std::atomic_thread_fence,但放置位置错了,结果同步关系根本没有建立。
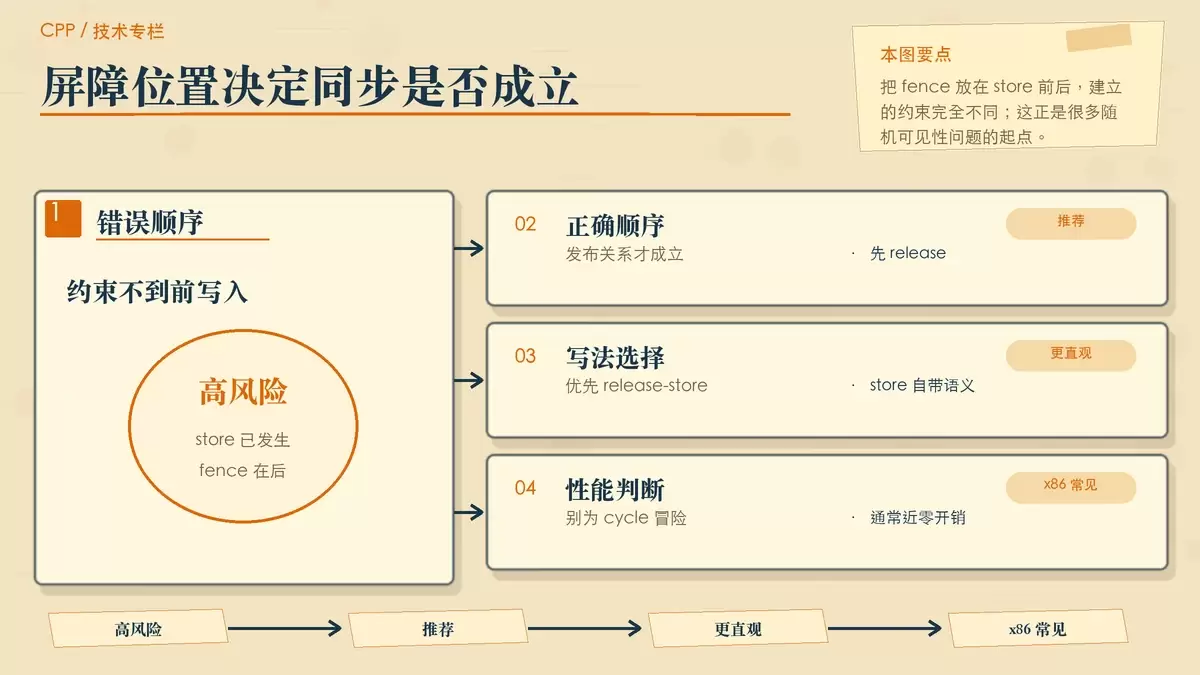
典型错误是把 release fence 写在 store 之后:
ready.store(true, std::memory_order_relaxed);
std::atomic_thread_fence(std::memory_order_release); // 没用!
问题在于,屏障只能约束它之后的指令不要被重排到它之前,无法反过来替前面的 store 补语义。所以这段代码看起来“加了 fence”,实际上对前面的写入没有形成你想要的发布效果。
如果要用 fence,正确关系应该是先 release,再写标志位;读端则先 acquire,再读标志位:
std::atomic_thread_fence(std::memory_order_release);
ready.store(true, std::memory_order_relaxed);
// 对应读端:
std::atomic_thread_fence(std::memory_order_acquire);
bool r = ready.load(std::memory_order_relaxed);
不过在多数场景里,更推荐直接把语义写进原子操作本身,而不是手工拼 fence 加 relaxed。比如:
ready.store(true, std::memory_order_release);
这样表达更直接,也更不容易在维护时被人改坏。对应读取端再配上 std::memory_order_acquire,同步关系才完整。
还有一个容易被忽略的现实问题是,很多人为了“省一点开销”选择自己写 fence。但在 x86 上,std::memory_order_release 通常几乎没有额外成本,收益远不如可读性和正确性重要。为了几个 cycle 把同步写复杂,通常不值得。
TSAN 不报错,为什么仍可能读到旧数据
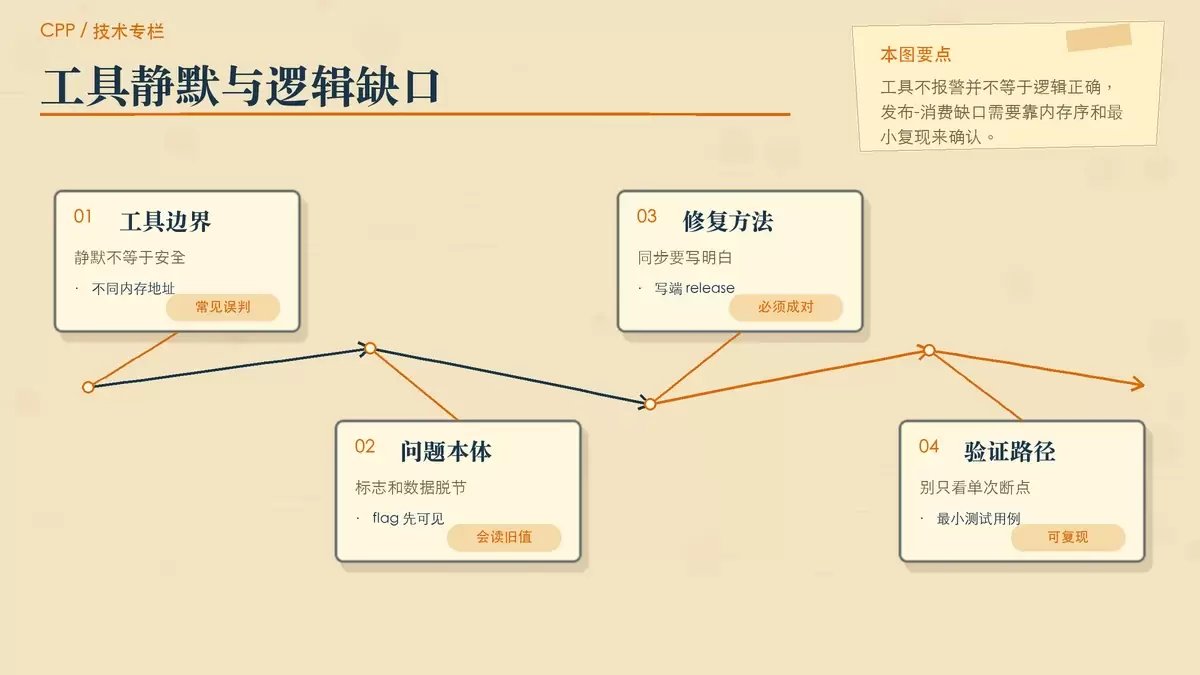
另一类高频误判来自工具。很多人跑过 -fsanitize=thread,看到 TSAN 没报警,就默认并发逻辑没有问题。但只要错误属于“发布-消费关系缺失”,TSAN 很可能完全静默。
例如下面这段代码:
// 写端
data.x = 1; data.y = 2; // 非原子 struct
ready.store(true, std::memory_order_relaxed); // ❌ 缺少 release 语义
// 读端
if (ready.load(std::memory_order_relaxed)) { // ❌ 缺少 acquire 语义
use(data.x, data.y); // 可能读到 x=1 y=0 或 x=0 y=2
}
从业务角度看,你的意图很明确:先把 data 写好,再通过 ready 告诉另一个线程“可以读了”。但从 TSAN 的视角看,data 和 ready 是不同地址,它主要检查的是是否存在原始内存层面的 data race,并不会替你推断“这个标志位应该发布这块数据”。
这就是为什么它可能不报错,但程序仍然会出现:
- 标志位已经变成 true,读取到的数据还是旧值
- 结构体里的字段只更新了一部分,出现组合状态不一致
- 调试时偶尔复现,正常日志里却长期看不出来
解决方式并不神秘,关键是把同步意图显式写出来:写端使用 std::memory_order_release,读端使用 std::memory_order_acquire;或者在确有必要时,用一对位置正确的 std::atomic_thread_fence 建立约束。
这里要记住一个原则:编译器和 CPU 不理解“这个 flag 是给 data 打信号”的业务含义,它们只认你在代码里声明出来的内存序。
全用 seq_cst,也不能替代正确的同步设计
不少人把 std::memory_order_seq_cst 当成“最强保险”,觉得只要统一改成最严格顺序,所有并发可见性问题就能消失。实际并非如此。
看下面这段:
// 线程 A
a.store(1, std::memory_order_seq_cst);
b.store(2, std::memory_order_seq_cst);
// 线程 B
int rb = b.load(std::memory_order_seq_cst);
int ra = a.load(std::memory_order_seq_cst);
这段代码能保证 a 和 b 这两个原子变量各自参与全局顺序,但如果你的业务要求是“只要看见 b 已有效,就必须同时看见 a 已更新”,那它仍然不够。线程 B 关注的是一个组合条件,而不是两个互不相关的单点可见性。
换句话说,seq_cst 强的是单个原子操作的顺序语义,不会自动把你分散在多个变量上的业务不变量打包成一个事务。于是 B 仍可能看到一种你不想接受的组合,例如先观察到 b=2,却没拿到与之配套的 a 新值。
如果业务语义是“b 有效当且仅当 a 已更新”,更稳妥的办法通常有两类:
- 把相关状态封装成一个整体,例如放进同一个
struct,再考虑用std::atomic<T>或其他单元化同步方式发布 - 把一个变量明确设计成发布信号,用
release-store与acquire-load成对建立因果关系
此外,std::memory_order_seq_cst 也不是免费午餐。它在 ARM/AArch64 上开销更明显;即便在 x86 上相对便宜,也不意味着可以无差别铺满所有原子操作。内存序选型首先应该服务于语义正确,而不是追求“最强”两个字。
调试时该怎么判断,才不会被假象带偏
这类问题之所以难查,还因为很多日常调试手段会制造错觉。比如在 gdb 里看到一次 ready.load() 返回 false,并不能证明另一个线程真的没写;也可能是写入已经发生,但当前线程尚未以你预期的方式观察到相关缓存行变化。
同样,日志有时会让 Bug “自己消失”。原因并不玄学,而是额外输出、函数调用或调试辅助代码可能改变时序,甚至间接插入屏障,让原本脆弱的竞态窗口缩小了。
因此,更可靠的排查方法仍然是构造可复现的最小测试用例,再结合工具和调度扰动去验证。例如原文提到的组合就很实用:
- 用
-fsanitize=thread排查真正的 data race - 配合
std::this_thread::yield()人为打乱调度 - 缩小代码规模,只保留关键共享数据、标志位和读写路径
要点是分清两件事:TSAN 能帮助你发现地址层面的竞争,但无法替你证明发布-消费逻辑成立;单次断点观察能提供线索,却不能代替同步语义分析。
归根结底,这类“变量已写但读不到”的随机 Bug,通常不是 CPU 神秘失常,而是代码没有把线程间因果关系写完整。先确认是否真的需要跨线程发布数据,再优先选择 release/acquire 这样可读、成对、语义明确的写法,比事后靠日志、断点和全局 seq_cst 去补救更可靠。















